L11 The Memory Hierarchy
RAM 通常来说最小的存储单元被称作cell(单元),一个单元存储1个bit、
RAM有大致两种分类 SRAM和DRAM
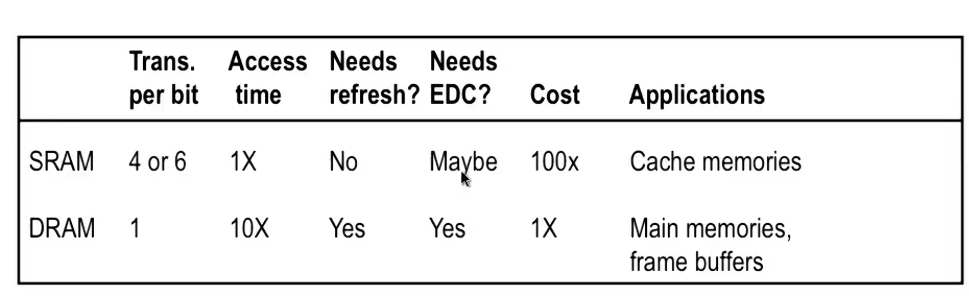
SRAM比DRAM更小 速度更快,通常叫做高速缓存
DRAM和SRAM都是易失的,如果断电将丢失所有数据。
非易失的存储器通用名称是ROM(只读存储器)在固件中有广泛使用,比如主板的BIOS,boot引导程序
CPU和内存是靠一些电子线路链接在一起的,这被称作为主线(Bus)
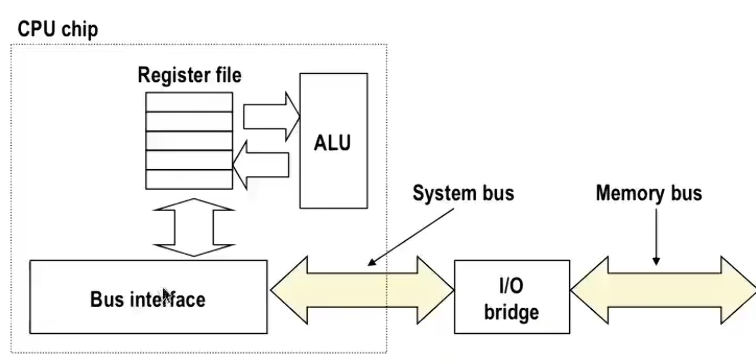
上面这张图讲述了数据如何在CPU和内存之间流动
假设现在CPU执行了一条指令 movq (addr), %rax 这个过程我们称之为加载(load)是从CPU的角度出发的
寄存器和ALU离得非常近,相较于内存的读写(需要经过总线传输数据)是非常高效的,对于内存的读写都需要50-100ns 但是对于寄存器的读写就只要1ns左右
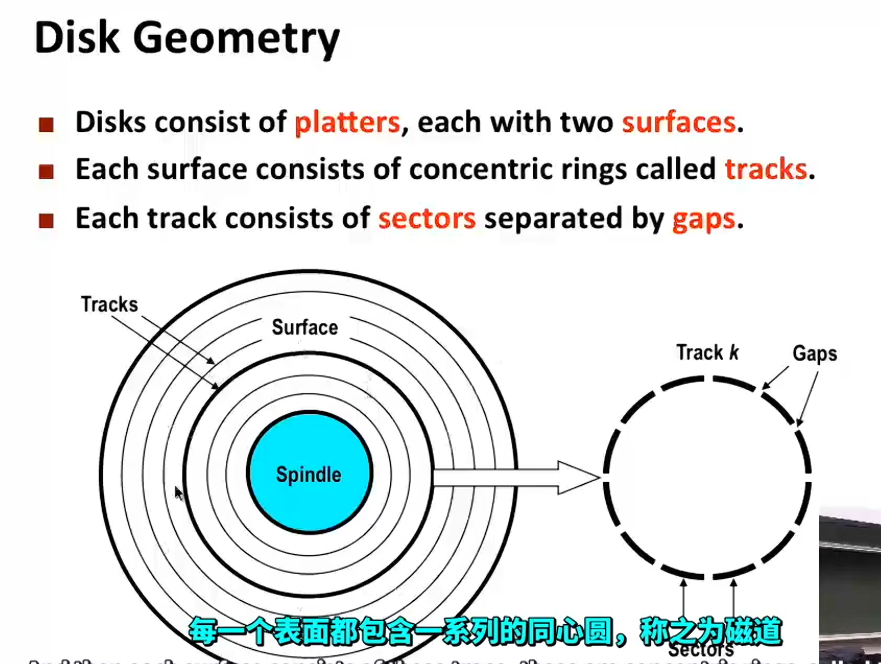
对于传统的机械硬盘,每个盘片有两面,每个面都含一系列的同心圆被称作磁道
每个磁道都包含很多个扇区,扇区存储着数据(经典的,一个扇区的大小是512Bytes)扇区之间有一些物理的空隙,不存储数据
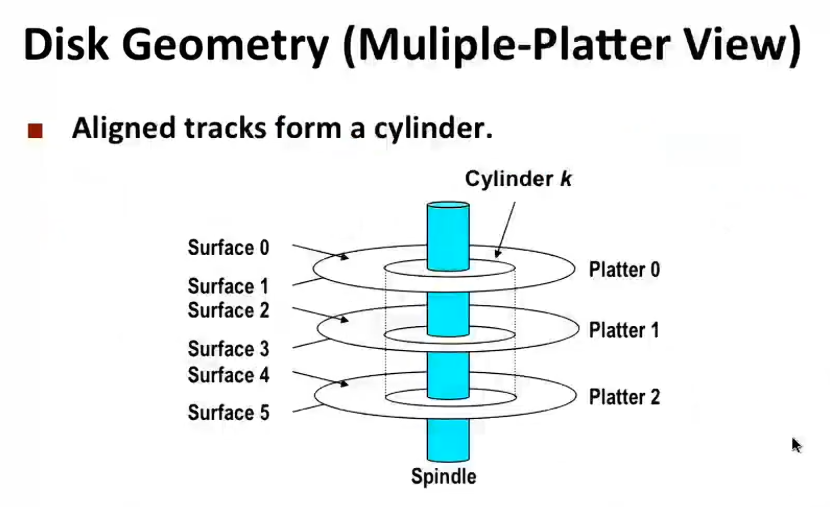
盘片在主轴上是相互对齐的,不同盘片上的轨道也是相互对齐的,这些相互对齐的轨道形成的一个柱体,我们叫他柱面(cylinder)
磁盘能存储的信息量由这些因素决定:1. 单位扇区的信息密度2. 磁道密度 两者共同决定了面密度
现代系统中,为了避免磁盘物理磁面上的空间浪费,将磁道划分为记录区(Recording Zones)每个记录区里面的每一条磁道所包含的扇区数量相等
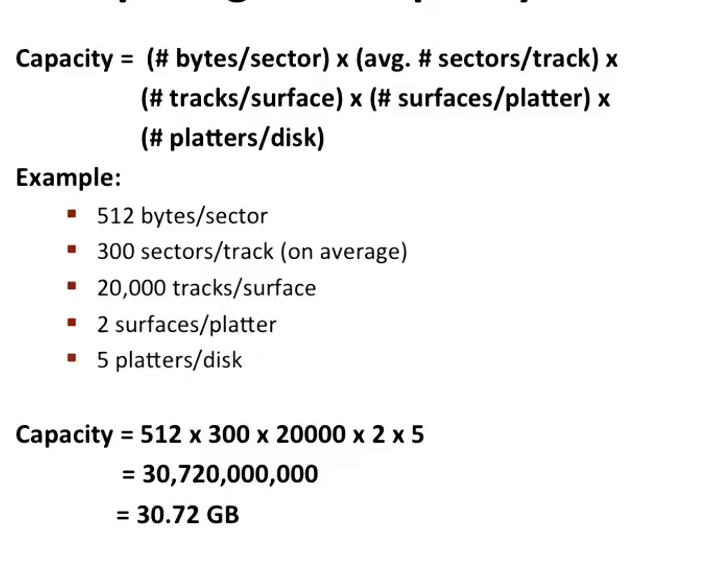
这是磁盘的大小计算公式
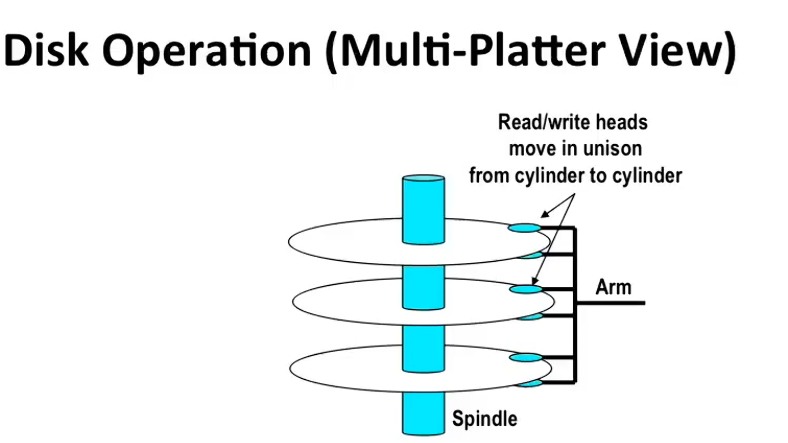
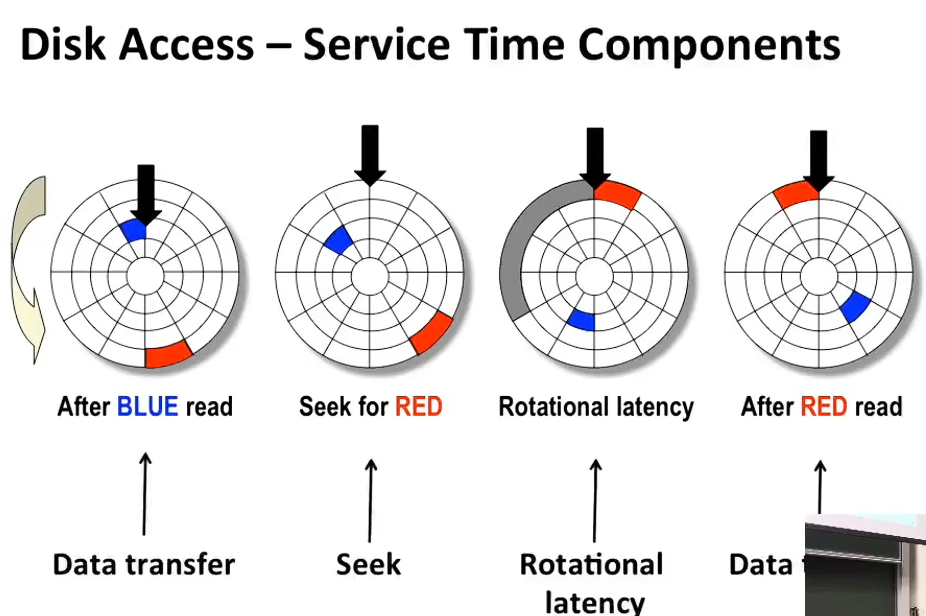
这个seek被称作为寻道时间,就是寻找下一个需要被读写的块的时间。
找到了需要被读写的块,机械磁盘旋转需要一段时间,被称作旋转延迟。
以及数据传输时间,是读完目标数据块需要花费的时间。
总的传输时间是这三者的平均总和:
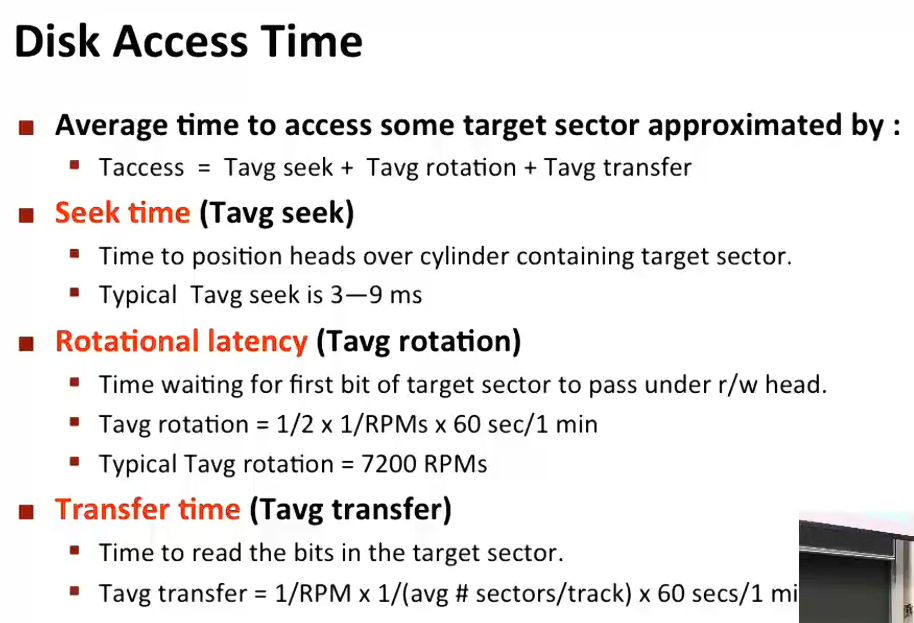
使用SRAM访问一个doubleworld需要的时间大概是4ns,而DRAM需要60ns
但是磁盘比SRAM满了4000倍,或者说比DRAM慢了2500倍。
现代磁盘通常将一系列扇区作为逻辑块,并将其进行编号的传给CPU。其中一些柱面是为了故障而保留的
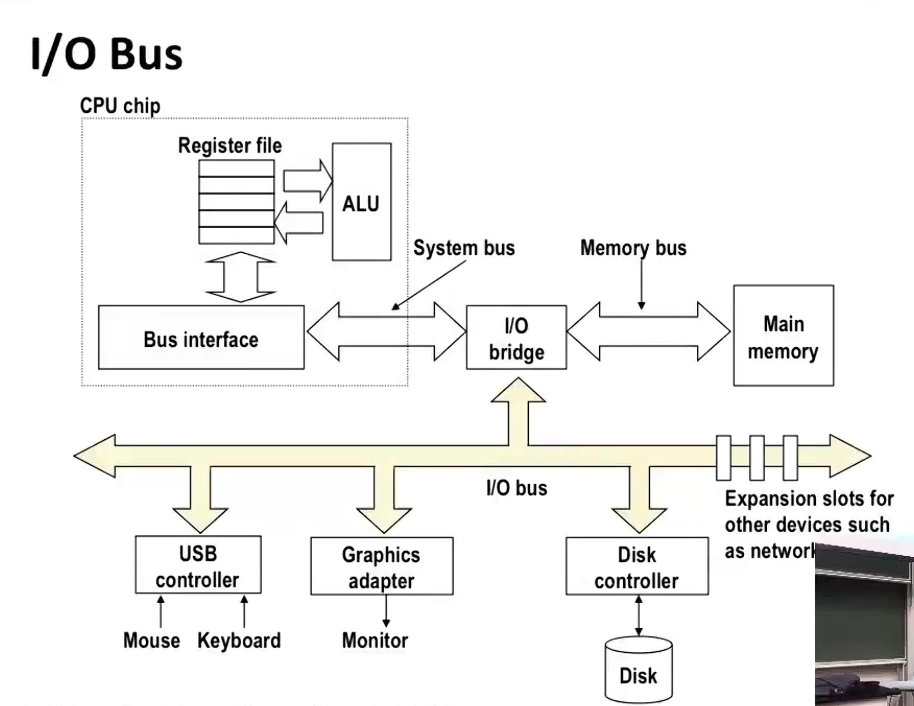
磁盘这样的设备要想连接到CPU和内存,出了经过I/O桥,还需要通过I/O总线
现在的总线叫做PCI Express,这将允许所有设备连接到CPU
当我们想读取扇区中的数据时,CPU会写一个三个元素的元组:首先是指令,比如read,以及一个逻辑块号,以及对应存储的内存地址。随后DMA控制器会直接控制IO总线,把数据传输到主存储器,而无需通知CPU,这就是DMA(direct memory access)。在数据传输完成之后DMA控制器向CPU发送一个中断信号(告诉CPU这个逻辑块已经写完),去处理刚才读取到的内存数据。
这样做的原因是因为:相对于CPU,硬盘读取的10ms是一个非常漫长的过程,而这套机制可以不浪费CPU的时间
现在广泛使用的SSD中主要是用闪存(Flash Memory),但是闪存并不会直接与IO总线连接,在此中间有一个闪存翻译层,负责两层之间的交互。
在SSD中最小的计量单位是pages,这也是SSD在读写的时候的最小单位,每个page从512KB到4KB不等。再往上是block(这里和CPU认为的逻辑块不是一个东西),每个block由32到128页组成。
一个page在写入的时候,只有在所属的整个块都被擦除之后,才能写这一页。也就是说,如果我想向SSD中写入数据,必须要找一个正在被擦除的块,必须要找目标块中断所有其他页面复制到该新块,才能正确执行。
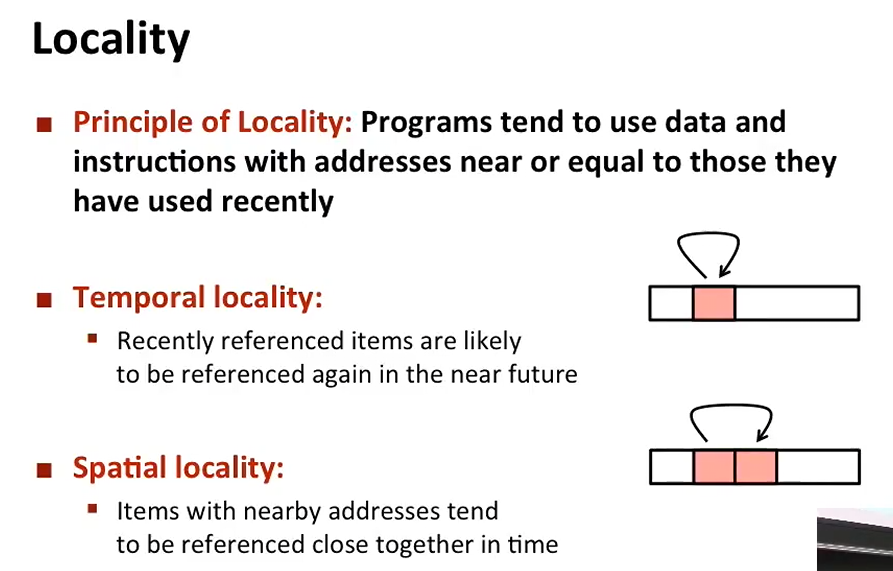
程序的局部性,可以弥合CPU和内存之间的差距:程序倾向于使用那些地址与最近使用过的地址相近(near)或相同(equal)的数据和指令。
局部性有两种表现形式:
- 临时局部性:最近访问的数据元素有很大的可能在未来被在此引用
- 空间局部性:这是一种引用临近存储器位置的倾向
这里进行例举:
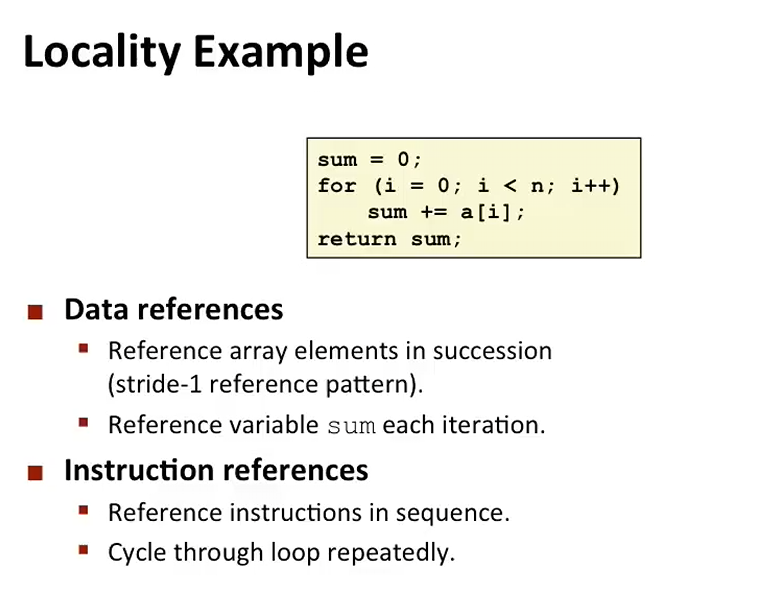
这里有两种引用类型:数据引用和指令引用
数据引用:
-
在C语言中,数组在内存里是连续存放的。当你读取
a[0] 时,CPU的缓存机制(Cache Line,通常64字节)会顺便把 a[1] 到 a[15](假设是4字节的int)一起从内存拉到高速缓存(L1 Cache)里。等下一次循环访问 a[1] 时,直接命中缓存,速度极快。这就叫“步长为1的引用模式”(stride-1),完美体现了空间局部性。 -
sum 在每一次循环里都要被读取、相加、再写回。因为它在短时间内被反复访问,编译器会直接把它优化到CPU寄存器(比如 %rax 或 %xmm0)中。寄存器是CPU内部最快的存储,完全不用去碰慢速的内存。这就完美体现了时间局部性(刚刚用过的数据,马上还会用)。
指令引用:
1. Reference instructions in sequence. (顺序引用指令)
- 对应底层:当这段C代码编译成汇编后,指令是一条接一条存放在内存里的(比如
add、cmp、jmp指令)。 - 背后的原理(空间局部性) :CPU的程序计数器(PC)通常是按顺序往下取指令的。由于指令在内存中是连续的,一条被取走后,下一条大概率还在同一个缓存行里,取指速度极快。
2. Cycle through loop repeatedly. (反复循环执行指令)
- 对应代码:整个
for循环体。 - 背后的原理(时间局部性) :循环体里面的那几十条汇编指令,在
n 次循环中会被反复执行。因此,这些指令会一直驻留在指令缓存(I-Cache) 中,甚至会被CPU的分支预测器和指令预取器提前准备好。 - 结合你之前学的流水线(Pipeline) 和Haswell CPU:正是因为指令有极强的时间局部性,前端才能源源不断地把指令塞进那8个功能单元,让乱序执行引擎持续运转。
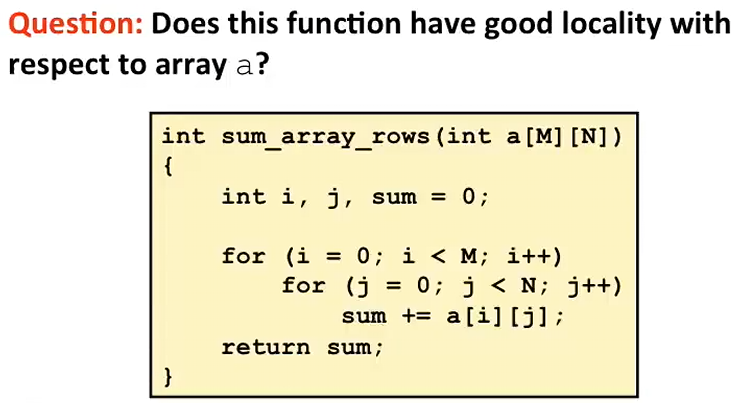
在这个例子中,因为数组实际上是按照行来取值的,所以会有良好的空间连续性,代码在一块就有比较好的指令局部性。
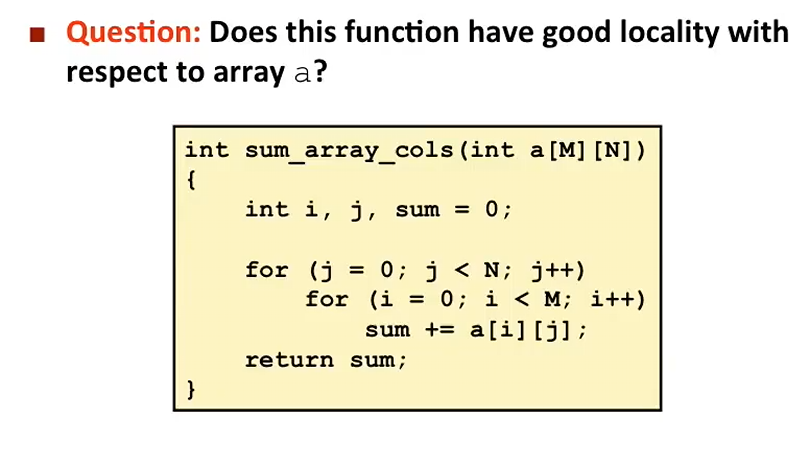
但是在这个例子中,由于数组进行了按列遍历,破坏了原本的空间连续性(这些东西就不在CPU缓存里面了)
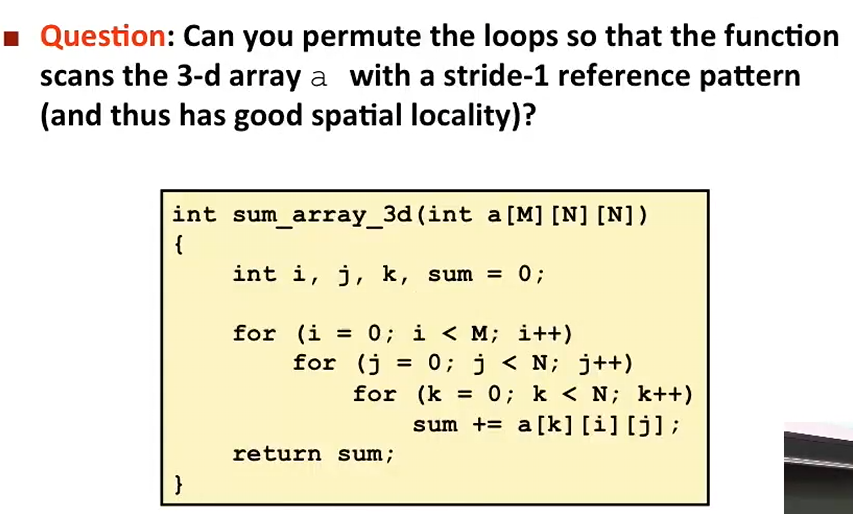
同样的,在这里的三维数组遍历,下标的顺序导致了当前代码的内存访问跨度非常大,所以需要调整访问顺序,提升空间内连续性:
for (k = 0; k < N; k++)         // k 放到最外层
    for (i = 0; i < M; i++)     // i 在中间
        for (j = 0; j < N; j++) // j 放到最内层
            sum += a[k][i][j];
由于上述的这些特性,我们在设计存储器的时候使用了 存储器结构层:
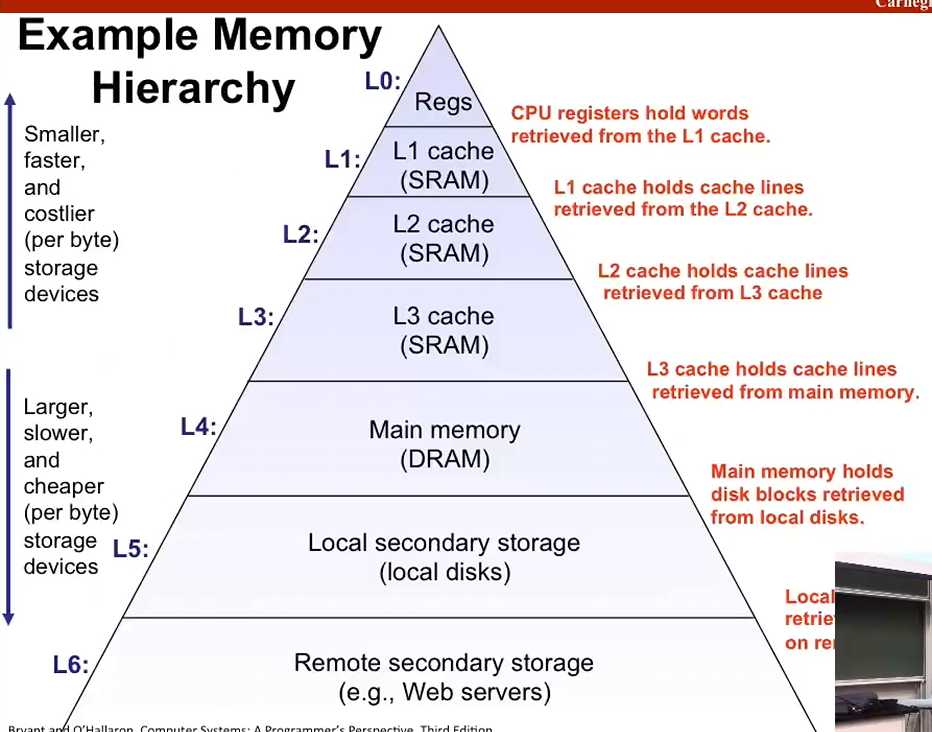
越小越快越贵、越大越慢越便宜
存储器层次结构中的每一层都包含了从下一个较低级别层次所检索的数据:上层存储器(比如L1)里的数据,都是从下层存储器(比如L2)里“复制”上来的。下层存储器保留着全部数据,上层存储器只保留下一层数据的一个“子集(副本)”。
1. 数据是如何“层层检索”的?
想象你要去图书馆找一本书(数据):
- 你先看自己桌面(L0 寄存器) ,没有。
- 去书包(L1 Cache) 里找,还是没有。
- 去书架(L2 Cache) 找,找到了!于是你把这本书拿到了书包里(L1) ,再放到桌面上(L0) 。
- 在这个过程中,书包(L1)里的这本书,正是你从书架(L2)“检索(retrieved)”出来并复制过来的。
在计算机中,数据是按块(Cache Line,缓存行) 一层层往上拷的。
- 当CPU要读一个数据,L1没命中,它就会向L2要。
- L2把这行数据复制一份给L1(L2自己还留着),L1再给CPU。
- 这就叫“L1包含了从L2检索的数据”。
2. 包含关系(Inclusion Property)
这句话背后隐含了一个极其重要的物理事实:L1 ⊆ L2 ⊆ L3 ⊆ L4(主存) ⊆ L5(硬盘) ⊆ L6(远程) 。
- 如果你在L1里找到了数据,那么它在L2、L3和内存里必定也存在(因为L1只是它们的一个小副本)。
- 如果L1里没有,那就去L2找;如果L2没有,去L3找……以此类推,直到去最慢的远程服务器或者硬盘里找。
- 找到后,数据就会被逐级向上复制。
3. 为什么必须设计成这样?(结合你问过的“为什么不全面用Cache”)
结合你上一个问题,如果“每层都包含下一层的数据”,为什么不干脆把所有数据都放在L0(寄存器)或者L1里?
答案就是成本和物理限制。
- L1(最上面)很小、极快、极贵(SRAM)。
- L4/主存(下面)很大、较慢、便宜(DRAM)。
- 我们不可能让一个小小的书包(L1)装下整个图书馆(硬盘)的书。
因此,这个“包含并层层检索”的机制,配合你之前学过的 “局部性原理(Locality)” ,完美运转了起来:
- 因为我们经常用最近用过的数据(时间局部性)和相邻的数据(空间局部性)。
- 所以当我们第一次去底层的L4(主存)甚至L5(硬盘)把数据捞上来后,就把它复制到上层(L3 -> L2 -> L1)。
- 下一次CPU再用它,直接在L1就能拿到,避免了去底层慢吞吞地找。
总结
幻灯片底部这句话,就是在告诉你:缓存不是一个独立的存储仓库,而是一个“不断从下级存储中提取数据副本并向上层复制的流式管道” 。越往金字塔尖,数据越“热”(被频繁使用),越靠近CPU;越往塔底,数据越“冷”,但容量越大,管得越宽。
cache没有的,先从内存搞到cache(缓存命中)。cache里面有的,就直接请求(缓存命中)
缓存未命中又有三个分类:
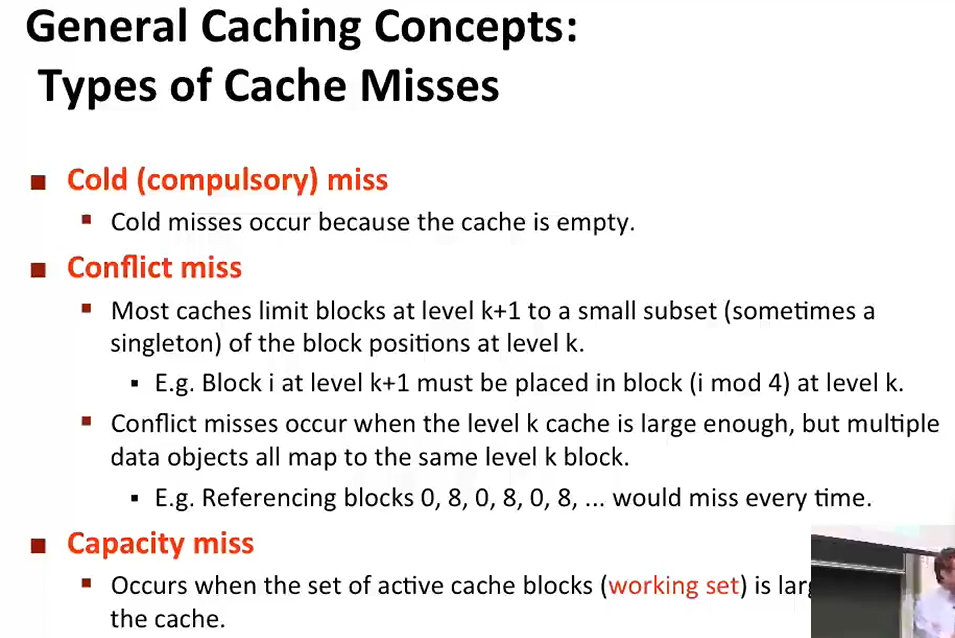
1. 强制性未命中(Cold / Compulsory Miss)
- 幻灯片定义:缓存是空的,所以未命中(Cold misses occur because the cache is empty)。
- 通俗比喻:你第一天去图书馆(新程序启动),书架上什么都没有,你借任何书(数据)都必然找不到。
- 本质:这是不可避免的。任何数据在第一次被访问时,都必须从底层存储(主存/硬盘)加载上来。
- 结合局部性:即使你的代码拥有完美的空间/时间局部性,第一次访问某个数据块时,依然会发生冷启动缺失。硬件预取器(Prefetcher) 可以在一定程度上缓解这个问题(在你真正用到之前,提前偷运到缓存里)。
2. 冲突未命中(Conflict Miss)
- 幻灯片定义:大多数缓存限制了第 k+1 层的块只能放置在第 k 层的一个很小的子集(有时是一个单例)中。例如:第 k+1 层的块 i 必须放在第 k 层的块
(i mod 4)的位置。 - 通俗比喻:图书馆的书架只有4层(0, 1, 2, 3号位)。规定“所有的书都必须按照书名的首字母取模4来决定放哪层”。假如你现在要同时看《C语言》、《C++》、《C#》和《CSS》,它们的首字母都是C,算出来都在第0层。但第0层只能放一本,于是你只能把前面的书扔出去,换上新的。下次你再看前一本书,它又被扔出去了,又要重新去仓库拿。
- 幻灯片里的例子:
Referencing blocks 0, 8, 0, 8, ... would miss every time. 假如缓存只能放4个块(0, 1, 2, 3),你交替访问块0和块8。因为 0 mod 4 = 0,8 mod 4 = 0,它们都会争抢缓存里的同一个位置(0号位)。即使缓存里其他三个位置(1, 2, 3)全空着,它们也用不了。 - 本质:这是因为缓存映射策略(如直接映射、组相联) 引起的。如果缓存是全相联(随便哪里都能放),就不会有冲突未命中,但硬件电路会因为要同时比较所有块而变得极其昂贵且缓慢。冲突未命中是硬件成本妥协的产物。
3. 容量未命中(Capacity Miss)
- 幻灯片定义:当活跃缓存块的集合(working set,工作集)大于缓存本身时发生(Occurs when the set of active cache blocks is larger than the cache)。
- 通俗比喻:图书馆只有100个书架,但你这学期上课需要同时参考120本不同的书。无论你多聪明(映射策略多完美),书架就是不够用。你只能把之前用过的书扔出去,等下次用到再去仓库(内存)拿。
- 本质:这是物理大小限制引起的。完全不用考虑映射策略,就是单纯的“装不下”。
- 结合你之前问的“为什么不全用Cache” :这就是那个终极瓶颈的体现。为了减少容量未命中,你需要更大的缓存(L3变成128MB),但这会带来巨大的芯片面积和功耗成本。
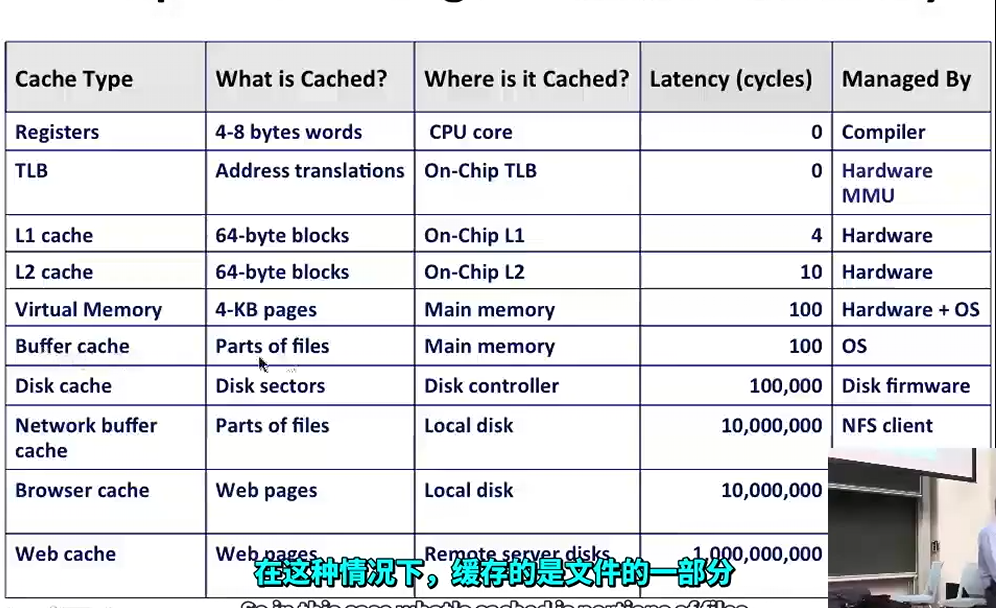
1. 为什么需要 TLB?(TLB存在的根本原因)
现代操作系统使用的是虚拟内存(Virtual Memory) 。你的程序(包括C语言代码)里面所有的指针、变量地址,都是虚拟地址(Virtual Address) 。
但是,真正的硬件内存条(DRAM)只认识物理地址(Physical Address) 。
所以,CPU在每次读写数据前,必须先把虚拟地址翻译成物理地址。
这个翻译过程需要查页表(Page Table) 。页表存放在主存(DRAM)中。如果每次访问数据,都要先去主存查一次页表,那就相当于每次内存访问变成了两次。本来内存延迟(DRAM Latency)就有100个周期,再翻倍到200个周期,这是无法忍受的。
TLB 就是为了解决这个问题的。 它本质上是页表的缓存,存储了最近使用的虚拟地址到物理地址的映射关系。