L16 System-Level IO
Unix系统中,一个文件,本质上就是一个由m字节组成的线性序列
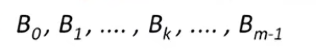
操作系统实际上不了解文件内部的详细结构
在Unix系统中,“一切皆文件”。系统将外部设备(例如磁盘,USB设备,终端等)抽象成了文件的形式:
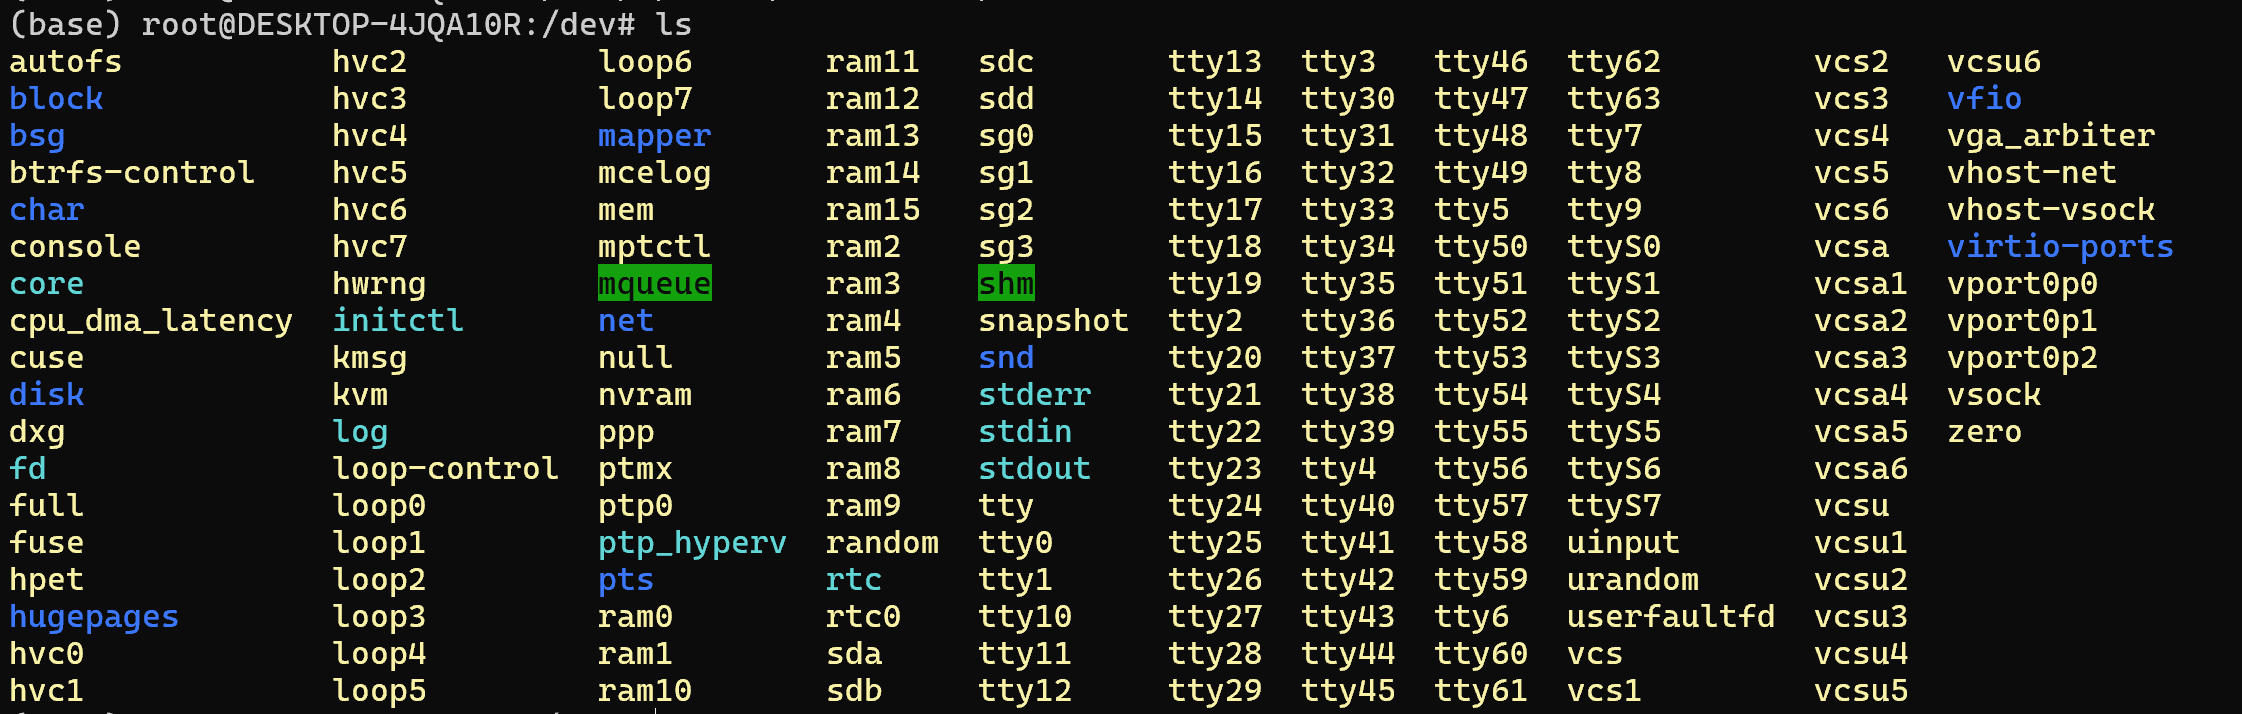
可以对这些文件进行操作,也就是对设备进行操作。所有的IO操作都是open -> read/write -> close,同时适用于硬件和文件
甚至连内核都是以文件的形式表现的:
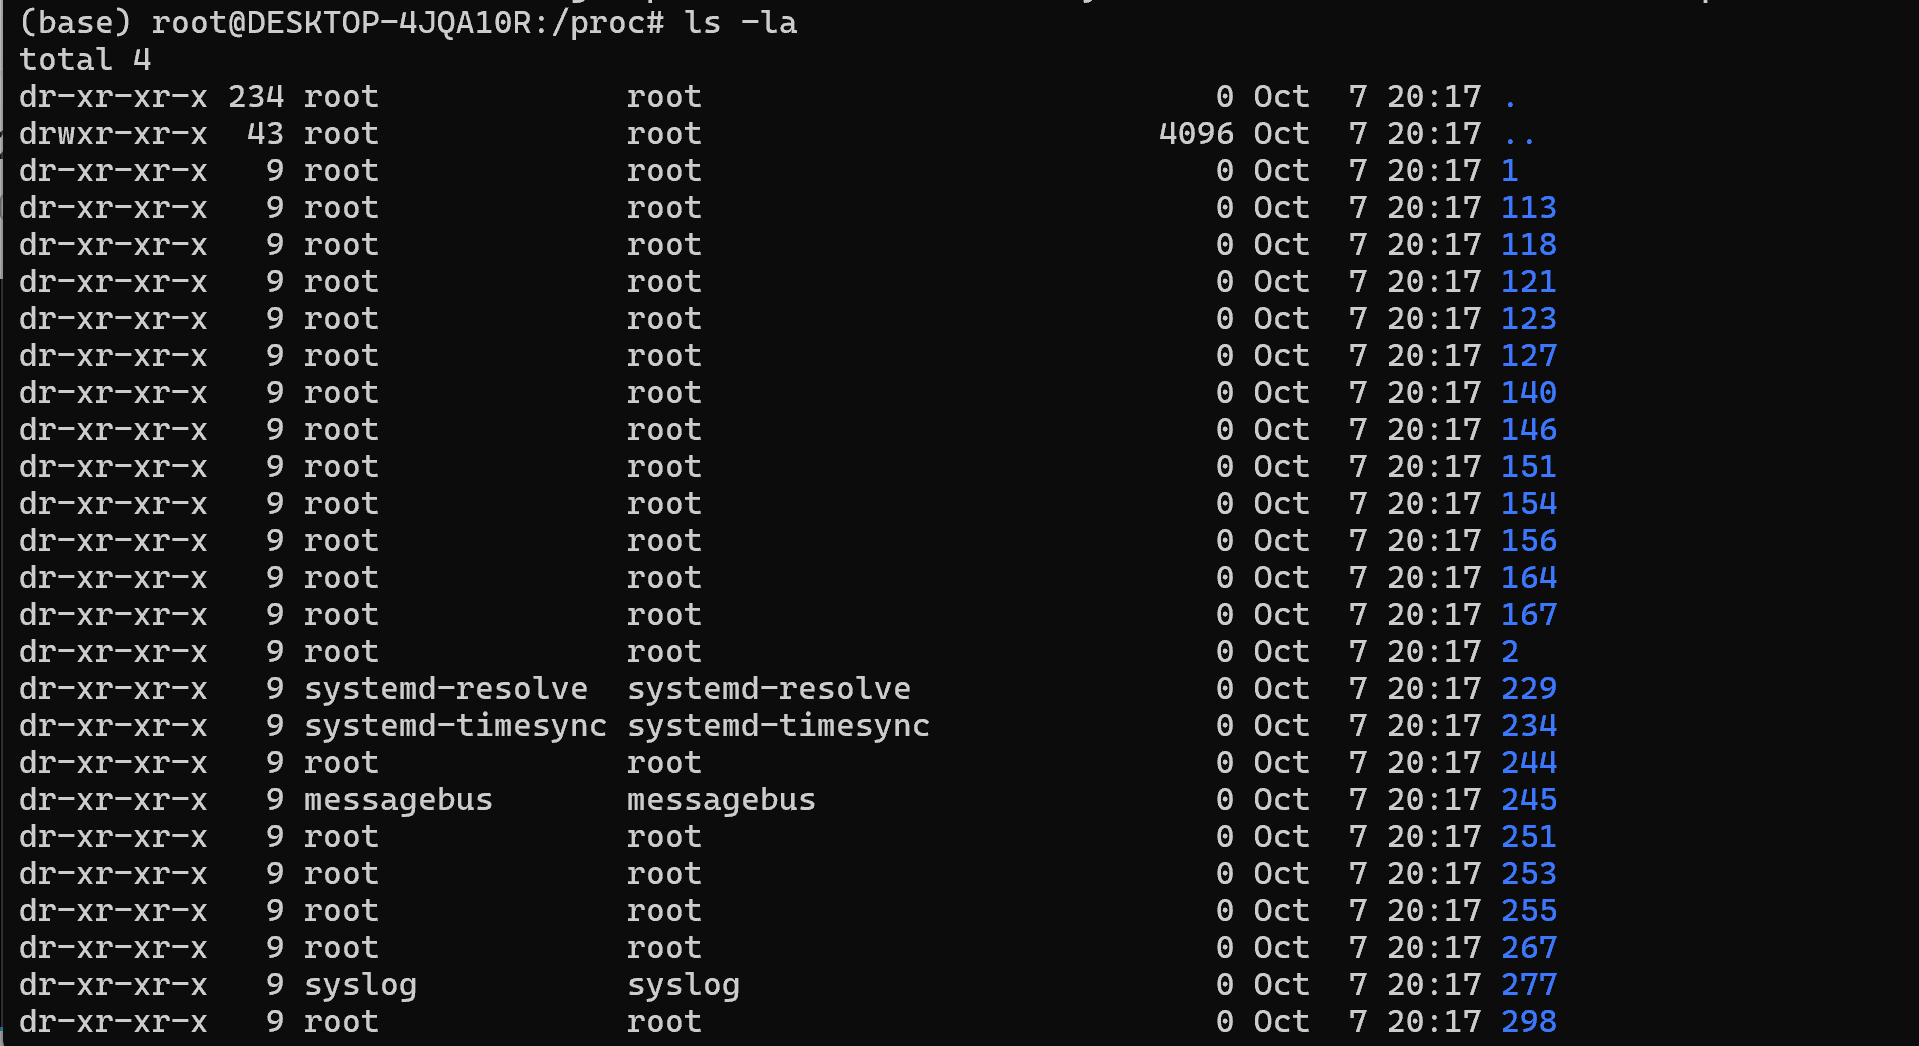
对于文件,使用open()进行打开,close()进行关闭;使用read()进行读取,write()进行写入。常规情况下,系统会从头一个一个字节读取,内核会维护一个“文件偏移量”(offset)用来记录当前读到了哪里。当然,也可以使用随机访问(lseek) 直接跳到第k个字节
文件也有不同的类型,分为以下三类:
- 常规文件:包含任意数据
- 目录:对于一些列相关文件的索引
- 套接字(socket):网络连接
但是本次不讨论以下类型的文件:
- 管道:用于进程之间的联系
- 符号链接:也称作软链接
- 特殊设备
对于常规文件来说,操作系统不关心文件具体的内部细节。某些程序会区分文本文件和二进制文件,两者的区别在于:文本文件只包含标准的ASCII字符或者其他Unicode等,二进制文件是图像或实际目标代码等其他文件。
文本文件有一些特征:包含一些标识符,比如用\n 表示换行。这可以被一些函数捕捉到。值得注意的是,在Windows系统和Unix类系统中,对于文本行结尾的处理是不一样的*(CRLF)
目录作为一种文件,操作系统会对其进行特殊处理。目录会包含一系列的链接,每一个链接都对应了一个文件的文件名。
每一个目录一定会包含这两个文件:
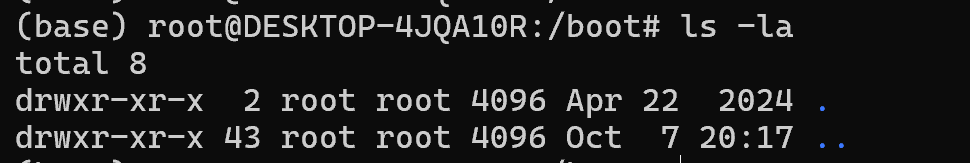
其中 .是指向该目录自身的链接,..则表示指向上一层目录。我们通常用mkdir来创建文件夹,ls来展示文件夹内的文件,rmdir来删除空文件夹
在unix中,文件存在体系结构,从根目录 / 为节点进行展开:
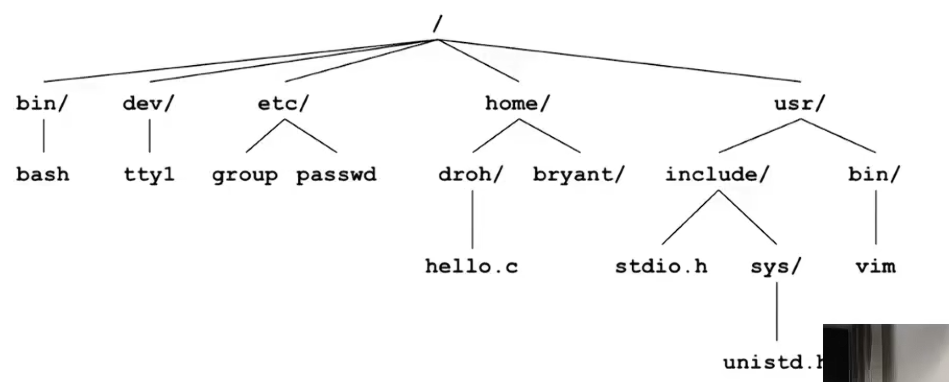
对于文件的操作,其本质也是syscall。在Linux中,我们不能直接读写文件,我们需要向内核申请一个“文件描述符” File Descriptor 简称fd
int fd;  // 准备接收文件描述符

if ((fd = open("/etc/hosts", O_RDONLY)) < 0) {
    perror("open");
    exit(1);
}
当open()被调用时,内核会做三件事:
-
权限检查
-
查找文件,在文件系统中找到这个文件的inode,也就是索引节点
-
建立连接,在内核的“打开文件表”里创建一个条目,记录下这个文件、你的访问模式(只读、只写、读写)、以及当前的读写位置(偏移量)
在上面这个示例程序中,使用变量fd来接受文件描述符,对于open(),我们使用了两个参数,其中第一个为文件位置,第二个为访问模式标志(O_RDONLY 只读,O_WRONLY 只写,O_RDWR 读写,还有 O_CREAT 创建、O_APPEND 追加等)
当open成功之后,内核返回的fd是内核维护的文件描述符表(本质是个数组),而这个fd就是这个数组对应的下表。这个数组的元素是指向内核“打开文件表”的指针。有一些fd的编号是定死了的:
- 0:标准输入(stdin)
- 1:标准输出(stdout)
- 2:标准错误(stderr)
- 从 3 开始,才是
open出来的新文件。
有了fd之后,以后读写文件,不再用文件名,而是用这个 fd。比如 read(fd, buf, size)、write(fd, buf, size)、close(fd)。内核通过 fd 就能快速找到对应的文件。
需要关闭文件时,只需要close(fd)即可
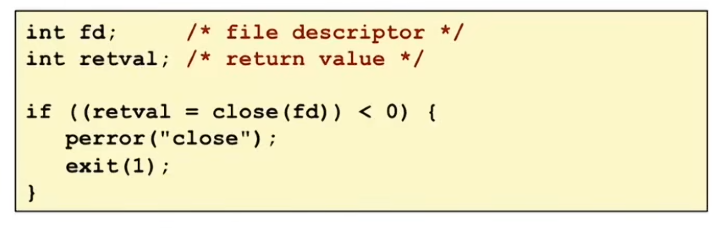
同样,对于文件读取,也需要fd

read()的本质同样是syscall,告诉内核三个要素:
- fd,需要读取的文件是哪个
- buf,读出来的数据放到哪里
- sizeof(buf),我最对哦能接收多少字节
对于read(),他的返回值有三种情况:
-
nbytes > 0:成功读取到了 nbytes个字节。- 注意:这不一定是 512! 如果文件只剩 100 个字节了,
nbytes就是 100。如果文件很大,内核可能只给你 512(因为你只给了 512 的空间)。
- 注意:这不一定是 512! 如果文件只剩 100 个字节了,
-
nbytes == 0:读到了文件末尾(EOF,End Of File)。没有更多数据了。 -
nbytes == -1:出错了(比如 fd 无效、硬盘故障等)。此时代码里的 if (... < 0)就会成立,打印错误信息并退出。
文件写入也需要一个fd

参数与read类似 write(fd, buf, sizeof(buf)) 也是向内核发出请求,告诉内核三件事:
-
fd:我要往哪个文件里写?(拿着通行证找文件) -
buf:要写的数据从哪里来?(从用户态内存的 buf数组里取) -
sizeof(buf) :我最多要写多少字节?(这里是 512 字节)
write 的返回值 nbytes 也有三种情况:
-
nbytes > 0:成功写入了 nbytes个字节。- 注意:这不一定是 512! 如果内核缓冲区满了(比如写网络套接字、写管道),或者被信号打断,它可能只写了 100 字节。剩下的 412 字节需要你自己再调用
write 补写。
- 注意:这不一定是 512! 如果内核缓冲区满了(比如写网络套接字、写管道),或者被信号打断,它可能只写了 100 字节。剩下的 412 字节需要你自己再调用
-
nbytes == -1:出错了(比如 fd 无效、硬盘满了、没有写权限等)。代码里的 if (... < 0)会捕获这个错误,打印信息并退出。 -
nbytes == 0:通常不会出现在 write中(如果写了 0 字节,说明你传的 count 是 0)。
typedef struct {
    int rio_fd;                /* 描述符 */
    int rio_cnt;               /* 内部缓冲区中未读的字节数 */
    char *rio_bufptr;          /* 指向内部缓冲区中下一个未读字节 */
    char rio_buf[RIO_BUFSIZE]; /* 内部缓冲区 */
} rio_t;
这里使用了一个带缓冲区的rio_t 结构体,其核心意图是通过构造缓冲区来减少直接系统调用带来的巨大性能开销。
-
没有缓冲的
read:如果你要读一个文件里的 1000 个字符,你调用 1000 次 read(fd, &c, 1),就会触发 1000 次系统调用(1000 次用户态/内核态切换)。这个开销是巨大的。 -
有缓冲的
rio_read:- 第一次调用
rio_read 时,发现缓冲区是空的(rio_cnt == 0)。 - 它一次性调用
read(fd, rio_buf, 8192),把一大块数据(比如 8192 字节)从内核读到用户态的 rio_buf里。 - 然后每次
rio_read 就只是从 rio_buf里拿一个字节(纯内存操作,极快)。 - 只有当缓冲区里的数据被拿完了(
rio_cnt == 0),才会再次调用 read去内核里取下一大块。
- 第一次调用
这样,读 1000 个字符,可能只需要 1 次系统调用,而不是 1000 次。
元数据可以是作为文件的属性信息,这些信息不由文件本身来决定,而是由内核维护。内核在硬盘上有一个专门的结构(inode)来存储这些元数据

ls -l 就是应用了这个结构体的逻辑来实现的
在Unix系统中,系统使用了三层结构来管理文件:

-
进程私有的描述符表(Descriptor Table)
每个进程独享一张
本质是一个下标为fd的数组。当open()一个文件时,内核返回一个fd,就是这张表的索引
-
全系统共享的打开文件表(Open file table)
整个内核只有一张,所有进程共享
这张表中维护两个字段 File pos(文件偏移量)和refcnt(引用计数)
-
File pos (文件偏移量) :这就是之前读 read 时,内核维护的“当前读到哪儿了”。注意:偏移量在这一层,不在 v-node 层。 这意味着,如果你用两个不同的 open 打开同一个文件,会得到两个不同的打开文件表项,它们有各自独立的偏移量。 -
refcnt (引用计数) :有多少个描述符指向这个条目。当close(fd 0) 时,refcnt减 1;减到 0 时,这个条目才会被释放。
-
-
全系统共享的v-node表
整个内核只有一张,所有进程共享
每一张都代表了一个真实文件或设备。保存一些有关文件元数据的关键字段。
即便使用open打开同一个文件100次,v-node表里面也只有一个对应条目
这保证了如果你在磁盘上修改了文件大小,所有打开这个文件的进程都能立刻感知到。
假设现在,有一个程序,使用了open(),打开了两次同一个文件,那么应该有如下的结构:

两次open,获得了不同的fd,对应的不同的打开文件表(存储游标信息),但是同一个v-node(因为本质上是对同一个文件进行操作)
int fd1 = open("test.txt", O_RDONLY); // 假设返回 3
int fd2 = open("test.txt", O_RDONLY); // 假设返回 4

char buf[10];

// 从 fd1 读 5 个字节
read(fd1, buf, 5);
// 此时,fd1 对应的 Open file table 里的 File pos 从 0 变成了 5

// 从 fd2 读 5 个字节
read(fd2, buf, 5);
// 关键点:fd2 对应的 Open file table 里的 File pos 依然是 0!
// 所以它读到的是文件的【前 5 个字节】,而不是第 6-10 个字节。

更常见的情况是,在多进程程序中,子进程会继承父进程的文件状态:

当fork()的时候,子进程复制了父进程的描述符表。父进程的 fd 3 和子进程的 fd 3,指向的是同一个打开文件表条目(而不是两个)。因此,它们共享同一个 File pos。父进程读了 5 个字节,子进程再读,就是从第 6 个字节开始。
因此,在此情况下,必须使用引用计数,来表明当前有多少个文件描述符指向该条目,来确定“什么时候可以安全的销毁这个打开文件表”

这张图展示的是IO重定向。正常情况下,ls会往fd1(也就是标准输出)写入数据,所以ls的结果会直接显示在终端被我们看到。但是现在我不想让这个数据写入终端,我希望用一个文件把这个结果保存下来。
也就是 ls往fd1写入数据的时候,实际的数据流入到foo.txt。这个时候,我们可以把fd1指向的打开文件表指向foo的打开文件表。
因此,实际上我们在 Shell 里执行 ls > foo.txt 时,Shell 内部实际上做了这几步:
-
fork() :Shell 创建一个子进程。 -
open("foo.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644) :子进程打开(或创建)foo.txt。假设返回 fd 4。- 此时:
fd 1 指向终端,fd 4 指向 foo.txt。
- 此时:
-
dup2(4, 1) :核心动作! 把 fd 1(stdout)指向 fd 4指向的文件。- 此时:
fd 1 和 fd 4 都指向 foo.txt。
- 此时:
-
close(4) :关闭 fd 4。因为 fd 1 还在用这个文件,refcnt依然是 1,文件不会失效。这一步是为了清理不需要的 fd。 -
execve("/bin/ls", ...) :子进程变身成 ls程序。ls 程序开始运行,它默认往 fd 1写数据。- 但此时
fd 1 已经指向 foo.txt了! - 所以,
ls 的输出全部写进了 foo.txt,而不是屏幕。
在libc中,相较于原始的UnixIO(就是普通的open read write等)包含了很多高阶的标准IO功能(都带有缓冲区),比如 fopen,fread等:
