L13 Linking
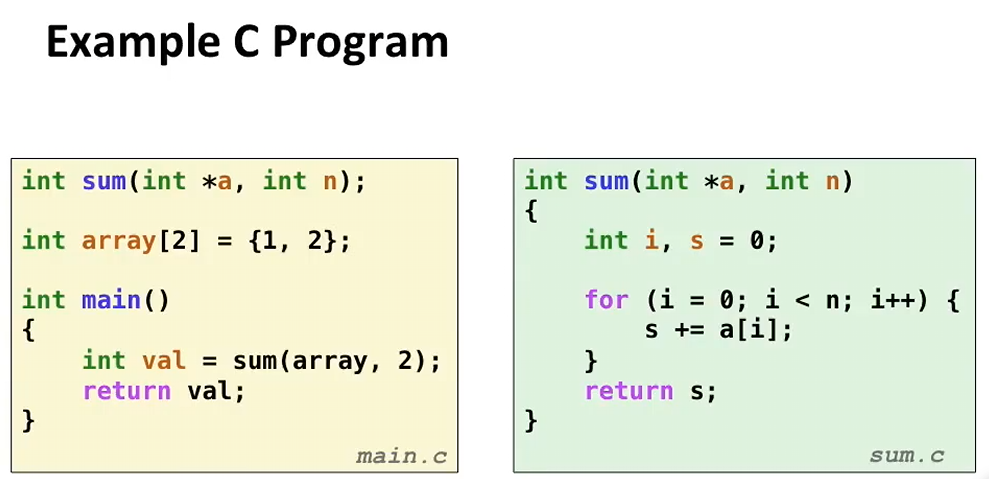
在这个程序中,有两个模块,一个是mainl.c 还有sum.c。main.c调用了 sum.c
当我们尝试编译运行的时候,发生了下图的过程:
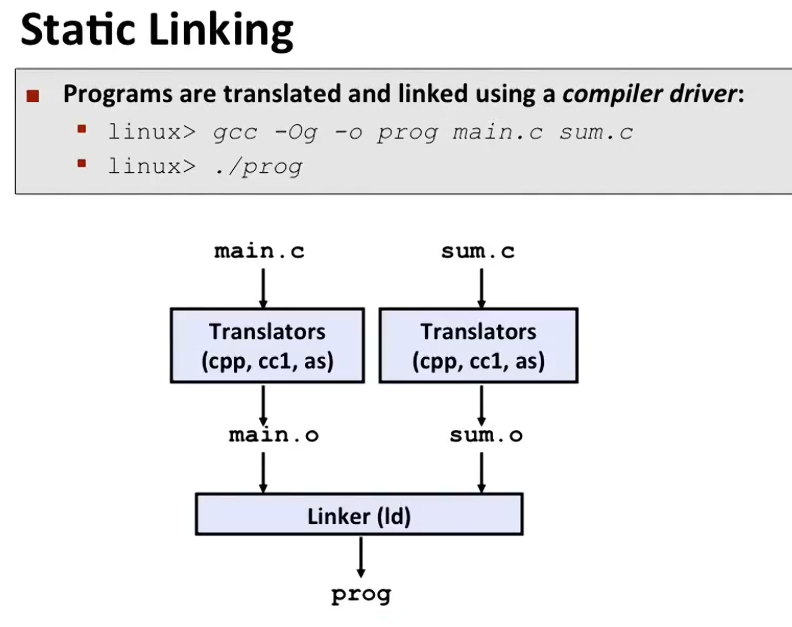
GCC会在这些模块上调用.c文件上的一些列编译器。首先进行的是预处理,会将main.c 翻译成main.i(ASCII中间件)。随后调用编译器cc1,将main.i 翻译成ASCII汇编语言文件 main.s。最后生成了一个.o文件 被称为main.o。对于sum.c 也是一样的过程。
随后 Linker将这两个.o文件进行连接(放一些必要的系统目标文件),把他们拼成一个,创建一个单独的可执行文件然后运行。
这些.c文件叫sourcefile, .o的文件叫objectfile(可重定位目标文件)
那么,为什么使用Linker呢?
- 代码模块化,允许把代码拆成各更小的部分
- 效率,如果将程序拆成多个块,假设修改了某一个模块,那么在整体进行编译的的时候就无需再次编译其他模块,只需要编译修改过的那个模块即可。除此之外,我们的程序往往只是用C标准库的一小部分。所以这在时间上可空间上都是有效的
Linker具体做了什么呢:
-
简单解析(符号解析):程序会定义和引用符号
- 定义符号(Define) :例如
void swap() {...} 定义了函数 swap;int *xp = &x; 定义了全局变量 xp。 - 引用符号(Reference) :例如
swap(); 引用了 swap 函数;int *xp = &x; 中的 &x 引用了变量 x。
在进行 分离式编译 是 编译器会在.o 文件里面生成一张符号表
- 这张表本质上是一个结构体数组(array of structs) 。
- 数组里的每个条目记录了:符号的名称、大小和位置。
- 此时,如果代码引用了别的文件里的函数(比如调用了标准C库的
printf),在这个 .o 文件的符号表里,它会被标记为“未解析”(Undefined),因为当前文件不知道 printf具体在哪。
- 定义符号(Define) :例如
-
Relocation 重定位:
上一步符号解析完成之后,每个.o文件里面都标记了符号的位置 大小 等信息。此时编译器不知道最终的完整程序会被放在内存的哪个位置。因此,每个.o文件内部的代码和数据地址都是在模块中从0开始的相对偏移量。
Relocation 主要是将各个模块整合到一起。主要完成了下列的步骤:
- 动作一:合并节(Merges separate code and data sections into single sections)
.o 文件有代码段(.text)、数据段(.data)等。链接器会把所有 .o 文件的同类段合并到一起。比如把所有 .o的代码段拼成最终可执行文件的一大块代码段。 - 动作二:分配绝对地址(Relocates symbols… to their final absolute memory locations)
链接器为合并后的各个段在最终可执行文件的虚拟内存空间里分配具体地址(比如代码段从 0x400000 开始)。
这就是把 .o文件中的“相对位置(relative)”变成了可执行文件中的“绝对内存位置(absolute)”。 - 动作三:更新引用(Updates all references to these symbols…)
这是最核心的一步。链接器会遍历代码,找到所有需要重定位的地方(比如函数调用、全局变量访问),把之前占位的相对地址,打补丁(Patch) 替换成刚刚分配好的绝对地址。
- 动作一:合并节(Merges separate code and data sections into single sections)
在后续我们会具体展开
这里有三种对象文件(Object Files):
-
可重定位目标文件 (.o文件)
包含可以与其他.o文件组合的代码和数据
每个.o文件恰好由一个.c源文件生成 -
可执行目标文件 (a.out文件)
这个文件可以直接被复制到内存中运行。因为相较于.o文件,在经过linker进行符号解析+重定位之后,其地址已经完全确定,符号已解析。具备了可执行的结构(在linux下是ELF格式)
-
共享目标文件 (.so文件)
-
特殊类型的可重定位目标文件(Special type of relocatable object file) :
.so 文件和上一张PPT讲的 .o 文件类似,代码在编译时都没有分配绝对物理地址。但不同的是,.so 文件的设计极其特殊,它通常是位置无关代码(PIC, Position-Independent Code) ,意味着无论它被加载到内存的哪个角落,它都能正常运行。 -
动态链接(Linked dynamically) :你写代码时调用的
printf、malloc,它们的具体实现都在 libc.so 里。当你用 gcc main.c 编译时,GCC 并不会把 printf 的机器码复制到你的 a.out 里,而是留下一个标记:“我需要 libc.so.6 里的 printf”。这就叫动态链接。 -
加载时或运行时(at either load time or run-time) :
- 加载时(Load time) :你执行
./a.out 时,操作系统加载器(Loader)发现需要 libc.so.6,就把它从硬盘加载到内存,并把 printf的真实内存地址填入你的程序中,然后开始执行。这也就是 PPT 上说的“可以加载到内存并链接”。 - 运行时(Run-time) :程序运行到一半,用
dlopen() 函数打开了一个插件(比如某些 .so插件)。这就是运行时动态链接。
- 加载时(Load time) :你执行
-
Windows 的 DLL:PPT最后一句提到了它在 Windows 下的名字叫 Dynamic Link Libraries (DLL),也就是你经常在 Windows 文件夹里看到的
.dll 文件(如 kernel32.dll)。
为什么要使用.so文件(动态链接)呢?
如果每个用到
printf 的程序(比如 ls、cat、gcc 本身),都把 glibc 里的代码复制到自己身上(这叫静态链接),会导致灾难性的后果:- 极度浪费磁盘:每个程序都会变大几百 KB 甚至几 MB。几百个程序,磁盘全被相同的代码塞满了。
- 极度浪费内存:你开 10 个终端,内存里就有 10 份一模一样的
printf代码,物理内存会被迅速耗尽。 - 维护噩梦:如果
glibc发现了一个严重安全漏洞,你需要重新编译系统里所有的程序。
而用了
.so 之后(动态链接),磁盘上只有一份 libc.so。运行 10 个程序时,操作系统在物理内存里只加载一份 libc.so的代码(所有进程共享这块只读内存),极大地节省了资源和维护成本。 -
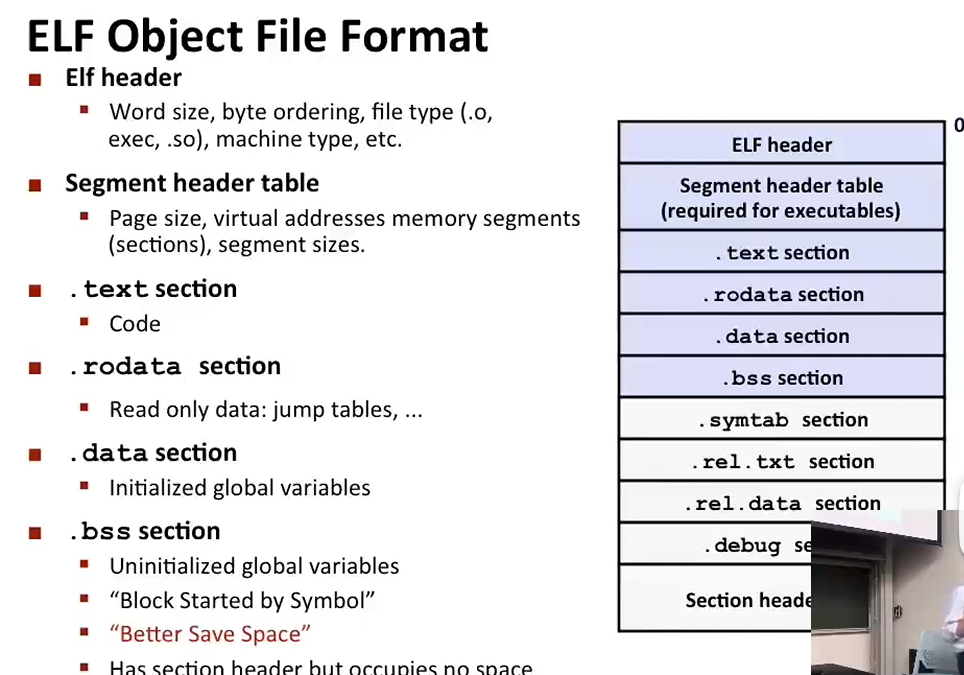
ELF文件被分成了这样几个部分:
第一类:全局管理结构(文件的“身份证”与“目录”)
-
ELF header(ELF 文件头)
- 位置:文件最开头(偏移量 0)。
- 作用:相当于文件的“身份证”。左侧PPT写了,它记录了字长(32位还是64位)、字节序(大端还是小端)、文件类型(是
.o 还是可执行文件 exec,还是动态库 .so)、机器类型(x86还是ARM)以及程序的入口地址(Entry point) 。 - 关键点:操作系统加载程序时,第一件事就是读这里,看看怎么加载。
-
Segment header table(程序头表 / 段头表)
- 位置:ELF header 之后。
- 作用:右侧图表明确标注了
required for executables(可执行文件必需)。它是给操作系统加载器(Loader)看的目录。它告诉OS:内存里需要几个段(Segment)?每个段的权限(只读/可写/可执行)是什么?对应的磁盘文件偏移量是多少? - 关键点:左侧文字翻译为“Segment header table”稍微有点不标准,标准术语是 Program Header Table。
-
Section header table(节头表)
- 位置:右侧图表的最底部(文件末尾)。
- 作用:它是给链接器(Linker)和调试器看的目录。它记录了文件中每一个节(Section,如 .text, .data)的名字、类型、大小、在文件中的偏移量。
- 关键点:操作系统加载程序不需要看这个表。
第二类:核心运行数据(真正会被加载到内存的部分)
这四部分是程序运行的本质,也是前面PPT反复强调的:
-
.text section (代码节)- 内容:编译后的机器指令。
- 属性:只读、可执行。不允许修改,防止程序跑飞篡改指令。
-
.rodata section (只读数据节)- 内容:PPT写了“Read only data: jump tables…”。更常见的是字符串常量(比如
printf("Hello World") 里的 "Hello World")、全局 const变量。 - 属性:只读。加载到内存后通常和
.text合并在同一个只读段(Segment)里。
- 内容:PPT写了“Read only data: jump tables…”。更常见的是字符串常量(比如
-
.data section (数据节)- 内容:已初始化的全局变量和静态变量(比如
int global_x = 10;)。 - 属性:可读写。因为已经初始化了,所以占磁盘空间,里面实实在在地存着 10 这个值。
- 内容:已初始化的全局变量和静态变量(比如
-
.bss section (未初始化数据节)- 内容:未初始化的全局变量和静态变量(比如
int global_y;)。 - 为什么叫BSS:PPT给了两个解释——“Block Started by Symbol” 或 “Better Save Space”。
- 核心特性:PPT强调“Has section header but occupies no space”(有节头,但不占空间)。在磁盘文件里,它只记录“需要多少字节”,不存实际数据(节省磁盘);加载到内存时,操作系统直接分配一片全为0的内存给它。
- 内容:未初始化的全局变量和静态变量(比如
第三类:链接与调试辅助(工具专用,不占内存)
右侧图表里还有几个左侧文字没提到的部分,它们是给链接器和调试器打工的:
-
.symtab section (符号表)- 作用:记录了本文件里定义了哪些函数和全局变量(比如
swap),以及引用了哪些外部符号(比如 printf)。上一张PPT讲的“符号解析”就是靠它。
- 作用:记录了本文件里定义了哪些函数和全局变量(比如
-
.rel.text section 和 .rel.data section (重定位表)- 作用:记录了代码段和数据段中,哪些地方的地址是“占位符”,需要链接器在合并时修改。上一张PPT讲的“重定位”就是靠它。
-
.debug section (调试信息节)- 作用:如果在GCC编译时加了
-g 参数,就会生成这个节,包含源代码行号、变量类型等信息,供 GDB调试使用。发布正式版本时通常会去掉。
- 作用:如果在GCC编译时加了
连接器标记主要有三种:
1. Global symbols(全局符号)
- 定义:由当前模块 m(也就是当前的
.o 文件)定义,并且可以被其他模块(其他 .o 文件)引用的符号。 - 例子:非
static 的 C 函数(如 void swap() {...})和非 static 的全局变量(如 int global_x = 10;)。 - 链接器视角:这类符号是“公共财产”。链接器在做符号解析时,如果别的文件引用了它,链接器就会把地址指向这里。
2. External symbols(外部符号)
- 定义:由当前模块 m 引用,但是由其他模块定义的全局符号。
- 本质:它其实是 Global symbols 的一个子集(从引用的角度来看)。
- 例子:你在
main.c 里调用了 printf(),或者调用了 swap.c 里定义的 swap()。此时在 main.o 里,printf 和 swap就是外部符号。 - 链接器视角:这类符号是“欠条”。链接器看到它们时,必须去其他
.o 文件或库(如 libc.so)里找到对应的 Global symbols 来还债(解析),否则就会报 undefined reference错误。
3. Local symbols(局部符号)
- 定义:只能由当前模块 m 自己定义,且只能被自己引用的符号。
- 例子:使用了
static 属性的 C 函数和全局变量(如 static int count = 0; 或 static void helper() {})。 - 链接器视角:这类符号是“私有财产”。链接器看到它们时,知道它们绝对不能被外部模块引用。在合并
.o 文件时,哪怕另一个文件里也有一个叫 helper的静态函数,也不会发生冲突(因为它们是局部符号,互不干扰)。
假设我现在libc.so 里面定义了printf 然后被main.o 调用 对于main.o 来说 这个printf() 就是外部符号,对于libc.so 就是全局符号 这都是相对的。对于静态方法,往往是局部变量。
现在有下列例子:
//main.c
int sum(int *a, int n);

int array[2]={1,2}	//定义局部符号

int main(){		//定义全局符号
	int val = sum(array,2);	//引用全局符号sum 和 array
	//val是堆栈上的局部变量 linker实际上对其没有任何了解
	return val
}
//sum.c
int sum(int *a, int n){	//定义全局符号
	int i,s = 0;	//局部变量
	for (i = 0; i < n ; i++){
		s+=a[i];
	}
	return s;
}
int f(){
	static int x = 0;
	return x;
}
int g(){
	static int x = 1;
	return x;
}
在这个函数中 f 和 g里面的 x作为静态局部变量,仅存储在.data中,而不是创建在堆栈。范围也仅限这个f(),g()内部
编译器在处理他们的时候,会在.data 中为每个x创建定义空间。并且给予他们独特的名称 比如对于f里面的x是x.1;对于g里面的是x.2
如果多个模块定义了同一个符号,连接器听谁的呢?比如下面的情况:
//p1.c
int foo=5;
p1(){
}
//p2.c
int foo;
p2(){
}
两个程序中都有自己的foo。那么在linker进行整合的时候,会引入两个概念:强符号和弱符号
-
强符号(Strong) :函数 和 已初始化的全局变量。
- 例子:
p1.c 里的 p1() {}以及p2.c 里的 p2() {}和 int foo=5;(已初始化全局变量)。
- 例子:
-
弱符号(Weak) :未初始化的全局变量。
- 例子:
int foo;(未初始化全局变量,属于弱符号)。
- 例子:
接下来会严格按照三条规则,对这些相同符号名进行处理:
- 规则一:强符号 + 强符号 = 报错
如果两个文件都定义了强符号(比如 p1.c 和 p2.c 都有 int foo = 5;),链接器会直接报错 multiple definition of 'foo'。因为强符号代表“确定的定义”,两个确定的东西冲突了,程序就废了。 - 规则二:强符号 + 弱符号 = 选强符号
如果 p1.c 定义了强符号 int foo = 5;,而 p2.c 只有弱符号 int foo;,那么链接器会毫不犹豫地选择强符号(也就是 foo = 5)。p2.c里的弱符号会被忽略。 - 规则三:弱符号 + 弱符号 = 随机选一个
如果 p1.c 和 p2.c 都只有 int foo;(全是弱符号),链接器会随便选一个(通常选占用内存空间最大的那个,或者先扫描到的那个),并把所有引用都指向这个选中的定义。
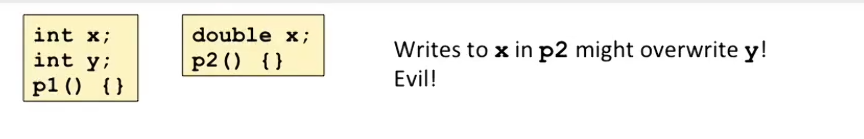
在这里为什么会影响到y呢?
这是一个非常经典的“链接器与内存布局”的迷惑行为。你的疑惑很合理:既然弱符号+弱符号,链接器会“选一个覆盖”,那为什么还会影响到 y?
核心原因在于:链接器选择的是“符号地址”和“预留空间大小”,而不是简单的“源码级代码替换”。 让我们拆解一下这背后的内存布局。
1. 编译阶段:各自为政的视角
GCC 在分离编译时,p1.c 和 p2.c 是互相不知道对方存在的。
- 对于
p1.o (编译器视角) :
int x; 和 int y; 都是未初始化的弱符号。
汇编代码认为:x 在偏移量 0(占4字节),y 在偏移量 4(占4字节)。所以 p1() 访问 y 的代码会被编译成 访问 [x地址 + 4字节]。 - 对于
p2.o (编译器视角) :
double x; 也是弱符号。
汇编代码认为:x 在偏移量 0(占8字节)。所以 p2() 访问 x 的代码会被编译成 访问 [x地址 + 0],并且写入8个字节。
2. 链接阶段:弱符号的“弱肉强食”
当链接器把 p1.o 和 p2.o 链接在一起时,它遇到了两个都叫 x 的弱符号。
- 链接器根据之前的规则(弱+弱=任选一个),它必须选一个。
- 通常,链接器会选择占用空间最大的那个定义(在这个例子中是
double x;,占8字节),以防止内存越界。 - 因此,最终在可执行文件的数据段(.bss)里,链接器只分配了一块 8字节 的内存给符号
x。
此时,最终的内存布局变成了:
x 独占 8 字节(地址假设为 0x1000 到 0x1007)。y 被迫向后移动,被分配在 x 后面的4字节(地址 0x1008 到 0x100B)。链接器会将 p1.o 里的 y符号解析到这个新地址。
3. 灾难发生:为什么“写 p2 的 x 会覆盖 y”?
- 当程序运行,调用
p2() 时,它认为 x 是 8 字节的 double。于是它向地址 0x1000 开始,写入 8 个字节的数据。 - 它写入了
0x1000 到 0x1007这 8 个字节。 - 但是!
p1() 在访问 y 时,它以为 y 就在 x 后面 4 字节的位置(即 0x1004)。 - 结果就是:
p2() 对 x 的写入(覆盖了 0x1000 到 0x1007),实际上把 y (住在 0x1004 到 0x1007 的 4 个字节)给一并覆盖了!
4. 总结与避坑(PPT为什么要说 "Evil")
PPT 感叹 "Evil!" 是因为这是一种极端隐蔽的内存破坏(Memory Corruption) 。
在 p1.c 的开发者看来,p2.c 只不过在改它自己的全局变量 x,怎么会莫名其妙把自己的 y 给改了呢?
现代编译器的改进(注意!) :
图中的这个现象,实际上只发生在“暂定定义(Tentative Definition)”且采用“COMMON 块”分配的历史时期(或者说使用了 -fcommon 编译选项)。
从 GCC 10 开始,默认选项变成了 -fno-common 。 这意味着 int x; 和 double x; 会被视为强符号。当你试图链接这两个文件时,链接器会直接报错 multiple definition of 'x',阻止这个程序生成。这比运行时偷偷把 y 改坏(极难调试的 Bug)要好得多。
如何避免这种坑?
- 永远不要在
.c 文件里裸写未初始化的全局变量。如果只需要本文件使用,一律加 static(变成局部符号,不会冲突)。如果必须跨文件共享,在 .c 里定义 int x = 0;(强符号),在 .h 里用 extern int x;声明。 - 编译时开启
-fno-common(现代 GCC 默认就是)。
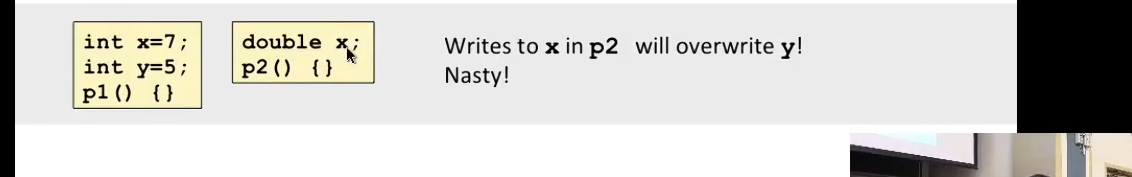
同样的道理,在这里x 和 y都被定义过了,p1中以及最后编译器实际使用的内存分布是4+4字节,但是对于p2来说 x是八字节 所以会覆盖y
所以现在 链接其已经将每一个符号引用与一些简单的定于关联起来了。那么下一步就是Relocation(重定位) 也就是将每一个模块整合起来,并且决定在最后生成的可执行文件中的位置。
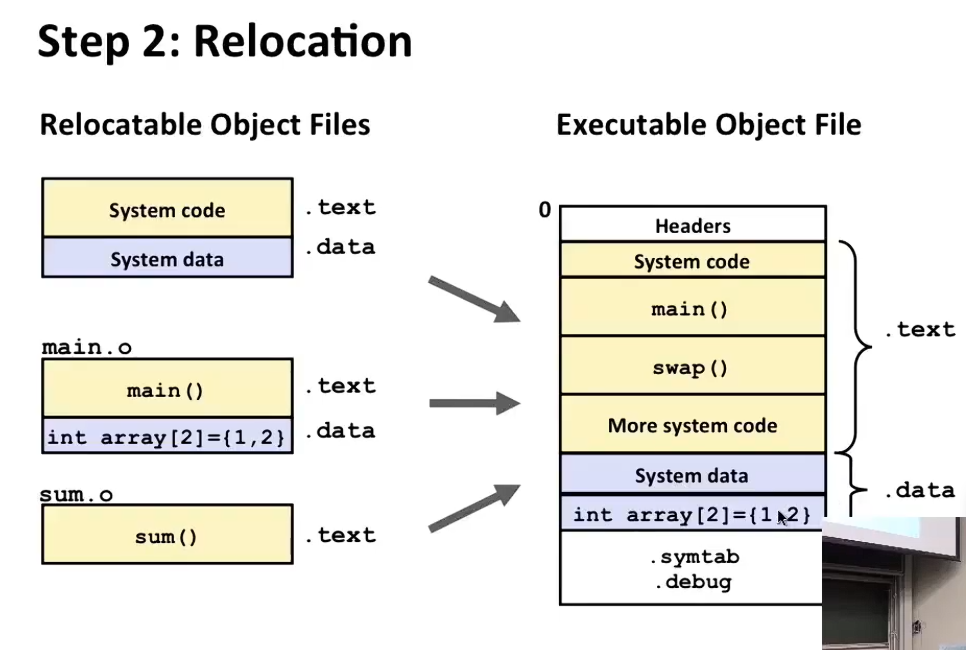
重定位实际上做了三件事情:
-
合并同类项: 将所有的.o文件的.text(代码)进行整合,拼成一个统一的.text。把所有的.data进行拼接,形成统一的.data。把所有的.bss 节整合在一起
-
分配绝对地址: 在每个.o文件中,代码和数据都是从0作为偏移量计算相对地址。linker需要对齐进行合并,最终在可执行文件的虚拟内存空间中,分配出一个绝对地址 比如
.text 从 0x400000 开始,.data 从 0x600000开始。 -
修正引用:
之前的main.c 里面我们编写过需要调用sum.c里面的sum()。但是由于是分开编译的,所以编译器甚至不知道sum.c到底存不存在,以及他的具体位置。因此在编译出来的main.o 里面的.text段中需要生成一条 call 0x0的指令(占位符),并且在.rel.text(重定位表)里面记录“这里的地址需要修正,符号名为 sum”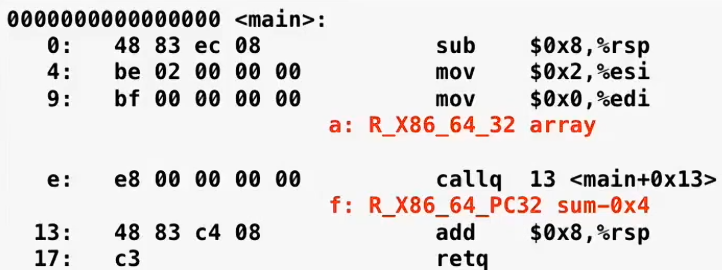
随后,linker通过符号解析,知道了sum在sum.o里面。合并完成之后,连接器算出了sum最终在内存中的绝对地址(假设是0x400500)随后找到.rel.text表,把刚才main.o里面记录的那个call 0x0占位符 换成0x400500
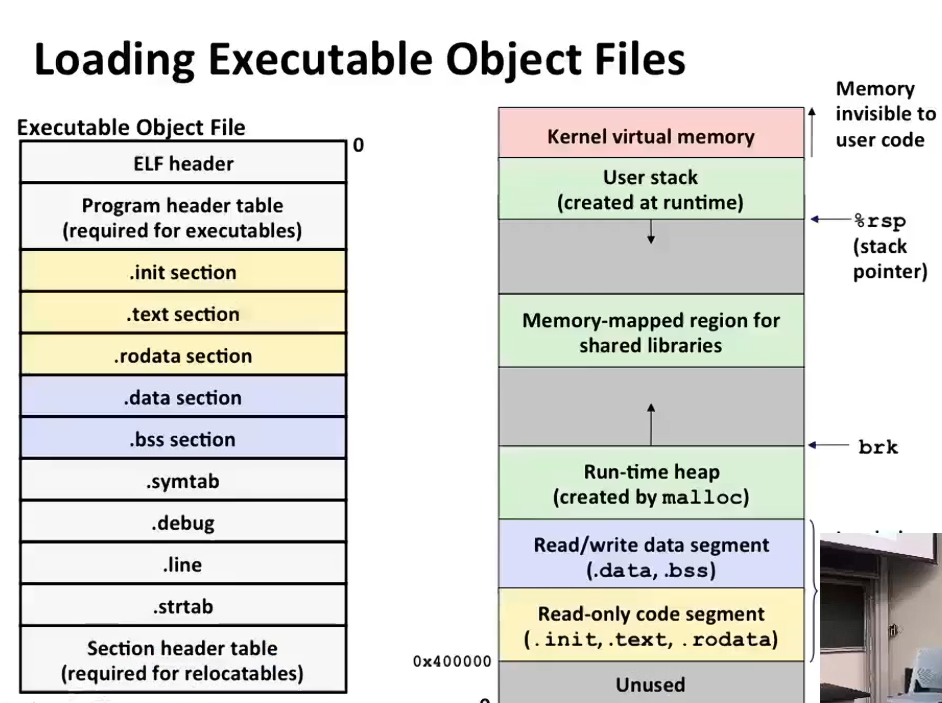
这张图就对应了ELF文件在linux中运行的内存分布,在前面的章节也有提到
那么,我们该如何把程序员常用的函数(比如数学计算、I/O、内存管理、字符串操作)打包起来,提供给别人使用?
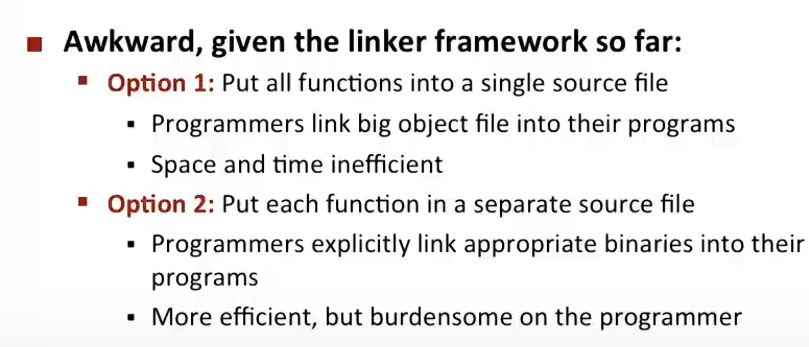
这里有两种选项:
方案1(Option 1):把所有函数放进一个巨大的源文件里。
- 做法:比如写一个巨大的
libc.c,里面包含所有函数。然后编译成一个巨大的 libc.o。 - 缺点:空间和时间效率低下(Space and time inefficient) 。因为链接器在合并时,会把整个巨大的
libc.o 全部复制进可执行文件。哪怕你只想用 printf,malloc、sin 等所有代码也会被强行塞进你的 a.out里,造成极大的磁盘和内存浪费。而且每次修改一个函数,整个巨型文件都要重新编译。
方案2(Option 2):每个函数单独放一个源文件。
- 做法:
printf.c 生成 printf.o,malloc.c 生成 malloc.o,sin.c 生成 sin.o。 - 优点:更高效(More efficient) 。链接器可以精确地把需要的
.o文件链接进来,不用的不要。 - 缺点:对程序员极其繁琐(burdensome on the programmer) 。程序员写代码时,如果用了几个函数,就必须在编译命令里显式列出几十上百个
.o 文件(比如 gcc main.c printf.o malloc.o sin.o string.o ...),这简直是灾难,完全没法用。
有一种老的解决方案:静态库(static library .a 文件)
这是一系列.o文件的集合,在链接器解析符号的时候,如果发现了有未定义的符号,那么就把他们引用进来做重定位,需要什么拿什么。
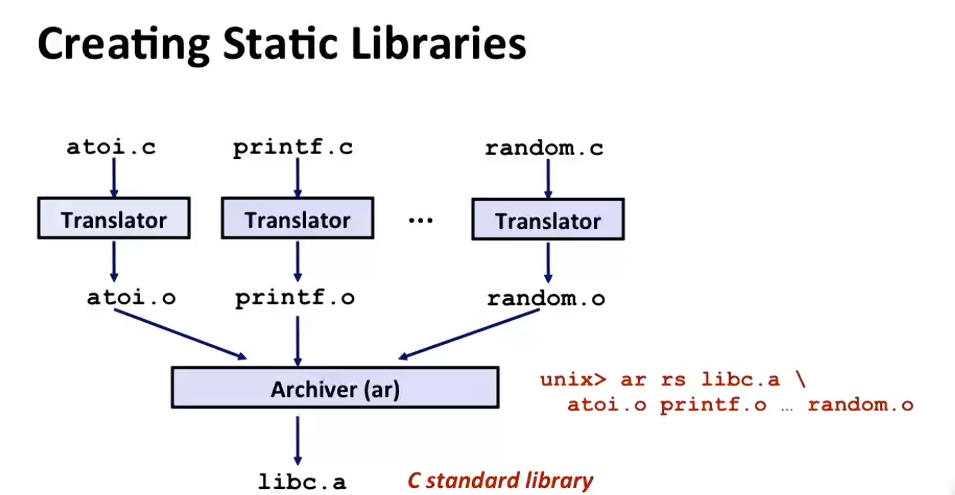
但是这样做存在问题:
- 内存膨胀:如果十个程序都用了
printf,静态链接会导致物理内存里有十份 printf 的副本(静态链接是在编译时把代码彻底塞进每一个 a.out里)。 - 更新噩梦:如果
libc.a发现了一个严重的安全漏洞,你需要把使用了它的所有程序全部重新编译一遍,否则漏洞还在。
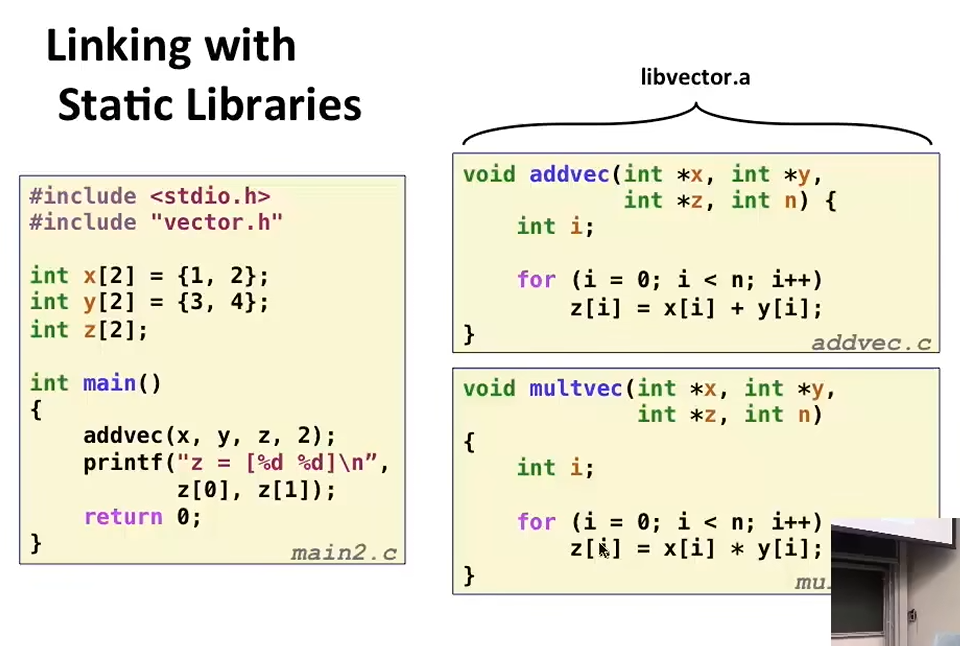
在这个例子中 创建了一个 libvector.a 库,在编译的时候发生了下图的过程:
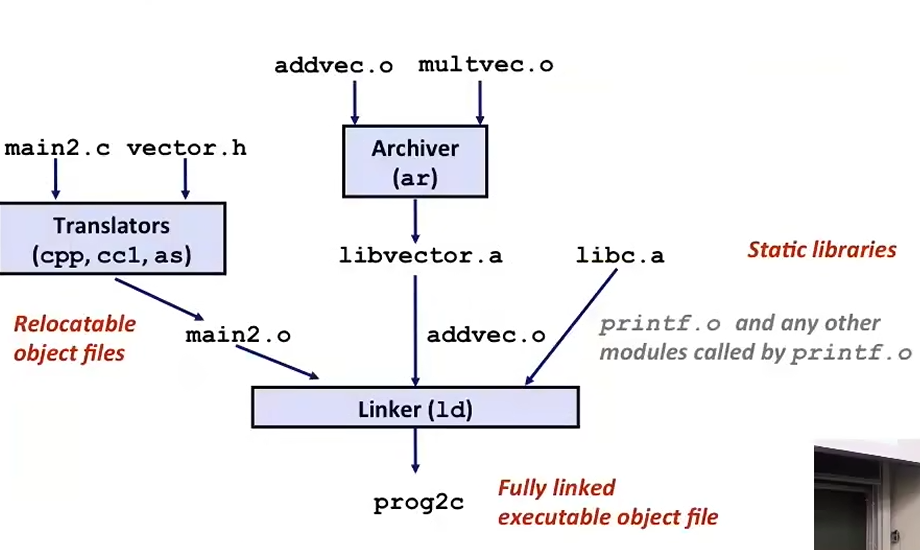
GCC在处理静态链接库,参考命令行顺序为依据:
-
从左到右扫描:链接器按照敲击
gcc 命令时输入文件的顺序,依次扫描 .o 文件和 .a文件。 -
维护未解析列表:扫描过程中,链接器手里始终拿着一个“当前未解析引用列表”(Unresolved references list)。
-
遇到新文件时尝试解析:当遇到一个新的
.o 或 .a文件时,链接器会拿着这个文件里的“已定义符号”,去匹配“未解析列表”里的符号。- 如果列表里有
printf,而这个文件里正好定义了 printf,那么 printf就被标记为“已解析”,并从列表中移除。
- 如果列表里有
-
扫描结束若仍有未解析项,报错:如果所有文件扫描完,列表里还有没解析的符号,链接器就会毫不留情地报错(
undefined reference)。
因此 命令行顺序很重要,需要把库放在命令行的最后面:
unix> gcc -L. libtest.o -lmine
unix> gcc -L. -lmine libtest.o
libtest.o: In function `main':
libtest.o(.text+0x4): undefined reference to `libfun'
现代的解决方案是使用动态库或者共享库
-
动态加载与链接(loaded and linked dynamically, at either load-time or run-time)
- 物理本质:它仍然是包含代码和数据的可重定位目标文件(本质上是特殊的
.so),但它不在链接时被复制进 a.out里。 - 加载时(Load-time) :当你执行
./a.out 时,操作系统加载器发现它依赖 libc.so,就会把 libc.so加载到内存,并在内存中完成地址绑定。 - 运行时(Run-time) :程序跑着跑着,突然用
dlopen()打开了一个插件(比如游戏挂载的模组),这就是运行时动态链接。
- 物理本质:它仍然是包含代码和数据的可重定位目标文件(本质上是特殊的
-
别名(Also called) :在 Linux 下叫
.so(Shared Object),在 Windows 下叫 DLL(Dynamic Link Library)。
- 解决磁盘重复:磁盘上只有一份
libc.so 文件。所有程序都只是记录一个“我依赖 libc.so”的标记,不再把代码复制进自己的 a.out里。 - 解决内存重复:当你运行 10 个程序时,操作系统在物理内存中只加载一份
libc.so的代码(只读内存页)。这 10 个进程通过虚拟内存页表,共享映射到同一块物理内存。这就是为什么现代系统能同时开几百个程序的原因。 - 解决维护噩梦:如果
libc.so 有漏洞,系统管理员只需要升级替换掉 /lib/x86_64-linux-gnu/libc.so.6 这一个文件。所有依赖它的程序不需要重新编译,下次运行时会自动加载新的、修复过漏洞的库。
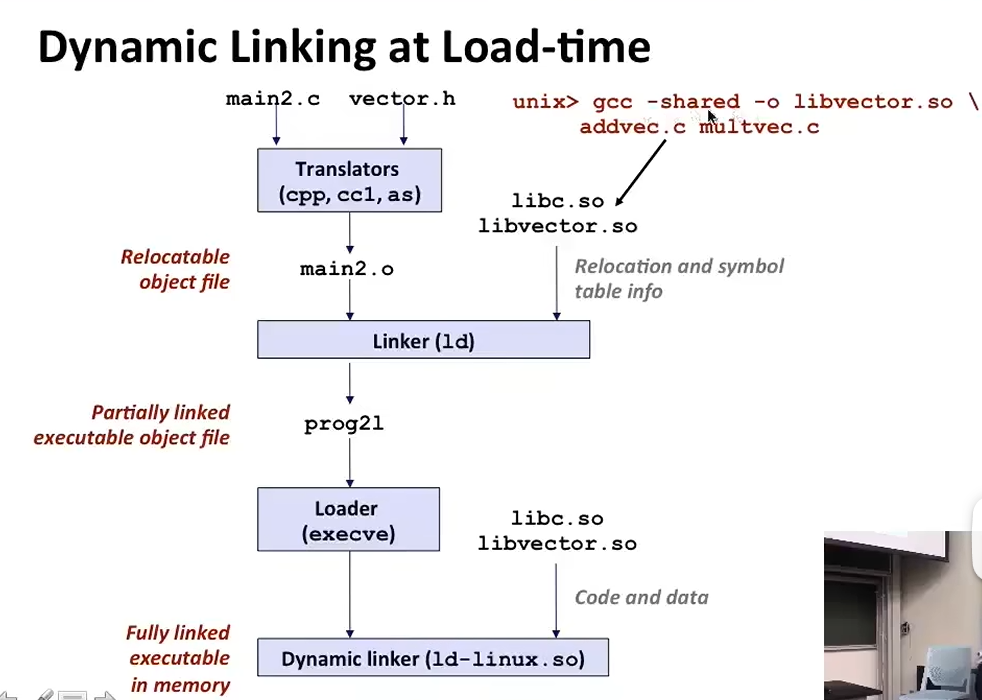
第一阶段:生成可重定位目标文件(左上角)
- 输入:
main2.c(源代码)和 vector.h(头文件)。 - 动作:Translators(翻译器,包括预处理器
cpp、编译器 cc1、汇编器 as)。 - 输出:
main2.o(可重定位目标文件)。 - 回顾知识:这就是你之前学过的“分离式编译”。
main2.o 里面有代码和数据,还有符号表(.symtab),里面记录着未解析的符号(比如它调用了 addvec函数,但不知道它在哪)。
第二阶段:生成共享库(右上角)
- 命令:
unix> gcc -shared -o libvector.so addvec.c multvec.c - 动作:这里用
-shared 参数生成了共享库 libvector.so。 - 注意:图里还画了
libc.so(标准C库)。这说明共享库是可以互相依赖的,libvector.so 可能也会调用 libc.so 里的 printf。
第三阶段:静态链接(中间部分)
- 输入:
main2.o(可重定位目标文件) + libc.so / libvector.so(共享库的符号表信息)。 - 动作:Linker(链接器
ld)。 - 输出:
prog21(部分链接的可执行目标文件 Partially linked executable object file)。 - 关键点(为什么叫“部分链接”?) :
链接器并没有把 libc.so 和 libvector.so 的代码和数据复制进 prog21 里。
它只是检查了一下符号表,确认 main2.o 引用的 addvec 能在 libvector.so 里找到,引用 printf 能在 libc.so 里找到。然后,它把这些依赖信息记录在了 prog21里,生成了一个“半成品”。
第四阶段:加载时动态链接(最下方)
这是这张图最精华的部分,也是动态链接最独特的地方。
-
输入:
prog21(半成品可执行文件)。 -
动作:Loader(加载器
execve)。当你执行 ./prog21时,操作系统加载器开始工作。 -
发生了什么?
- 加载器读取
prog21 的头部,发现它依赖 libc.so 和 libvector.so。 - 加载器把
prog21映射到内存。 - 加载器接着把
libc.so 和 libvector.so 的代码和数据(Code and data)也加载到内存中(这就是图中 libc.so 和 libvector.so指向下方的箭头)。 - 加载器启动 Dynamic linker (
ld-linux.so ) (动态链接器)。
- 加载器读取
-
Dynamic linker 的工作:
它负责在内存里进行最后的“打补丁”。它找到 prog21 里对 addvec 和 printf 的未解析引用,然后去内存中的 libvector.so 和 libc.so里找到真实的函数地址,完成重定位。 -
最终输出:Fully linked executable in memory(在内存中完全链接的可执行文件) 。此时,程序正式开始执行。
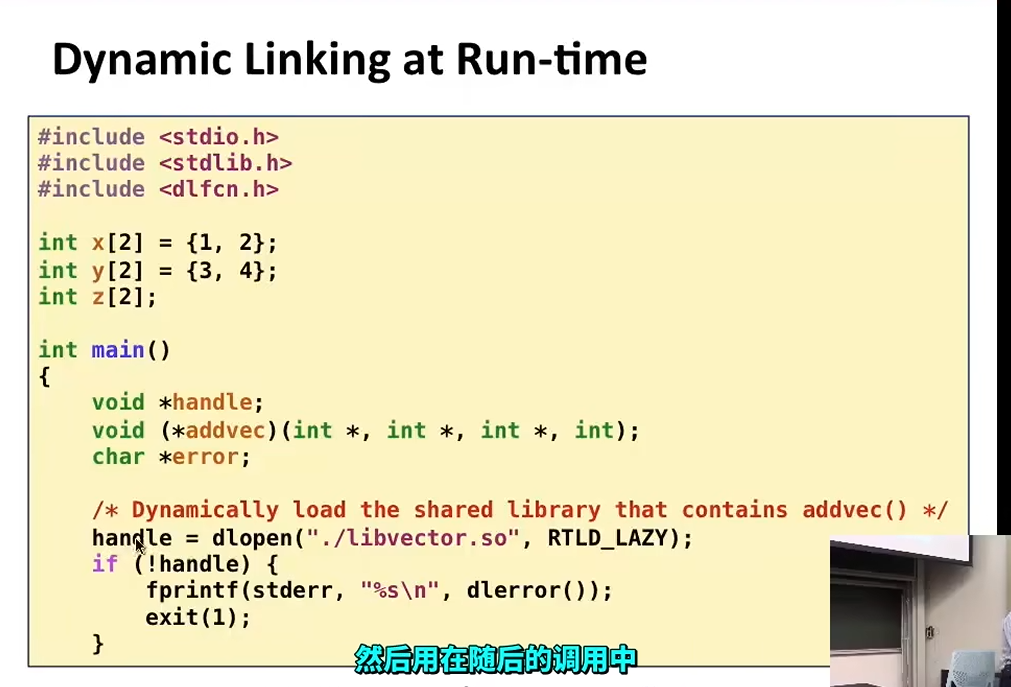
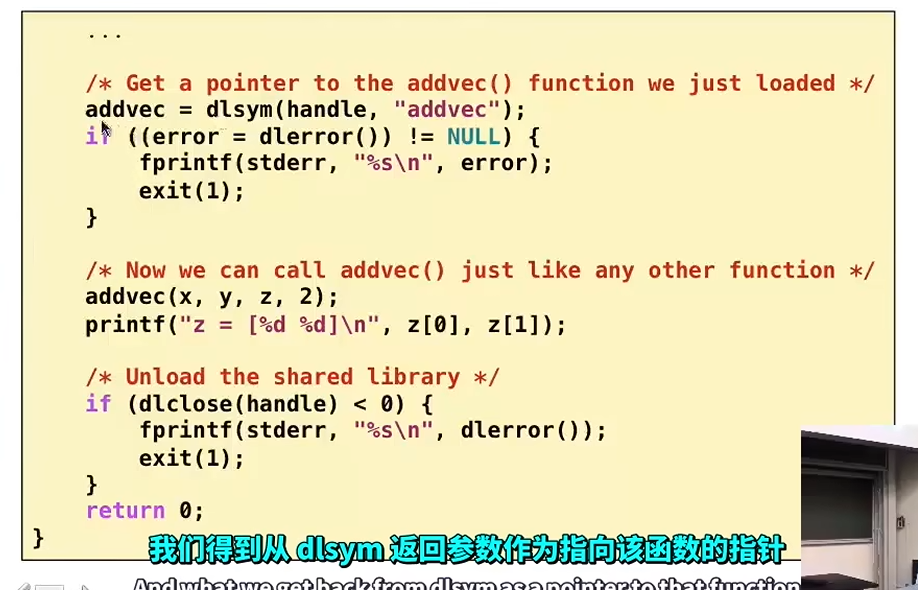
图中展示的是 运行时动态链接:程序已经跑起来了,运行到一半,自己决定去加载某个.so,并调用里面的函数。这种功能常见于plugins或者 mod
这里使用dlopen进行加载,把这个so加载到内存中,并且返回一个句柄(handler,简单理解为一些内存的抽象)供给后续调用。
随后,程序拿着刚才获取到的句柄,去库里面找相对应的符号,并且把内存中的真实地址返回给函数指针 addvec
调用完了之后,将句柄进行关闭
库打桩(Library Inter Positing),目标是 拦截来自库的函数调用
-
编译时(Compile time)
- 机制:利用C语言的宏定义(Macro) 。
- 做法:你写一个
my_malloc.h,里面写 #define malloc(size) my_malloc(size, __FILE__, __LINE__)。在源代码编译前,预处理器会把所有 malloc 替换成 my_malloc,从而记录下是哪个文件的哪一行申请了内存。 - 缺点:需要重新编译源代码,且只能拦截你自己写的代码,无法拦截已编译好的
.a 或 .so库。
-
链接时(Link time)
- 机制:利用静态链接器的符号解析规则(强/弱符号) 。
- 做法:你自己写一个
malloc.c,生成 my_malloc.o。链接时,把 my_malloc.o 放在 libc.a 的前面。链接器遇到未解析的 malloc 符号时,会优先在你的 .o里找到强符号定义,从而“截胡”标准库。 - 缺点:依然需要重新链接程序,且只对静态库有效。
-
加载/运行时(Load/run time)
- 机制:利用动态链接器(Dynamic Linker) 和环境变量(如
LD_PRELOAD)。 - 做法(最强大最常用) :你编写一个包含
malloc 函数的 .so 文件(比如叫 my_malloc.so)。运行程序时,通过命令 LD_PRELOAD=./my_malloc.so ./a.out启动。 - 原理:动态链接器在加载
a.out 时,会先加载 LD_PRELOAD 指定的库。当它解析 a.out 里对 malloc 的引用时,发现这个预加载的库里有 malloc,就直接用它了,libc.so 里真正的 malloc根本轮不到。 - 好处:不需要重新编译或链接任何代码! 直接对任何已编译好的二进制程序生效(当然,前提是你有权限运行它)。
- 机制:利用动态链接器(Dynamic Linker) 和环境变量(如
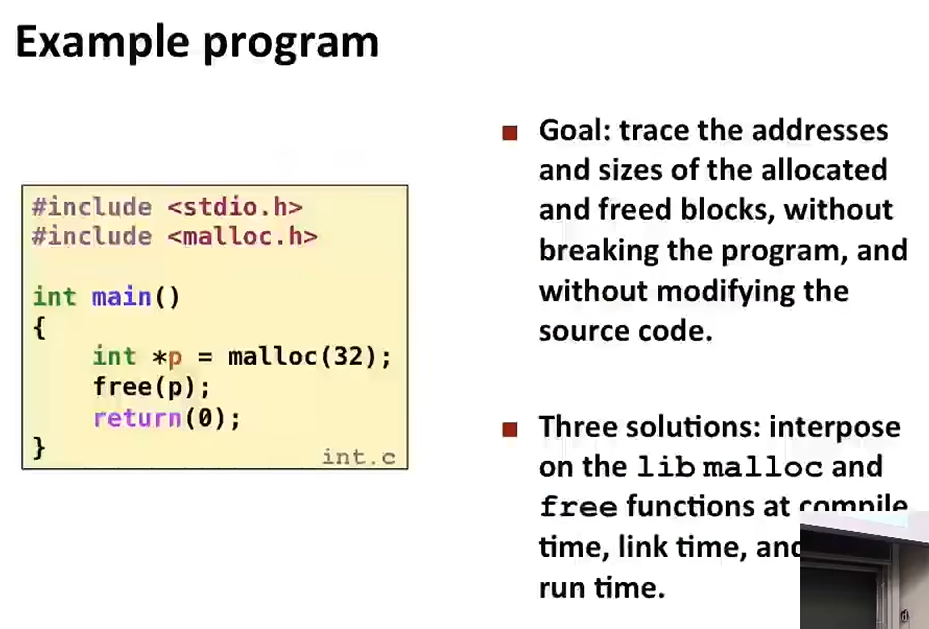
要追踪所有malloc以及free的调用 ,我们可以在编译/链接/加载/运行时进行库打桩
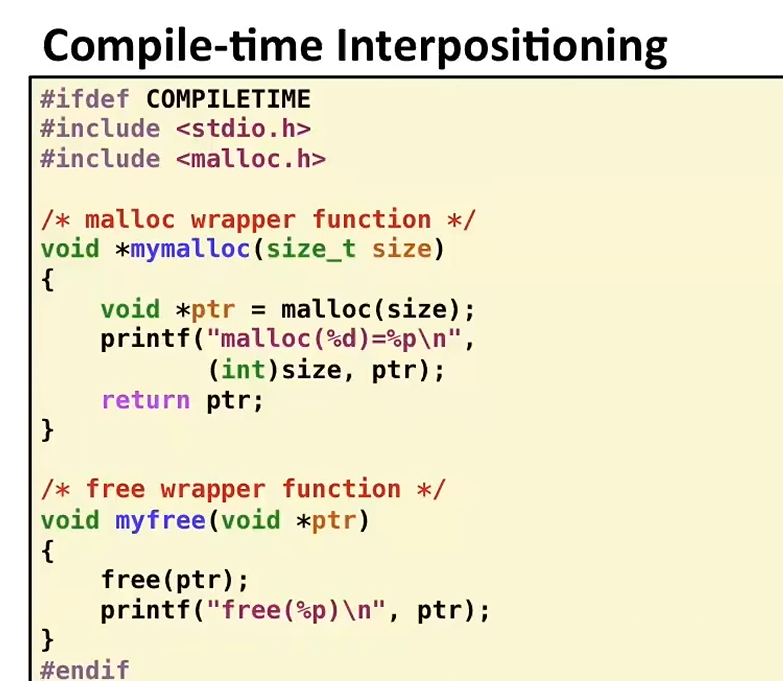
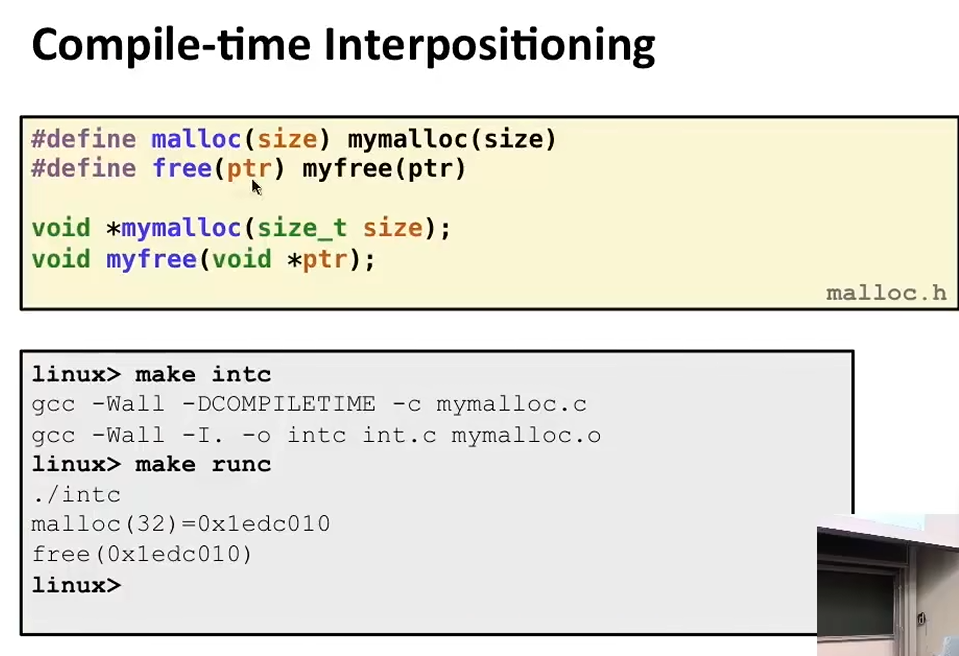
1. 核心思想:预处理器(cpp)的宏替换
编译时打桩的核心武器不是链接器,而是C语言的预处理器(Preprocessor) 。预处理器在真正的编译器(cc1)工作之前运行,它只做简单的文本替换。
2. 第一张图:编写“包裹函数”(Wrapper Functions)
-
这段代码被
#ifdef COMPILETIME 包围,意味着只有在编译时定义了 COMPILETIME宏,这段代码才会生效。 -
它定义了两个全新的函数:
mymalloc:内部调用真正的 malloc,但之后会打印出申请的大小和返回的指针地址,最后返回指针。myfree:内部调用真正的 free,但之后会打印出释放的指针地址。
-
这两个函数就是“替身”,它们负责处理日志,然后把核心工作交还给标准库。
3. 第二张图的上半部分:编写“欺骗性”头文件( malloc.h )
这是整个打桩技术的灵魂所在:
#define malloc(size) mymalloc(size)
#define free(ptr) myfree(ptr)
- 在这个
malloc.h 里,通过 #define 把 malloc 强行定义成了 mymalloc。 - 当预处理器扫描源代码时,只要看到
malloc(32),它就会自动替换成 mymalloc(32)。 - 这完全是在文本层面完成的,编译器还没开始解析语法。
4. 第二张图的下半部分:编译与链接命令
linux> gcc -Wall -DCOMPILETIME -c mymalloc.c
linux> gcc -Wall -I. -o intc int.c mymalloc.o
-
第一条命令:编译
mymalloc.c。注意 -DCOMPILETIME,它让那段被 #ifdef 包围的代码生效,生成 mymalloc.o。 -
第二条命令:编译并链接主程序
int.c。注意 -I.,这告诉 GCC “优先在当前目录(.)寻找头文件”。因此,主程序 int.c 包含 <malloc.h> 时,找到的是我们自己写的那个带有 #define的头文件,而不是系统标准库的头文件。- 于是,
int.c 里的 malloc 被预处理器替换成了 mymalloc。 - 最后,链接器把
intc(包含替换后的 mymalloc 调用)和 mymalloc.o(包含 mymalloc的真实定义)链接在一起。
- 于是,
5. 运行结果(第二张图底部)
./intc
malloc(32)=0x1edc010
free(0x1edc010)
主程序在申请和释放内存时,成功打印出了日志。这说明我们成功拦截了标准库的调用!
我们也可以在链接时进行:
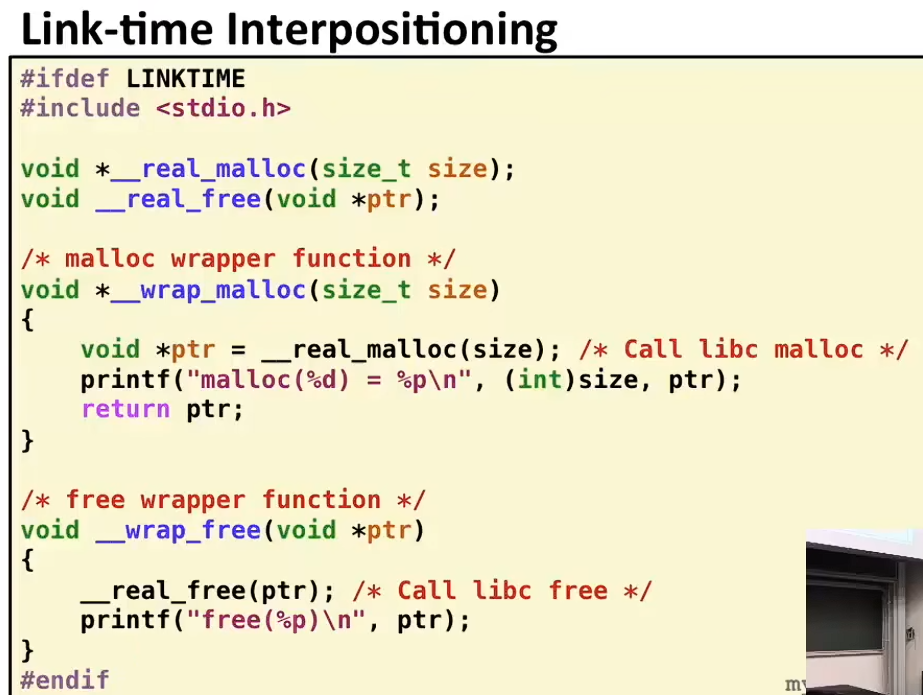
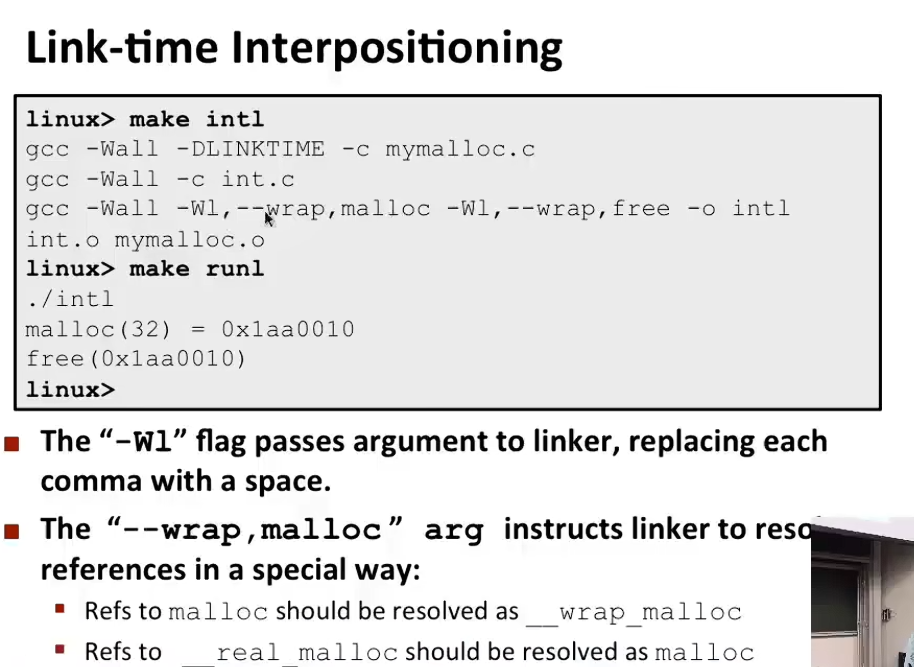
图里最关键的是这一行编译命令:
gcc -Wall -Wl,--wrap,malloc -Wl,--wrap,free -o intl int.o mymalloc.o
我们来拆解这行命令背后的原理:
-
-Wl, 是什么?-Wl告诉 GCC:“后面的参数不要给编译器,请直接传给链接器(ld)”。它会把后面的逗号替换成空格。- 所以
-Wl,--wrap,malloc 实际传给了链接器 --wrap malloc这个参数。
-
--wrap,malloc 的魔法(PPT下半部分的解释):
这个链接器参数指示链接器对符号 malloc采取一种特殊的解析策略:- 规则一:所有代码里对
malloc 的引用(Refs) ,链接器都会把它们解析为 __wrap_malloc。 - 规则二:所有代码里对
__real_malloc 的引用(Refs) ,链接器才会真正去标准库 libc 里找真正的 malloc。
- 规则一:所有代码里对
图里展示了 mymalloc.c 的代码,它完美配合了上面的链接器规则:
-
声明真身:
void *__real_malloc(size_t size);告诉编译器,有个叫
__real_malloc 的函数(它其实就是标准库里的 malloc)。 -
定义替身(Wrapper) :
void *__wrap_malloc(size_t size) {
    void *ptr = __real_malloc(size); // 调用真身
    printf("malloc(%d) = %p\n", (int)size, ptr); // 打日志
    return ptr;
}
定义了
__wrap_malloc 函数。在函数内部,它调用 __real_malloc(链接器会自动把它指向真正的 malloc),干完私活后返回。
假设主程序 int.c 里有一句 ptr = malloc(32);
-
编译阶段:
int.c 编译成 int.o。此时 int.o 里只知道“我引用了符号 malloc”。 -
链接阶段:
- 链接器处理
int.o,看到它引用了 malloc。 - 链接器看到了命令行参数
--wrap,malloc。 - 链接器心想:“按照规矩,所有对
malloc 的引用,我都必须替换成 __wrap_malloc”。 - 于是,链接器把
int.o 里的那句调用,重定位到了 mymalloc.o 里的 __wrap_malloc函数。
- 链接器处理
-
运行阶段:
- 程序执行到
malloc(32),实际上是跳进了 __wrap_malloc。 __wrap_malloc 打印日志,然后调用 __real_malloc。- 链接器之前也处理了
__real_malloc 的引用,它去标准库 libc.a / libc.so 里找到了真正的 malloc,把地址填好。 - 最终,真正的
malloc执行内存分配,并逐层返回。
- 程序执行到
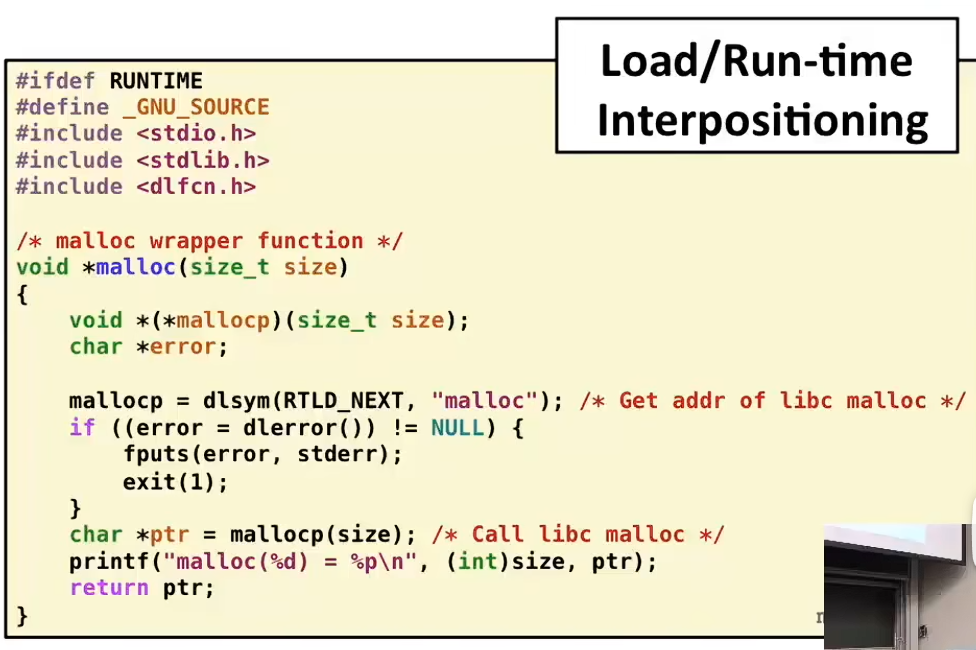
这段代码本身并不会被编译成主程序的一部分,而是被编译成一个独立的 .so 文件(比如叫 mymalloc.so)。
当你运行程序时,使用命令:
LD_PRELOAD=./mymalloc.so ./int
LD_PRELOAD 这个环境变量告诉操作系统的**动态链接器(ld-linux.so** ) :“在加载主程序 int 和标准库 libc.so 之前,先把我指定的这个 mymalloc.so 加载到内存里。”
因为链接器解析符号的顺序是从前往后,mymalloc.so 里的 malloc 就会“截胡”掉后面 libc.so 里的 malloc。主程序里调用的 malloc,实际上跳到了你的 mymalloc.so 里。
这段代码的核心在于如何实现“打桩”后,还能调用真正的 malloc:
void *malloc(size_t size) { ... }
- 注意,这里的函数名直接就叫
malloc,而不是 mymalloc 或 __wrap_malloc。这是为了在运行时无缝替换掉标准库的函数。
void *(*mallocp)(size_t size);
mallocp = dlsym(RTLD_NEXT, "malloc");
- 这是整个代码的灵魂!
dlsym我们之前讲过,是用来在动态库里找符号的。-
RTLD_NEXT 是关键:它告诉动态链接器:“别找当前这个 .so 里的 malloc (否则会死循环),去后面的库里找,也就是去 libc.so 里找真正的 malloc”。 mallocp 拿到了真正的 malloc函数地址,这就是我们的“真身”。
char *ptr = mallocp(size);
printf("malloc(%d) = %p\n", (int)size, ptr);
return ptr;
- 使用
mallocp 调用真正的 malloc分配内存。 - 打印日志。
- 返回指针。