L12 Cache Memories
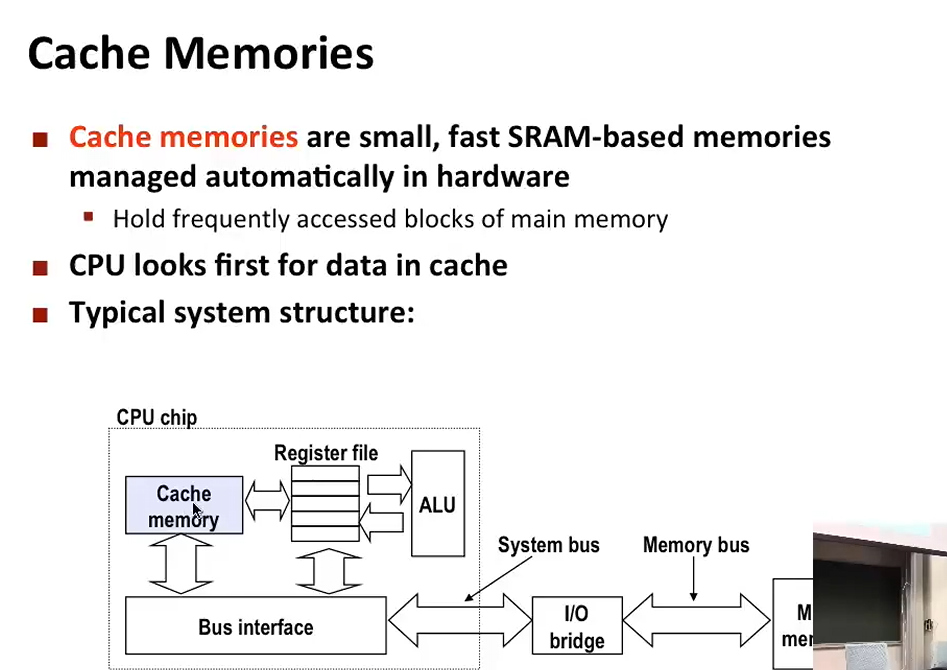
之前提到过 CacheMemory 是一种高速缓存(集成在CPU上面的 SRAM)且完全由硬件操作(与操作系统无关)
通用缓存结构模型(SEB模型):
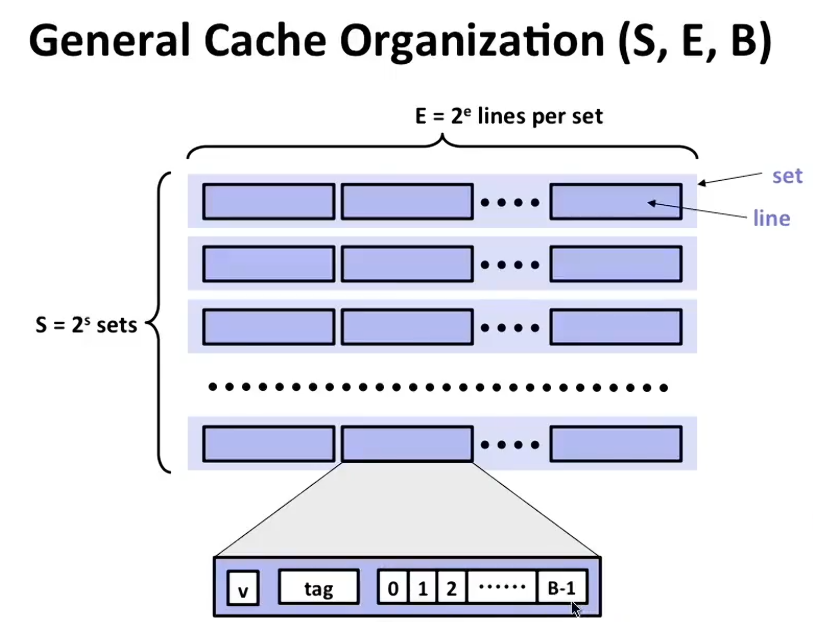
- S = 2^s (Sets) :组数。整个缓存被划分成了 S个组(Set)。
- E = 2^e (Lines per set) :每组包含的行数(Line) ,也被称为相联度(Associativity) 。图中的大括号标明了“E = 2^e lines per set”。
- B (Block size) :块大小。每一行(Line)里面实际存储的数据块大小,通常是 64 字节(也就是你之前学的“缓存行 Cache Line”)。
同时 每行中还有三个部分:
- 有效位(Valid bit) :标记这行数据是否有效。
- 标记(Tag) :用来比对地址,确认是不是你想要的那个数据。
- 数据块(Data block) :大小为 B 字节的实际数据。
总的大小就是 : S * E * B
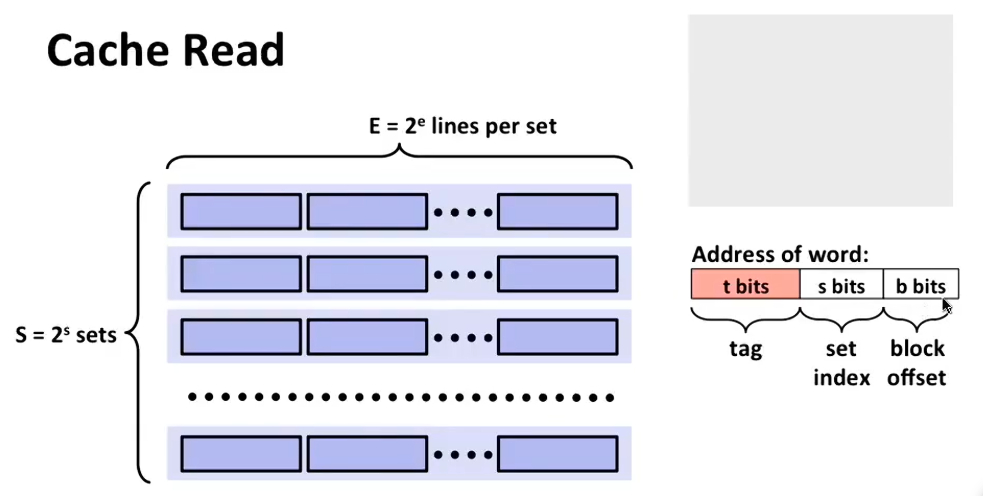
当 CPU 要访问一个内存地址时,硬件会将这个地址切分成三部分:
- 组索引(Set Index, s 位) :直接决定了这个数据必须去哪个组找。因为有 S=2^s 个组,所以需要 s 位来寻址。注意:一个内存块只能映射到唯一的一个组!
- 标记(Tag, t 位) :找到组后,组里有 E 行。硬件需要对比这 E 行的 Tag,看看哪一行的 Tag 正好匹配。如果匹配且有效位为1,就命中了。
- 块内偏移(Block Offset, b 位) :找到了对应的行后,用这 b 位在 64 字节的数据块里,精确找到你要的那个字节。
假设现在有一个8位的CPU,缓存大小是32字节,块大小为16字节,那么关联度即为2路,只有一组:
- 总大小 = 64字节
- 块大小(B)= 16字节
- 相联度(E)= 2路
- 组数(S)= 2组
那么在这里 一共2组 需要1位来进行寻址。对于16个字节,需要4位来进行寻址
那么地址就可以被拆分成
总位数 8 = 标记(t) + 组索引(s) + 块内偏移(b)
8 = t + 1 + 4 => t = 3 位
所以地址格式是: [ Tag (3位) | Set (1位) | Offset (4位) ]
物理缓存结构:
- 组0:行0, 行1
- 组1:行0, 行1
- 每一行 = 1个有效位(Valid) + 3位Tag + 16字节数据
那么现在假设有地址 0x24(二进制 0010 0100)。我们首先需要对地址进行拆分,tag就是001 set就是0 offset就是4
那么接下来 CPU去缓存里面找这个数据的时候,直接去找第0组(因为set是0),找到了0组之后就去找对应的tag标记:
- 如果恰好0组里面的两行,其中有一行的tag是001 那么直接从这一行的16字节数据块里面取出第四个字节的数据。这是缓存命中
- 如果找不到这样一个tag位001的行,CPU会去内存把地址
0x20 开始的 16 个字节全部搬到组0的某一行(假设是行0),把这行的 Tag 改成 001。随后再从这一行的 16 字节数据块里,取出第 4 个字节的数据。这是 缓存未命中
问题:为什么是从 0x20 开始的 16 字节?
因为在硬件层面,内存的读取是按块对齐的。
回头看我们的地址切分(8位地址):
[ Tag (3位) | Set (1位) | Offset (4位) ]
我们请求的地址是 0x24(二进制 0010 0100)。
把它套进格式里:
- Tag =
001 - Set =
0 - Offset =
0100(十进制4)
关键点来了:Offset 是 4 位,能表示 0~15 共 16 个字节。它决定了你要的数据在 16 字节块里的精确偏移。
但是,当你从内存把整个块搬运到缓存时,你不可能只搬 Offset 为 4 的那个字节。你必须搬运整个 16 字节的块(Block) 。
为了把这个 16 字节的块找出来,硬件需要知道它的起始地址。起始地址的算法很简单:把偏移量(低4位)全部清零。
0x24(0010 0100)把低4位清零,就变成了 0x20(0010 0000)。
所以,内存块是从 0x20 开始的,一直到 0x2F(共16个字节)。CPU实际上在底层总线上的操作是:“把 0x20 到 0x2F 这段连续的内存块,全部给我拉过来!”
你可能觉得“一次取1个字节放到寄存器”听起来很小气。实际上,现代64位CPU的数据总线宽度通常是64位(8字节)或更宽。
- 如果你在C语言里定义
long x = 0;,CPU会执行一条8字节的读取指令,一次性从缓存里拿走 8 个字节塞进寄存器。 - 如果你定义
char c = 'A';,CPU才会只拿1个字节(因为程序只要求处理1个字节)。 - 甚至在处理AVX2向量指令时,CPU会执行
vmovdqu,一次性从缓存拿走 32 个字节塞进 YMM 寄存器。
总结
- 内存到缓存:像搬家一样,为了效率,必须整箱(16字节、64字节)搬。
- 缓存到CPU:像取快递,你需要多少就拿多少(1字节、4字节、8字节)。
- 这两者的完美配合,加上空间局部性,才让你那 4 个时钟周期的缓存读取发挥出了 100 个周期内存读取都达不到的性能优势。
缓存又可以根据具体的分布,分为以下三类:
- 直接映射(Direct Mapped, E=1) :每个组恰好有一行。内存块严格映射到一个特定的缓存行。如果两个块映射到同一行,它们就会反复驱逐对方(冲突未命中)。
- 组相联(Set Associative, 1 < E < S) :每个组有 E 行(例如,2路、4路、8路、16路)。内存块映射到一个特定的组,但可以放置在组内的任何一行。这减少了冲突未命中。
- 全相联(Fully Associative, E=S) :只有一个组。内存块可以放置在缓存中的任何位置。需要比较所有行的标签。硬件复杂且昂贵,但消除了冲突未命中。
刚才的这些都是内存读取,那么如何写回内存呢?这里有两种方案:
方案一:Write-through(直写法)
- 做法:每次 CPU 修改 L1 缓存,硬件立刻、同步地把新数据写入 L2、L3,最终写入主存。
- 缺点:太慢了。主存的延迟是 100 个周期,如果每次写个变量都要等主存,CPU 的性能会被严重拖垮。
- 优点:实现简单,主存里的数据永远是最新的。
方案二:Write-back(写回法)—— 现代CPU的绝对主流
-
做法:CPU 修改数据时,只修改 L1 缓存里的内容,根本不管主存。那么,怎么保证最终一致性呢?靠 “脏位(Dirty Bit)” 。
-
“脏位”是什么意思?
缓存行里不仅有数据、Tag,还有一个额外的比特叫做脏位。- 当 L1 里的数据被修改时,硬件把这个缓存行的脏位置为
1,表示“我变脏了,我和主存不一样了”。 - 之后如果 CPU 又要写这个数据,继续改 L1,脏位保持
1。 - 关键点来了:只有当这行缓存因为容量满了或者冲突,要被踢出(Replacement/Eviction)时,硬件才检查脏位。如果是
1,就把修改过的数据一次性写回下一级缓存(L2),最终写回主存。 - 如果这行缓存被踢出时,脏位是
0(表示没改过),那就直接扔掉,不需要写回,省了一次内存操作。
- 当 L1 里的数据被修改时,硬件把这个缓存行的脏位置为
但是,之前提到过,一些长期不使用的缓存行会被踢出,但是假设现在要给一个内存中的数据重新赋值,怎么办?所以缓存的写入也分为hit和miss,针对写入未命中,CPU有两种策略:
策略一:写分配(Write Allocate)
这是现代CPU(如Haswell)最常用的策略,通常和写回法(Write-back) 搭配使用。
完整流程:
- CPU 要写
x = 5,发现 x 不在缓存里(Write Miss)。 - CPU 向主存请求
x 所在的整个内存块(比如64字节) 。 - 把内存块拉进 L1 缓存(分配缓存行),此时它还是旧的。
- CPU 在缓存里修改
x的值为 5。 - 把这一行的脏位(Dirty Bit)置为 1。
- 之后,当这一行需要被踢出(Eviction)时,硬件检查脏位,发现是1,把它写回下一级缓存或主存。
为什么要这么做(拉上来再改)?
这完美利用了空间局部性。虽然你只想写 x 这一个变量,但程序往往紧接着会写相邻的 y、z。既然未来大概率要用这块数据,不如现在就把整个块拉上来,一劳永逸。
策略二:非写分配(No-Write Allocate / Write Around)—— 绕过缓存
有些情况下,CPU 不拉取数据,而是直接往内存里写。
完整流程:
- CPU 要写
x = 5,发现 x 不在缓存里(Write Miss)。 - CPU 不把内存块拉进缓存,而是直接把这个写操作发送到下一级缓存,最终写入主存。
- 只有当你后面真正去读
x 的时候,才会发生读未命中(Read Miss),这时才把数据拉进缓存。
为什么要这么做?
想象一个流式写入的场景(比如往内存里写一段巨大的视频数据,写一次就永远不用了)。如果每次都“拉上来再改”,缓存会被这些“用过即扔”的数据瞬间填满(这叫做缓存污染 Cache Pollution),把其他有用的热点数据挤出去。
因此,非写分配通常和直写法(Write-through) 搭配使用。既然数据直接用完就不用了,就没必要在缓存里占个坑。
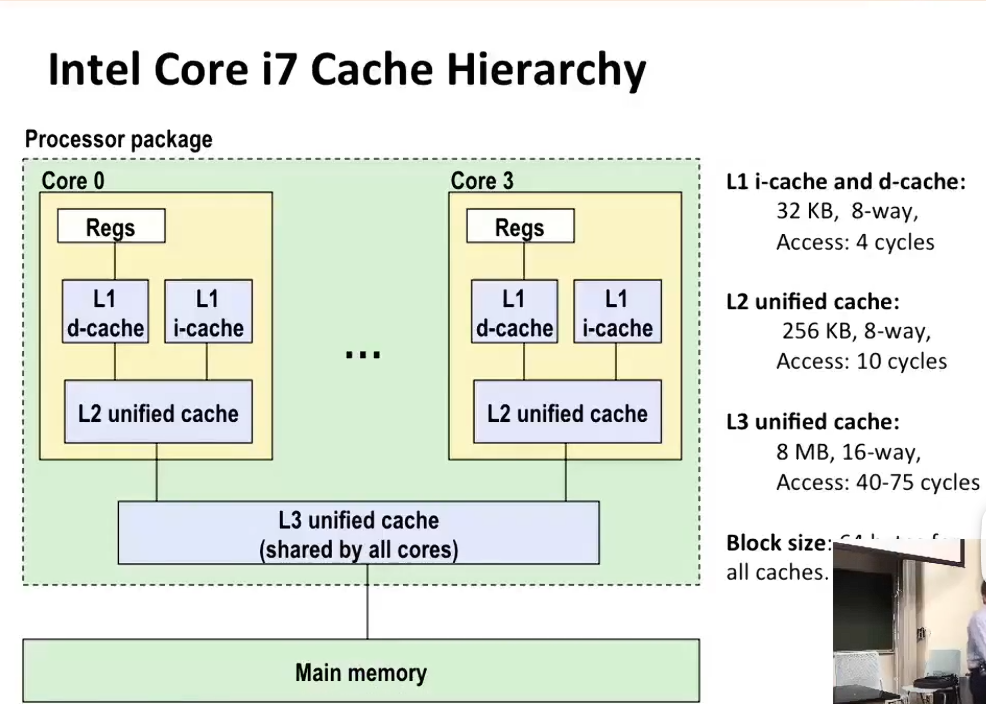
- L1 缓存:每个核心绝对私有。
由于 L1 极快(4个周期),它必须紧挨着 CPU 核心。每个核心通常有两个 L1:L1i(指令缓存,比如 32KB)和 L1d(数据缓存,比如 32KB)。两个核心之间完全看不见对方的 L1 数据(除非通过缓存一致性协议同步)。 - L2 缓存:每个核心绝对私有。
L2 通常比较大(比如 256KB 到 2MB),但依然紧挨着核心。每一个核心都有自己独立的 L2,速度比 L1 稍慢,但容量更大。 - L3 缓存:所有核心共享(Shared)。
L3 通常是一个巨大的缓存池(比如 16MB、32MB 甚至 128MB)。它被划分成多个“切片(Slices)”,通过片上环形总线(Ring Bus)或 Infinity Fabric 连接。所有核心都可以访问整个 L3,但访问不同切片的速度可能会有微小差异。
为什么这样设计?
- L1/L2 私有:因为距离近,延迟极低。如果 L1 共享,多个核心同时抢一个 L1,会导致严重的性能灾难(就像十字路口没有红绿灯)。
- L3 共享:为了数据共享和进程迁移。如果两个核心(运行同一个进程的不同线程)需要共享同一块数据,它们可以在 L3 里找到。如果没有共享 L3,一个线程修改了数据,必须写回主存,另一个线程再从主存读,延迟极高。
缓存的性能表现可以由下面三个维度来评估:
-
缓存未命中率
对于L1缓存来说通常是10%
对于L2来说可能非常小,具体取决于缓存大小
-
hit到缓存用的时间
包含:处理器发出指令到实际到达缓存的时间,以及明确缓存在哪里的时间
常见的时间:
- L1缓存需要4个时钟周期
- L2缓存需要10个时钟周期
-
缓存未命中时消耗的时间:
通常是50-200时钟周期
实际上 99%的缓存命中率的性能时 97%的两倍
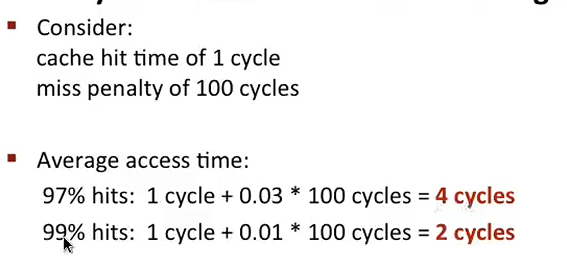
那么,如何编写缓存友好的代码呢?
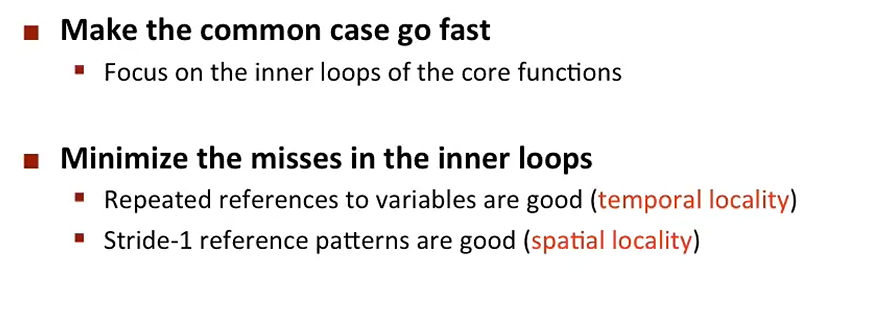
策略一:Make the common case go fast(让常见情况变快)
- 幻灯片细节:Focus on the inner loops of the core functions(关注核心函数的内部循环)。
- 背后的原理:根据程序的局部性,程序 90% 的时间都花在了 10% 的代码上,而这 10% 中绝大多数是内层循环(Inner Loops) 。
- 结合你的经验:你之前看的“2×2循环展开”、“Haswell CPU的流水线”、“AVX2向量化”,全都是针对内层循环在做文章。因为只要内层循环的代码在 L1 缓存里(指令局部性),数据在寄存器里(时间局部性),CPU的乱序执行引擎就能疯狂并行。优化外层代码(比如初始化变量)对性能毫无意义,纯属浪费时间。
策略二:Minimize the misses in the inner loops(最小化内层循环的未命中)
这是整张幻灯片的核心。它给出了两个非常具体的编程准则:
1. “Repeated references to variables are good (temporal locality)” —— 重复引用变量是好的(时间局部性)
- 通俗理解:在内层循环里,尽量反复使用同一个变量(比如
sum、i、临时指针)。 - 硬件原因:因为这些变量会被编译器直接放进寄存器(0周期),或者至少稳稳留在 L1 缓存(4周期)。如果内层循环里出现很多“只用一次”的变量,它们会不断挤占缓存行(发生容量未命中),甚至需要去主存取(100周期)。
- 编程实操:把循环外能算好、内层循环里一直用不变的值提取出来(之前讲过循环不变量外提),或者在循环里写
x += a[i]而不是反复去读写全局变量。
2. “Stride-1 reference patterns are good (spatial locality)” —— 步长为1的引用模式是好的(空间局部性)
- 通俗理解:在内层循环里,访问内存的步长最好是 1(连续访问) ,比如
a[i], a[i+1], a[i+2]。 - 硬件原因:还记得 64 字节的缓存行(Cache Line) 吗?如果你步长为1,你读
a[0] 时,缓存会把 a[1] 到 a[15]全拉进来。后面 15 次访问全部“秒中”缓存(命中)。 - 反面教材(即之前我们讨论过的多维数组陷阱) :如果在内层循环里做
a[i][j] 且 j 是内层循环,而数组是行优先存储的,那么每次 j++ 实际内存地址跳跃了 N*4 个字节。这会导致跨步引用(Stride-N) ,每次访问都会发生缓存未命中,缓存行被严重浪费,性能暴跌几十倍。
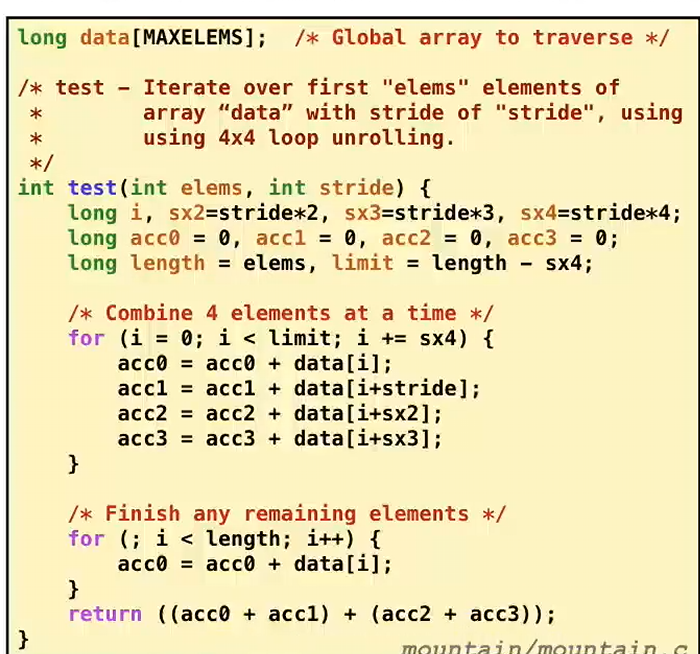
存储器山(The Memory Mountain)用来可视化 “程序的内存访问模式” 与 “计算机存储层次结构” 之间的博弈。这座“山”的高度,代表了 CPU 读取内存的吞吐量(Throughput,单位是 MB/s) 。
它有两个水平坐标轴和一个垂直坐标轴(山峰高度):
- X轴:步长(Stride) —— 决定空间局部性。
- Y轴:工作集大小(Elems,即数组长度) —— 决定时间局部性和缓存容量溢出情况。
- Z轴(高度):读取吞吐量 —— 代表性能。
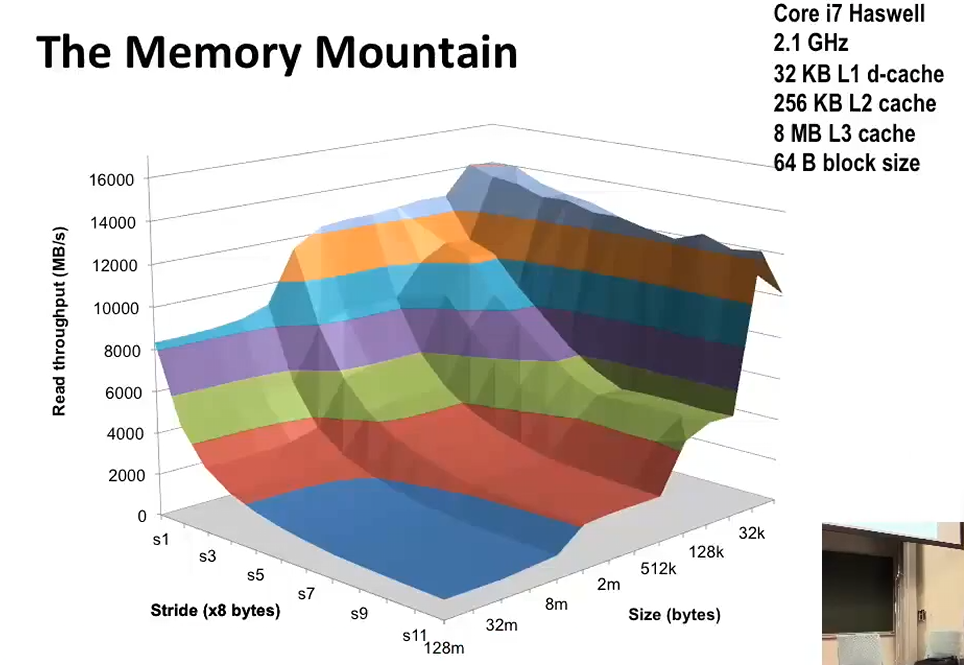
不同的区域代表了不通的缓存/内存范围 从上到下依次为 L1 L2 L3 DRAM
山巅(左上角:s1,极小的 Size)
- 当
stride = 1(连续访问)且数组小于 32KB 时,整个数组可以完美塞进 L1 缓存。 - 空间局部性拉满(每次拉取一个 64B 缓存行能用8次),时间局部性拉满(反复重用 L1 里的数据)。
- 吞吐量达到最高峰(约 14000~16000 MB/s),这是 CPU 硬件的极限速度。
三级台阶(沿着 s1 轴,向大 Size 走)
你会看到图中的山体不是平滑下落的,而是有明显的断崖/台阶。这些台阶精准对应了缓存容量的溢出:
- 第一个陡坡(> 32KB) :数据溢出了 L1,只能去 L2 找。吞吐量下降一截。
- 第二个陡坡(> 256KB) :L2 也装不下了,去 L3 找。吞吐量继续下降。
- 第三个陡坡(> 8MB) :L3 全面崩溃,数据只能去主存(DRAM)捞。此时吞吐量直接跌入谷底(几千 MB/s)。这就是经典的内存墙(Memory Wall) 。
悬崖(沿着 Size 轴,向大步长走)
随着步长 stride 变大(s3, s5, s7… s11):
- 哪怕你的数组很小(比如就在 L1 里),如果你每次跳跃 88 字节(s11)去读,由于 88 > 64(缓存行大小),你每次访问都会拉取一个新的缓存行,且只用其中 8 个字节,剩下的 56 字节全浪费了。
- 空间局部性完全被摧毁,缓存命中率暴跌。你能看到图右侧向着大步长方向形成了一道“悬崖”,吞吐量陡降。
地狱深渊(右下角:大步长 + 大 Size)
- 这是最惨的状态:数组大得装不下(去 DRAM),步长又大得离谱(每次读取都跨越缓存行)。
- 这相当于每次读一个数据都要去主存跑一趟。吞吐量直接跌到最低点(接近 1000~2000 MB/s),形成了图右下角的红色/蓝色低谷。
可以通过改善程序的空间/时间局部性来提升内存读写效率,之前提到过
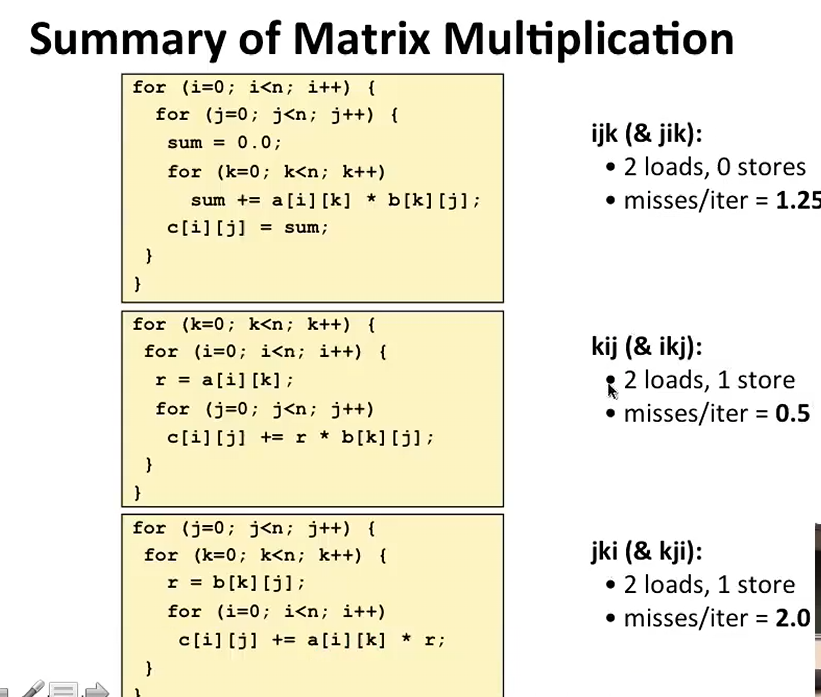
上述例子改善了空间局部性,对于改善时间局部性,我们使用一种叫做“分块”的技术:
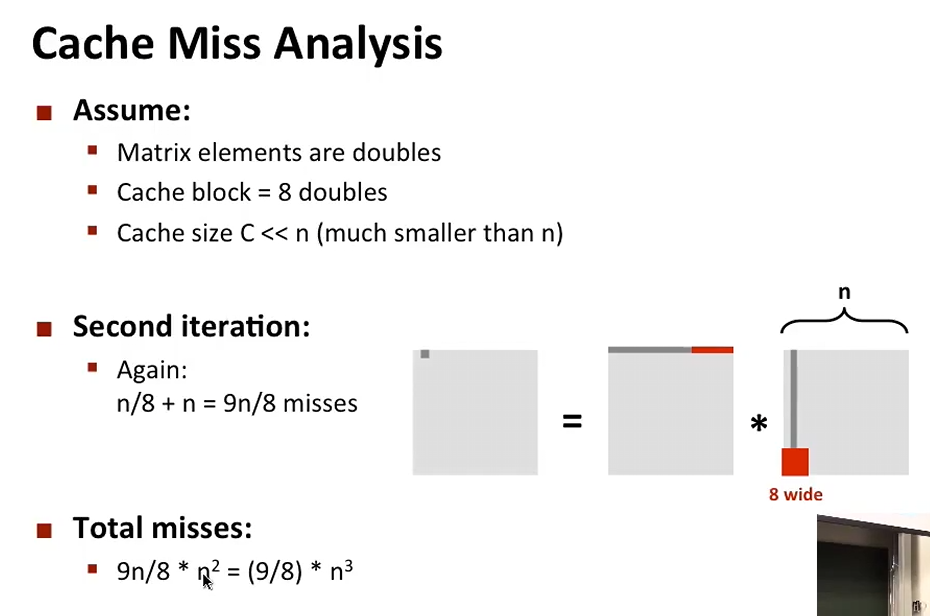
在这个例子中,为了运算矩阵,A 的行利用好了空间局部性(步长1),B 的列完全破坏了空间局部性(步长n)。并且缓存块一次只拉 8 个 double,B 列的访问让缓存行利用率只有 1/8,大量带宽被浪费,直接撞上“内存墙”。
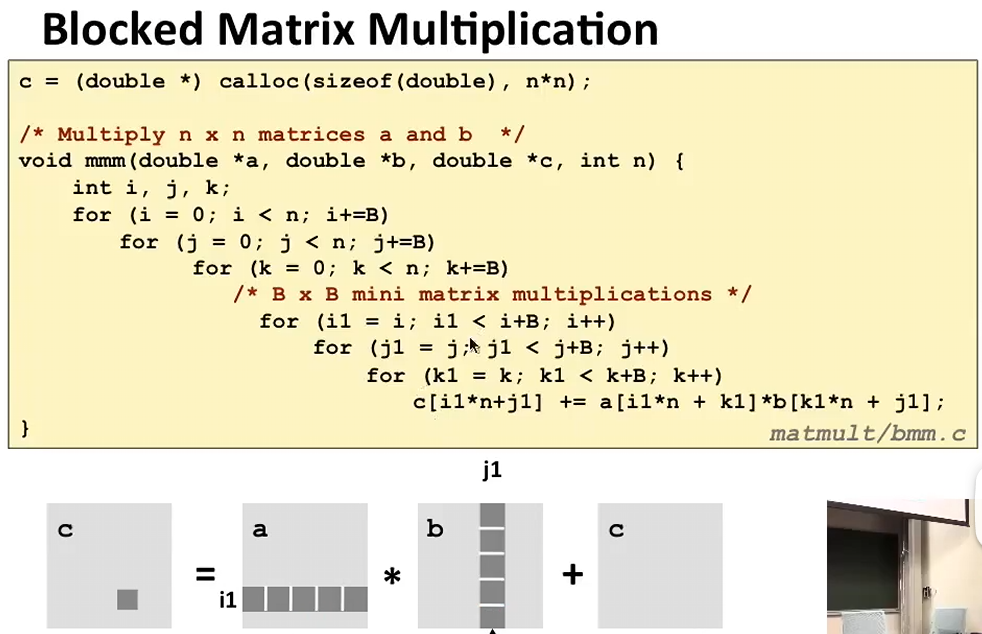
1. 代码逻辑拆解:从“大循环”到“小循环”
这段代码最核心的变化,就是把普通的 i, j, k 三层循环,变成了六层嵌套循环(i, j, k 外层,i1, j1, k1 内层)。
- 外层三个循环(
i, j, k ) :
每次跳跃 B 步(i += B)。它们负责在宏观层面上定位一个个大小为 B x B 的子矩阵块。 - 内层三个循环(
i1, j1, k1 ) :
它们负责在微观层面上,完成一个 B x B 的小块矩阵乘法。 - 核心计算语句:
c[i1*n+j1] += a[i1*n + k1]*b[k1*n + j1];
注意这里面的 a 和 b 的下标:a 用的是 i1 * n + k1,b 用的是 k1 * n + j1。这意味着,在内层循环中, a 是连续按行访问的(步长为1,空间局部性好), b 也是连续按行访问的(步长为1,空间局部性好) 。
2. 图解的力量:为什么这么切就快了?
看下半部分的图解:
-
c 的当前块:也就是正在被计算的 B x B结果块。 -
a 的当前行块:一个 1 x B的行块,连续存储在内存中。 -
b 的当前列块:一个 B x 1 的列块(其实就是 B x B子矩阵的一部分)。
传统的按列遍历 B:每次只能命中缓存块 8 个 double 中的 1 个。
现在的分块乘法:
把 a、b、c 分成 B x B 的小块,只要块大小 B 选得合适,这三个小矩阵块就能同时塞进 L1 或 L2 缓存。
当 CPU 在内层循环计算 B x B 个小块时,它反复读取这几个小矩阵块里的数据(时间局部性),而且访问模式大多是步长为 1 的连续访问(空间局部性)。这完美避开了内存墙,让缓存行得到了 100% 的利用率。
3. 分块大小 B 是多少?(极其重要)
代码里没有写死 B 是多少。在实际工程中,B 通常取 8、16、32 等数值。
- 为什么不能太小?如果
B=2,那么 2x2 的小块太小,循环控制指令(i++, j++, k++)的开销会远大于真正干活的乘法指令。 - 为什么不能太大?如果
B=1000,那三个 1000 x 1000的小块总大小(1000×1000×8 bytes×31000×1000×8 bytes×3)远超 L1 缓存(几十KB),分块就失败了,又会掉回“内存墙”。 - 黄金法则:
B 的大小要保证 (3 * B * B * sizeof(double))能够完全塞进目标缓存层级(通常是 L1 或 L2)。