L14 Exceptional Control Flow: Exceptions and Processes
计算机执行的指令序列被称作 控制流。硬件正在执行的实际指令序列被称为 物理控制流。
通常,此控制流在你内存中按顺序执行单条指令。
我们现在有两种手段来修改控制流:
- 跳转和分支
- 调用和返回
但是这些都是程序级别的状态。对于操作系统来说,需要能够处理系统级别的变化,比如碰到通信中断,或者按了了CtrlC,因此我们需要一场控制流(ECF),这存在于计算机系统的所有等级中(无论是硬件还是软件)。
- 底层的机制——异常:响应系统时间二发生的控制流改变,计算机硬件和操作系统的组合
- 高层次机制:1. 进程上下文切换 2. 信号 3. 非局部转跳
异常:响应某些事件(即处理器状态改变)而将控制权转移给操作系统内核。(内核,是操作系统的内存驻留部分)
这些事件可以触发异常:除0,算数溢出,内存页错误,IO请求完成,输入了 Ctrl-C
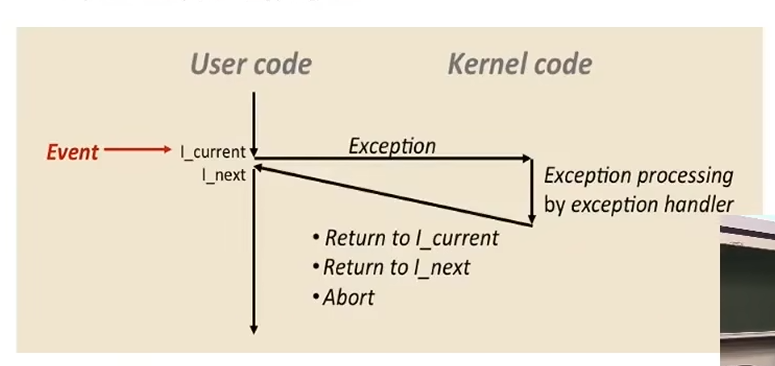
这张图就展示了,当用户代码触发异常时,内核如何响应
之前说过,异常处理是由硬件和软件(操作系统)共同完成的。检测异常依靠事件,每种事件都有一个唯一的“异常编号”,用作转跳表的缩影,被称作“异常表”:
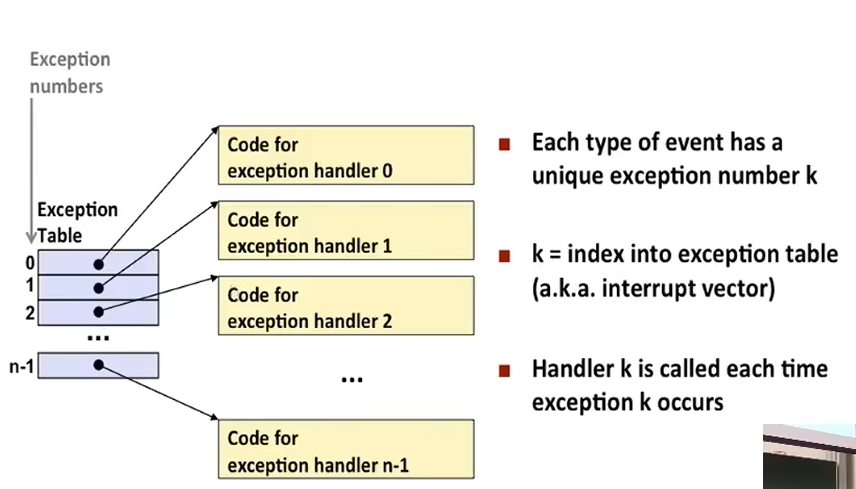
异常处理可分为两类:异步和同步。其中异步异常时由于处理器外部发生状态变化而引起的,这些被称作中断(CPU上有直接的中断引脚,也就是完成DMA操作的手段,需要色湖之中断引脚来通知处理器已经完成复制)。当发生中断时,程序会返回到下一条指令。
最常见的异步中断例子:
-
时定时器中断:计算机中存在一个硬件计时器,在操作系统启动的时候会初始化这个硬件。在程序运行的过程中,每隔几毫秒就会触发一次,当定时器被触发,他将中断引脚设为高电平,随后内核中有一个特殊的异常编号来对此进行处理。
-
来自设备的I/O中断:比如,在键盘按下ctrl+C,设备从网络中接收到了包,设备从硬盘中获取到了数据
同步异常也有三类:
-
陷阱,是故意设置的异常:
比如:system calls(应用程序调用内核提供的接口,但是是将程序控制权转移到内核),断点,特殊指令
-
故障,是无意设置,但是可能是可以恢复的:
缺页故障(Page Fault,可恢复):程序访问了一个虚拟内存地址,但该地址对应的数据目前还在硬盘上,不在物理内存中。硬件触发 Fault,操作系统介入,把数据从硬盘加载到内存,然后重新执行刚才那条引发故障的指令。程序对此毫无感知,继续运行。
保护故障(Protection Fault,不可恢复):程序试图访问不属于它的内存(比如越界访问),或者试图执行特权指令。操作系统发现这是非法操作,无法修复,通常会直接杀死这个进程(比如报 "Segmentation fault")。
浮点异常(Floating point exception):除0,浮点数溢出。
-
终止,是无意设置且不可恢复的异常:
非法指令,内存存在问题,那么就会被触发
system calls: 在x86-64中每一个system call都有一个独特的ID
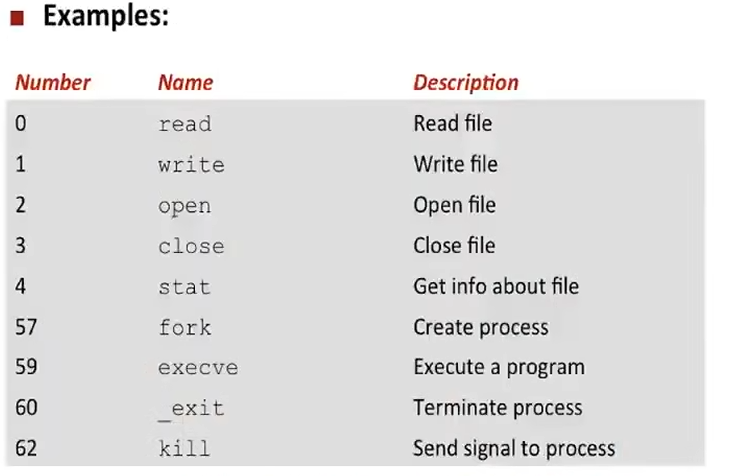
如果进入到汇编层面,能看syscall 指令,这是调用System Call的经典类型:
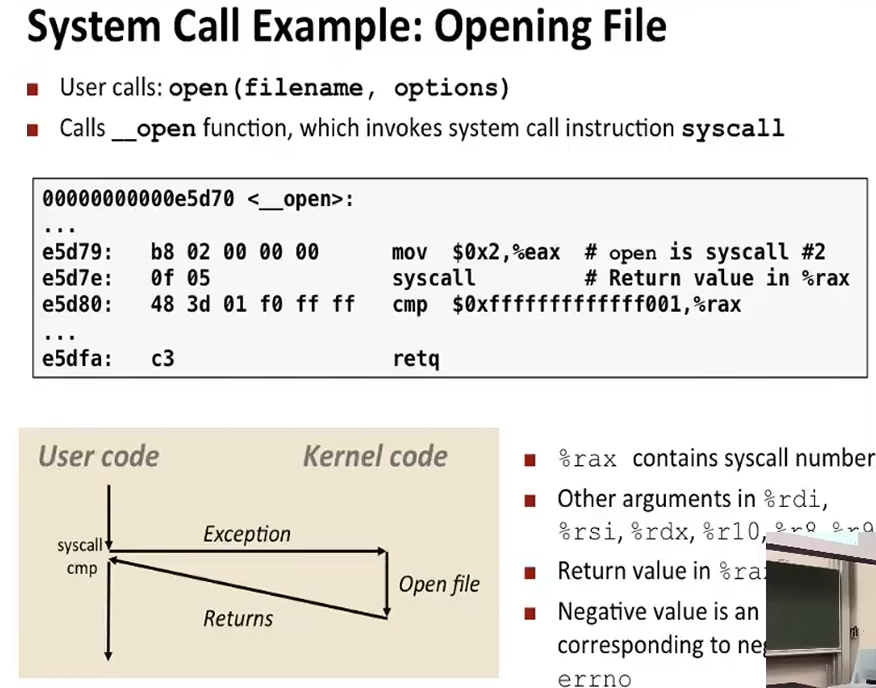
在这个调用过程中:syscall会从%rax中读取指令码,在内核处理完之后,把结果放回到 %rax。如果rax返回了负数,那么对应着错误。
这个syscall就完成了用户态到内核态的交互,用户态调用syscall(这个内核提供出来的接口),随机系统创建同步异常,内核完成业务之后,会将结果进行比较。再将结果返回
内存页缺失:
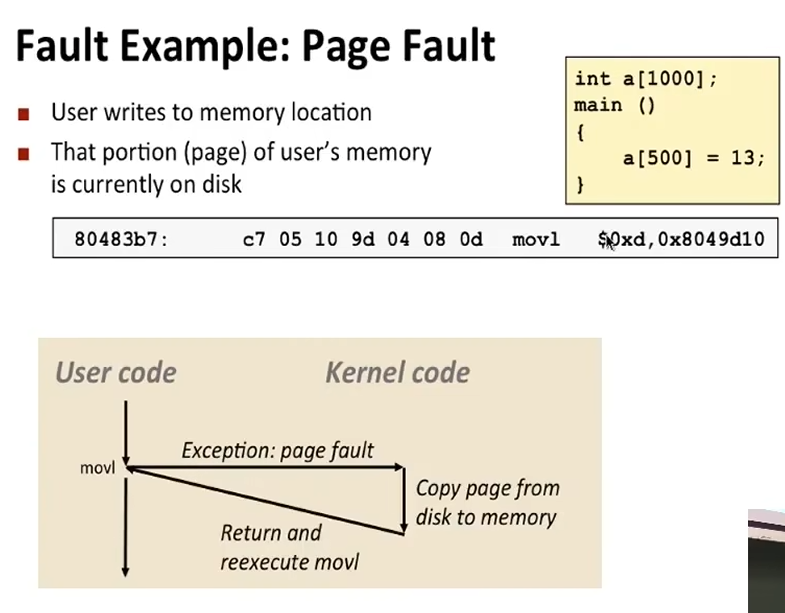
当执行movl时,CPU 内部的内存管理单元(MMU)发现这个地址 0x8049d10 不在内存当中,就会发生页缺失,随后内核将磁盘中的数据拷贝到内存中,随后返回结果,用户态再执行movl
无效内存访问:
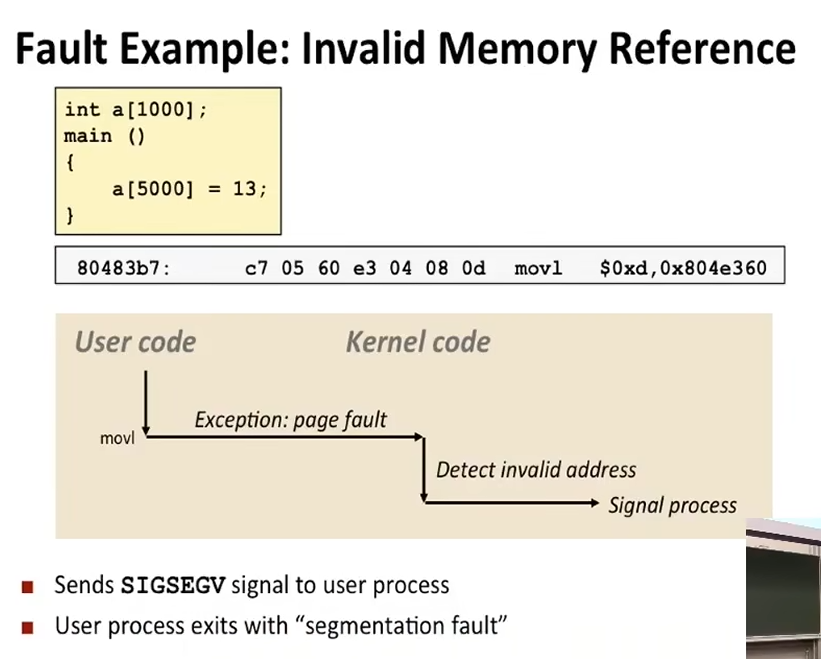
当movl尝试向内存 0x804e360 写入的时候,CPU 内部的内存管理单元(MMU)首先发现这个地址不在内存中,会发出内存页缺失的错误(同步异常,缺页异常),随后,程序的控制权限被从用户态转移到了内核态,内核会尝试加载这片内存,但是发现这个地址是非法的,于是直接发出错误信号,返回Segmentation Fault
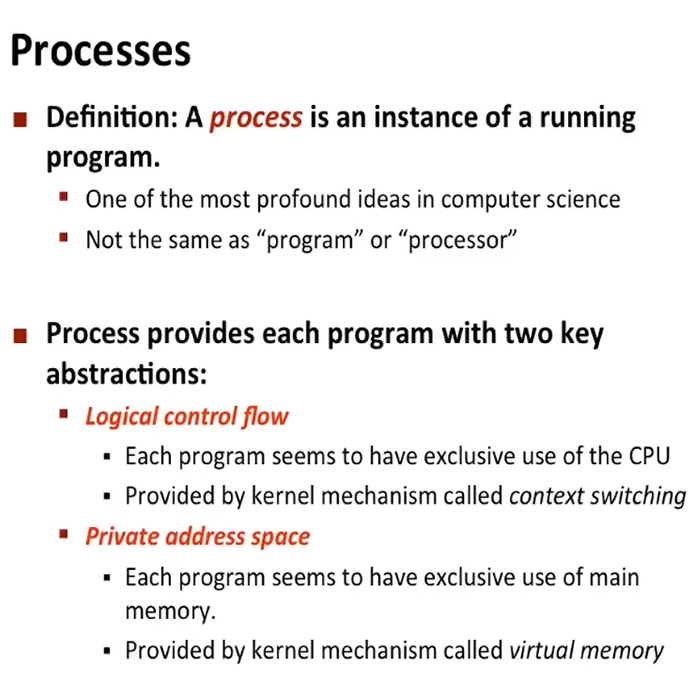
进程,是正在运行的程序的实例。程序提供了两个抽象:
- 程序看似完全占有CPU——这依靠 上下文切换 来完成
- 程序看似完全占有所有内存——这依靠 虚拟内存 来实现
系统同时运行了多个进程,即使可能运行操作系统的是个单核CPU也是如此。
上下文切换,是这样完成的:
-
定时器中断(硬件触发) :假设你的程序正在 CPU 上狂奔。突然,每 1ms 一次的定时器中断响了(异步异常)。
-
陷入内核(控制流转移) :CPU 暂停你的程序,保存当前寄存器状态(上下文),跳转到内核的调度器。
-
上下文切换(内核操作) :内核一看,“哦,你(进程 A)的时间片用完了。该换进程 B 上了。”
- 内核把进程 A 的寄存器状态(PC、栈指针等)保存到内存中的进程控制块(PCB)。
- 内核把进程 B 之前保存的寄存器状态从 PCB 恢复到 CPU 寄存器中。
-
返回用户态:CPU 恢复执行,但此时执行的不再是你的程序,而是进程 B。
即便是现代的多核心CPU,也高度依赖上下文切换,操作系统将在这些多核上安排进程
我们认为,每个进程代表一个“逻辑控制流”。如果两个进程的控制流在时间上发生重叠,那么他们就是并发运行的。否则就是顺序执行:
例如,下面的例子中,单核CPU运行了下列三个进程:
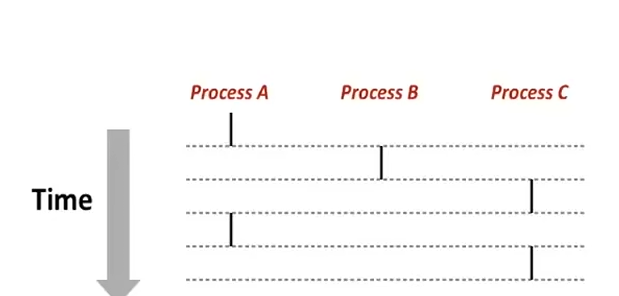
那么我们就可以说 ABC 三个进程是并发(Concurrent)的。
当然,上面这些都是对操作系统来说。因为实际上每次上下文切换的时间非常短,用户无法察觉,所以在用户看来是这样的:
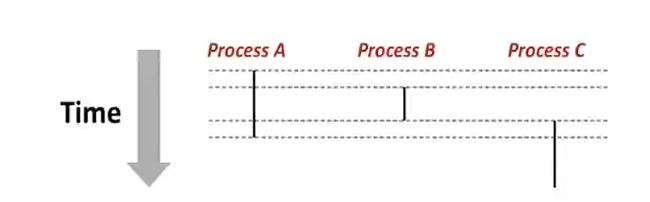
因此,我们可以认为他们是相互“并行”的
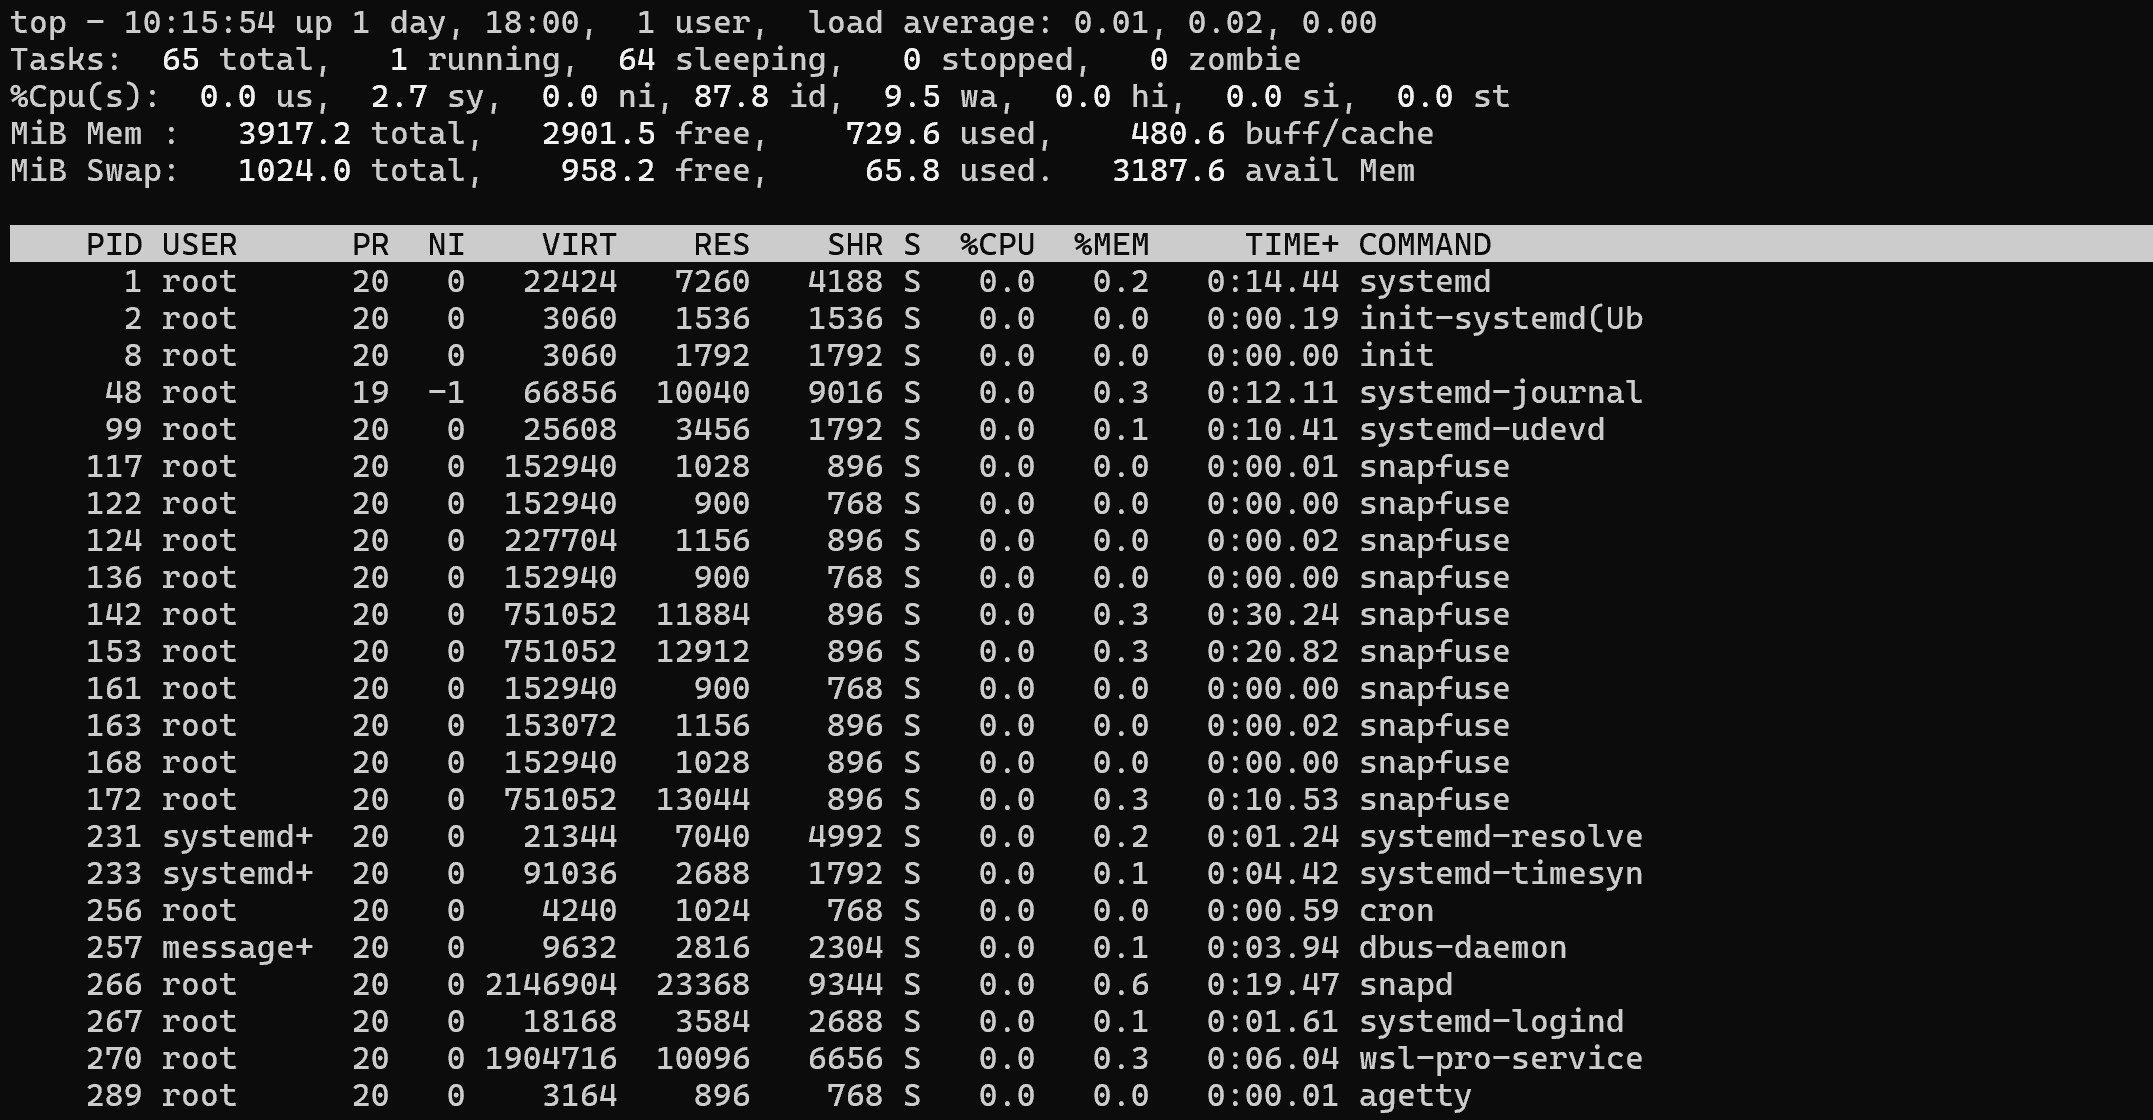
内核不是一个独立的进程。本质上是一大堆常驻在内存里的代码和数据,它运行在 CPU 的最高特权级(Ring 0 / 内核态) 。
它不是一个被操作系统调度器(Scheduler)调度的“任务(Task)”。你在 top 或任务管理器里看到的进程列表,全都是用户态的程序,你永远找不到一个叫“kernel”的 PID。
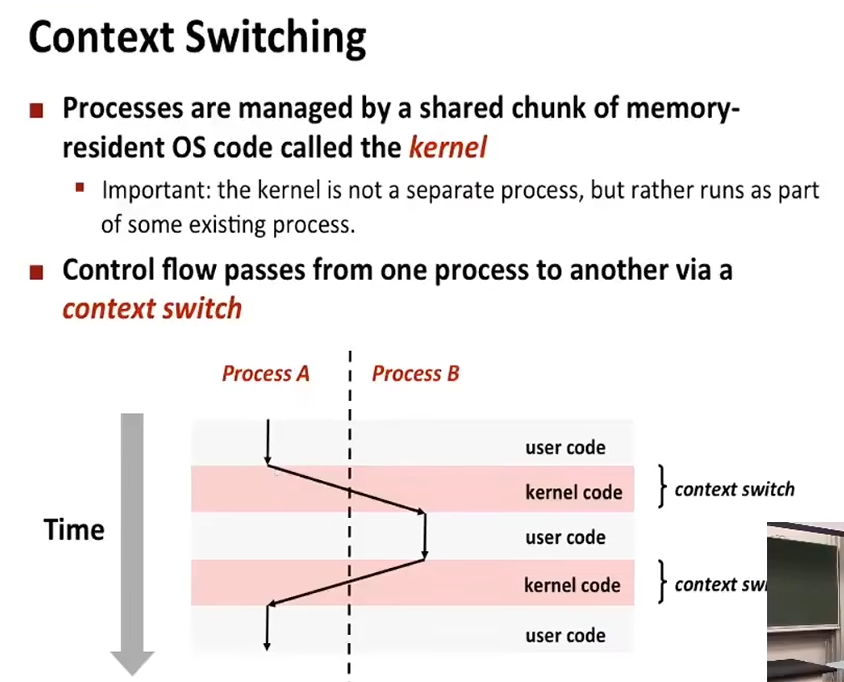
上图展示了上下文切换的流程
Linux提供了很多函数,用于从用户程序来操作进程。这个操作的过程我们成为进程控制。
现代linux操作系统在程序运行遇到错误的时候通常返回-1,并且用一个全局的errno 来指示原因。
当我们使用系统级别的函数时,必须检查返回值,用来判断是成功了还是失败了。只有那些void类型的函数不需要检查
例如下面的程序:
if ((pid = fork()) < 0) {  // 1. 调用 fork(),并将返回值赋给 pid。这里的fork只是syscall的封装
                           // 2. 立刻检查:如果返回值 < 0(即 -1),说明 fork 失败了
    fprintf(stderr, "fork error: %s\n", strerror(errno)); // 3. 打印错误信息
    exit(0);               // 4. 终止程序(或者进行其他错误处理)
}
可以用下面的手段来简化输出报错的编写:
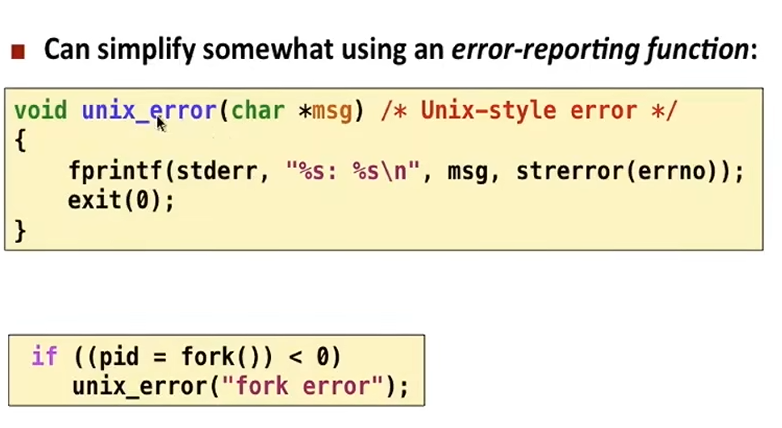
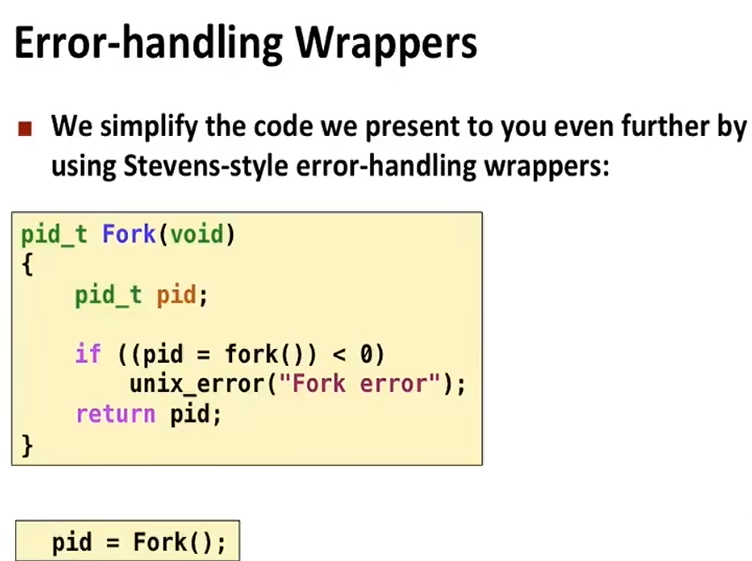
在C语言中,我们有这些方法来获得PID:
pid_t getpid(void) //返回当前进程的PID
pid_t getppid(void) //返回当前进程的父进程的PID
经典例子:
你在终端里运行一个程序,这个程序的父进程通常就是你的 Shell(比如 bash)。
printf("My PID is %d, my parent PID is %d\n", getpid(), getppid());
如果输出 My PID is 1234, my parent PID is 1000,说明你的程序 PID 是 1234,而启动它的那个终端 Shell 的 PID 是 1000。
Linux也提供了创建和终止进程的方法,我们可以将程序看作有下列三种状态:
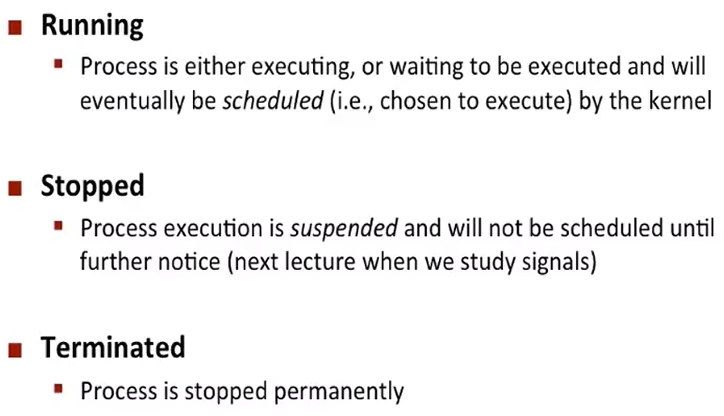
程序会因为下列三种原因被终止(Terminated):
-
收到了终止信号
-
从main 函数中return出去了
-
call了 exit函数
但是 一旦 exit 被执行,就不会有任何返回值。当程序调用exit时,会触发一个syscall,将程序权限移交内核,回收该进程的所有资源,随后摧毁该进程
同样,进程可以被创建,父进程可以通过调用fork()来创建子进程:
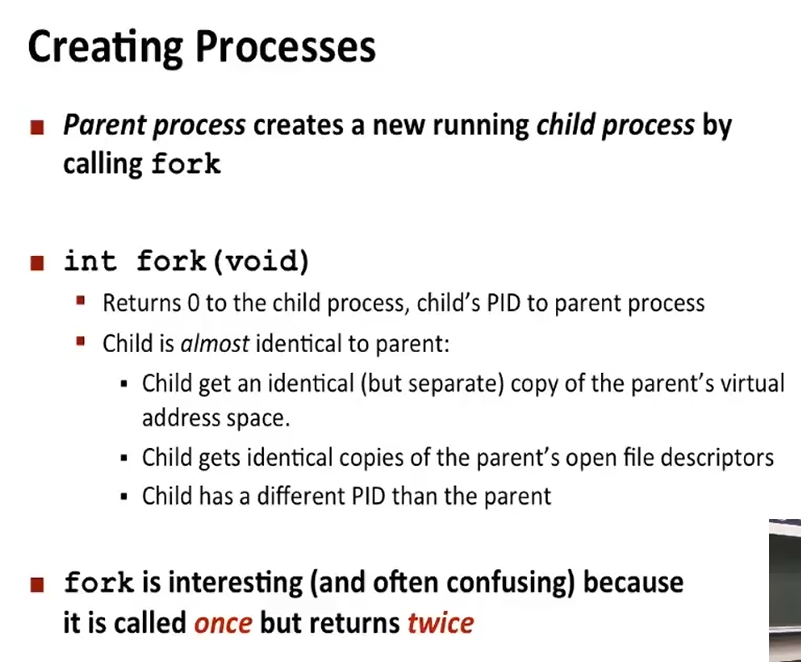
fork是无参调用,会返回一个整数且创建新的进程。他会在父进程和子进程分别返回。对于子进程会返回0,对于父进程会返回子进程的PID。
子进程获得一份独立的父进程虚拟地址空间副本,子进程的一切(包括,变量,全局变量,堆,栈)都和父进程完全相同。子进程获得父进程打开文件描述符的相同副本——子进程可以访问任何已打开的文件,包括父进程拥有的标准输入和输出,唯一的区别的就是PID不同
子进程并不是从 main 函数的第一行开始执行的,而是从 fork() 调用的那一刻“接着”往下执行的。
更详细的解释:
1. 为什么说 "Called once but returns twice"(调用一次,返回两次)?
这是 fork() 最神奇的地方。
- 当父进程执行到
fork()时,它调用了内核的系统调用。 - 内核在底层做了一件事:完全复制了父进程的上下文(包括页表、寄存器等),生成了一个子进程。
- 当内核准备从系统调用返回时,它有两个进程要返回:父进程和子进程。
- 所以,这一行代码在父进程里执行了一遍,在子进程里也执行了一遍。这就是“返回两次”的物理含义。
2. 为什么返回值不一样?(如何区分父子进程)
因为底层复制出来的两个进程在物理内存中是独立的。内核在设置返回值时:
- 给父进程:返回子进程的 PID(大于 0)。父进程需要这个 ID 来管理子进程。
- 给子进程:返回 0。子进程可以通过
getppid()找到父进程。 - 出错:返回 -1(这就是你之前看那张幻灯片时,为什么要写
if ((pid = fork()) < 0)的原因)。
3. 最硬核的知识点:“独立的虚拟地址空间副本”
图片下方的中文说:“子进程获得一份独立的父进程虚拟地址空间副本,子进程的一切都和父进程完全相同”。
这里其实隐藏了现代操作系统的精髓——写时复制(Copy-On-Write,COW) 。
- 理论上是“独立副本” :子进程有一套自己的虚拟地址空间,逻辑上它拥有父进程内存里的所有数据(全局变量、堆、栈)。
- 物理上的“偷懒” :在
fork() 刚执行完的那一刻,内核并没有真的把父进程的所有内存数据拷贝一份给子进程(那样太慢了)。内核只是把子进程的页表指向了父进程的物理内存页,并把这块内存标记为“只读” 。 - 只有当“写”发生时才复制:如果父进程或子进程试图修改内存里的一个变量,CPU 会触发一个写保护异常(同步异常/Fault) 。此时内核介入,才真正为写入方分配一块新的物理内存,并把数据拷贝过去。
- 为什么这样设计? 因为很多时候
fork() 之后马上就会跟着 exec()(加载新程序),原来的内存根本用不到。写时复制极大地提高了 fork()的效率。
4. 文件描述符的“相同副本”
图片说:“子进程获得父进程打开文件描述符的相同副本”。
- 这意味着,如果父进程打开了一个文件,子进程也能直接读写这个文件。
- 并且,由于是“副本”,父进程和子进程共享同一个文件偏移量(File Offset) 。如果父进程读了 10 个字节,子进程接着读,会从第 11 个字节开始读。
- 这也解释了为什么在终端里,子进程打印输出时,也能直接输出到你的屏幕上(因为标准输出
stdout的文件描述符也被复制了)。
总结
这张图不仅解答了 fork() 的机制,还引出了操作系统中的三大核心概念:系统调用、虚拟内存、写时复制(COW) 。
父进程和子进程的代码既然一样,那有什么意义呢
答案是:fork() 本身不是为了“复制”,而是为了“分工”。
虽然刚 fork() 出来的那一瞬间,两个进程确实一模一样,但紧接着,它们就会根据 fork() 的返回值(父进程拿到子进程 PID,子进程拿到 0),走向完全不同的道路。
我们来看看这到底有什么实际意义:
1. 经典用法一: fork() + exec() (启动新程序)
这是 fork() 最常见的用途。Shell(终端)是怎么执行你输入的命令(比如 ls、gcc)的?
- Shell 是一个进程(父进程)。
- Shell 调用
fork() 复制出一个子进程。 - 子进程拿到
pid == 0 ,它立刻调用 exec() 系统调用,把自己的内存全部替换成 ls 程序的代码。 - 父进程(Shell)拿到子进程的 PID,继续等待用户输入,或者等待子进程结束。
- 意义:Shell 自己不想死,但它需要执行新程序。所以它“克隆”一个自己,让克隆体去“变身”成新程序,自己则留在原地继续工作。这就是“分工”。
2. 经典用法二:并发处理(服务器模型)
假设你写了一个 Web 服务器,监听 80 端口。每当有一个用户连接过来,你希望同时处理多个用户,而不是处理完一个再处理下一个。
- 服务器进程(父进程)调用
fork()。 - 子进程拿到
pid == 0,它去处理这个用户的请求(读数据、发响应)。 - 父进程拿到子进程 PID,它立刻回到
accept()那里,等待下一个用户的连接。 - 意义:这就是经典的 “一个连接一个进程” 模型(比如早期的 Apache 服务器)。父进程负责“拉客”,子进程负责“服务”。如果没有
fork(),服务器只能串行处理,效率极低。
3. 经典用法三:并行计算(分治思想)
假设你要计算一个超大数组的和,或者进行复杂的密码破解。
- 父进程调用
fork()创建多个子进程。 - 子进程 1 计算数组的前半部分。
- 子进程 2 计算数组的后半部分。
- 父进程调用
wait()等待它们算完,然后把结果汇总。 - 意义:利用多核 CPU 的并行能力。虽然每个子进程都有一份完整的内存副本,但它们可以通过
fork 后的 if/else逻辑,分别处理不同的数据块。
4. 为什么代码一样,却能有不同行为?(核心机制)
这就是 fork() 设计的最精妙之处:利用返回值做条件分支。
虽然代码一样,但程序执行到 if 语句时,会根据返回值走向不同的分支:
pid_t pid = fork();

if (pid == 0) {
    // 只有子进程会执行这里
    // 比如:去执行 exec() 变身,或者处理具体的业务逻辑
    printf("我是子进程,我的PID是 %d\n", getpid());
} else if (pid > 0) {
    // 只有父进程会执行这里
    // 比如:继续监听端口,或者等待子进程结束
    printf("我是父进程,我创建了子进程 %d\n", pid);
} else {
    // fork 失败
    perror("fork");
}
5. 为什么不直接创建一个“完全不一样”的进程?
因为 fork() 提供了一个极其干净的初始状态。
- 如果从零开始创建进程,操作系统需要重新分配页表、初始化各种数据结构,非常麻烦。
fork()相当于“复制当前现场”。子进程继承了父进程的环境(环境变量、打开的文件、工作目录等),这样程序员就不需要重新去配置这些环境了。- 而且,有了 写时复制(COW) 技术,这种“复制”在物理上非常廉价,只有在真正写数据时才分配内存。
总结
fork() 的意义不在于“复制”,而在于 “分叉” 。
它让一个进程可以分裂成两个独立的执行流。代码一样是“初始状态”,通过 if (pid == 0) 走向不同的逻辑分支,才是“最终目的”。 它是操作系统实现“并发”和“执行新程序”的基石。
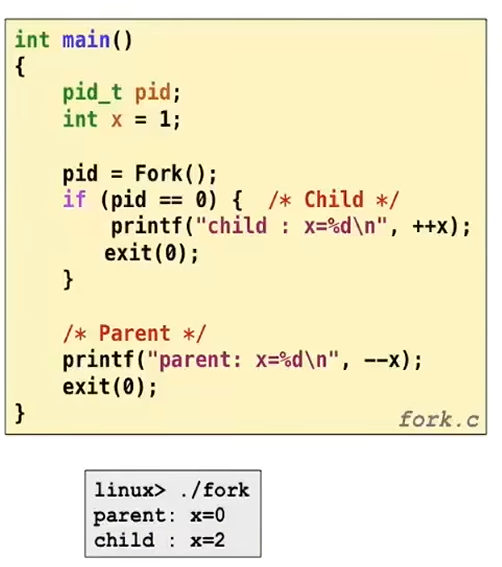
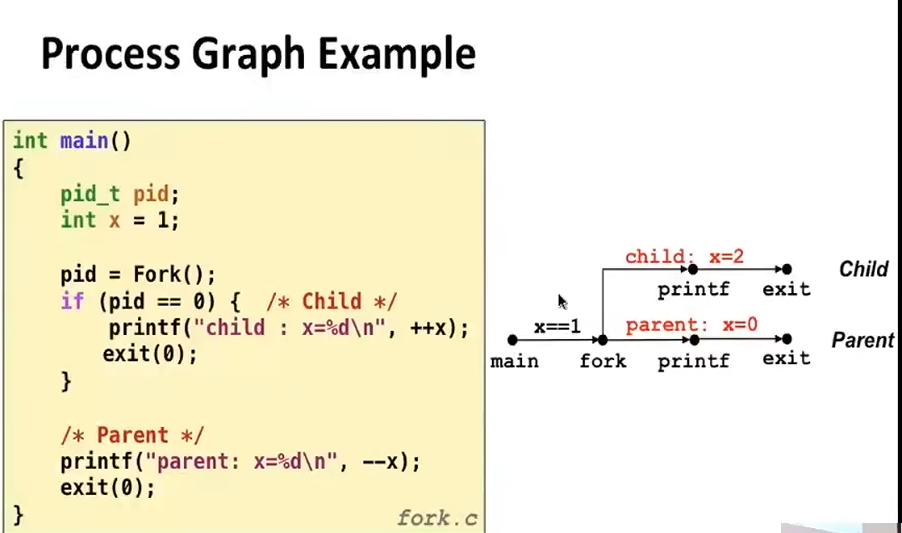
例如,在这个例子中,就是用了pid作为分支的依据,父进程和子进程就做了不同的事情
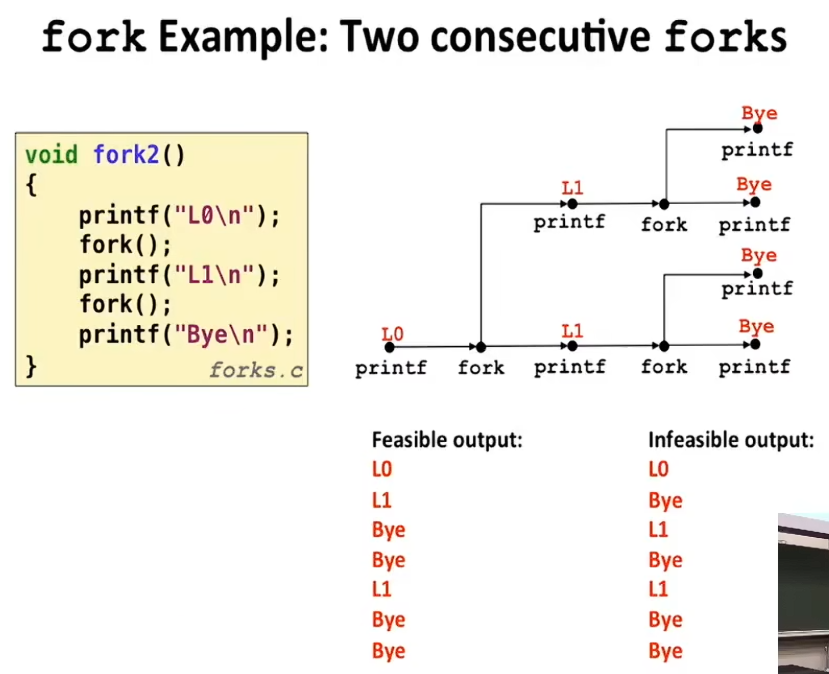
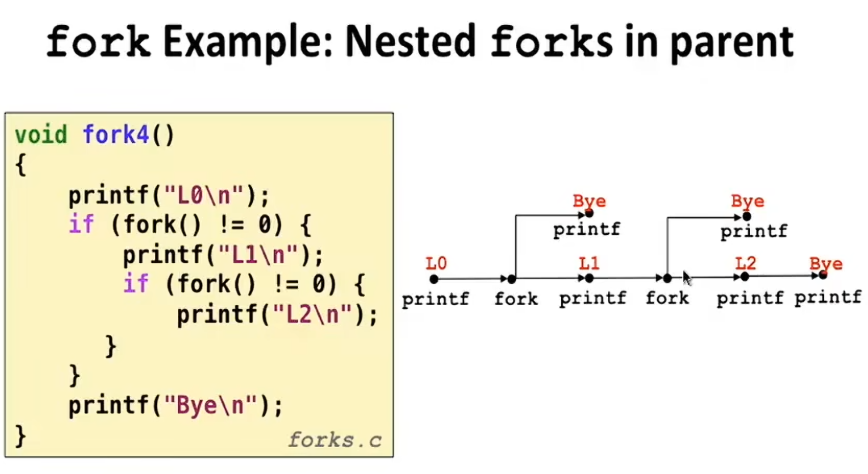
但是,我们无法保证子进程和父进程到底哪个先执行,所以这些输出可能是乱序的
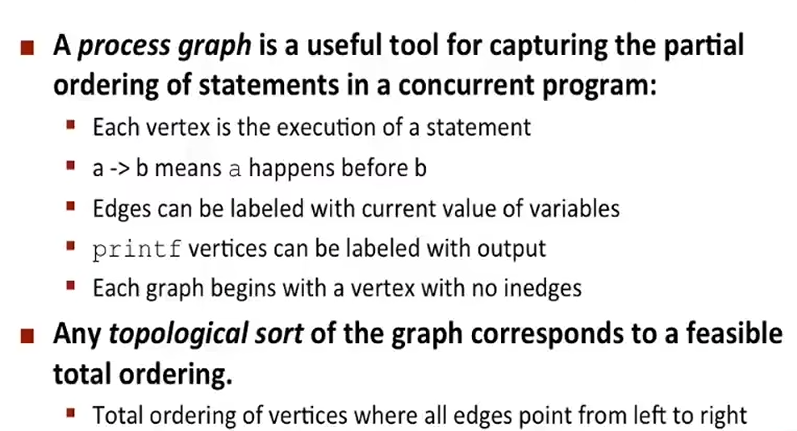
我们用一种叫做进程图的工具,来捕捉调用forks时可能发生的情况:
当程序exit的时候,虽然内核回收了他的大部分资源,他还在占用系统的资源,比如:退出状态(Exit Status),进程表项(OS tables)。程序已经不再运行,但是PID还在被占用,所以称其为僵尸进程。直到父进程将其回收,是以下三个顺序:
- 回收主要依靠父进程用wait或者waitpid去读取子进程的退出状态
- 父进程知道了子进程的Exit Status
- 内核将子进程删除
如果父进程没有回收僵尸进程,会发生什么呢?比如如果父进程比子进程还先终止:
- 这个僵尸进程会被PID为1的init进程进行回收(现在的操作系统中为systemd)
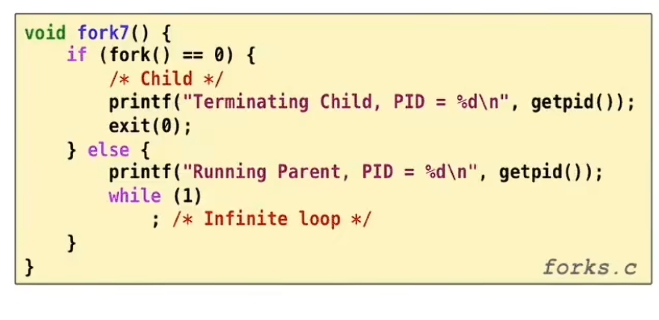
在这个例子中,父进程陷入死循环,在子进程terminated之后没有用wait()进行回收,因此产生了僵尸进程
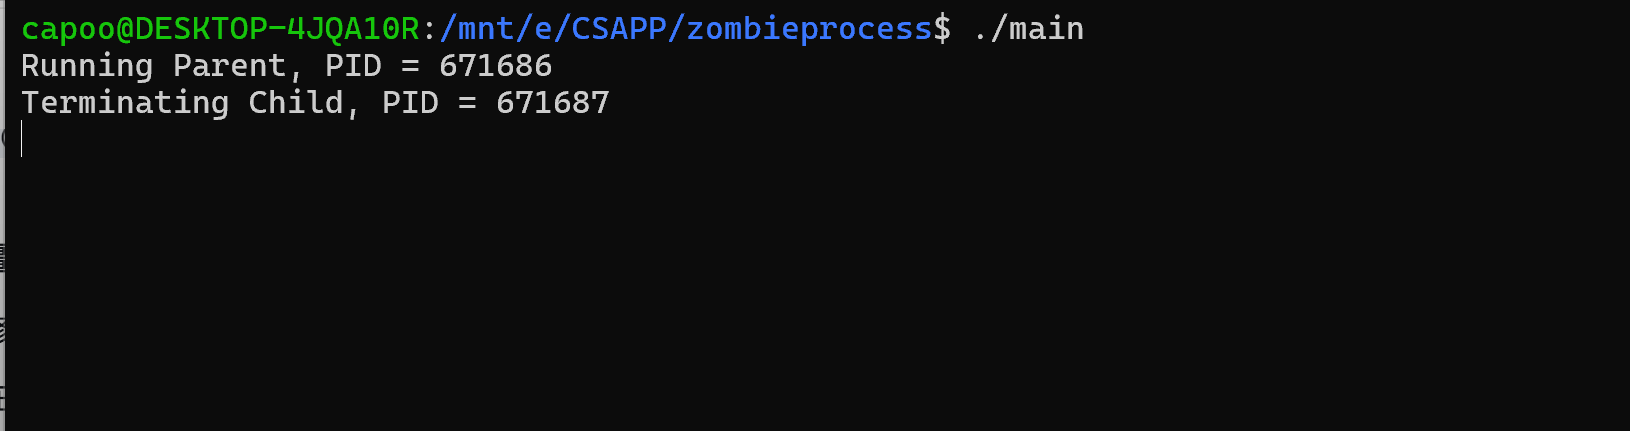

#include<stdio.h>

void fork7();

int main(){
        fork7();
}
void fork7() {
    if (fork() == 0) {
        /* 子进程分支 */
        printf("Terminating Child, PID = %d\n", getpid());
        exit(0);  // 子进程死亡
    } else {
        /* 父进程分支 */
        printf("Running Parent, PID = %d\n", getpid());
        while (1)
            ; /* 无限循环 */
    }
}
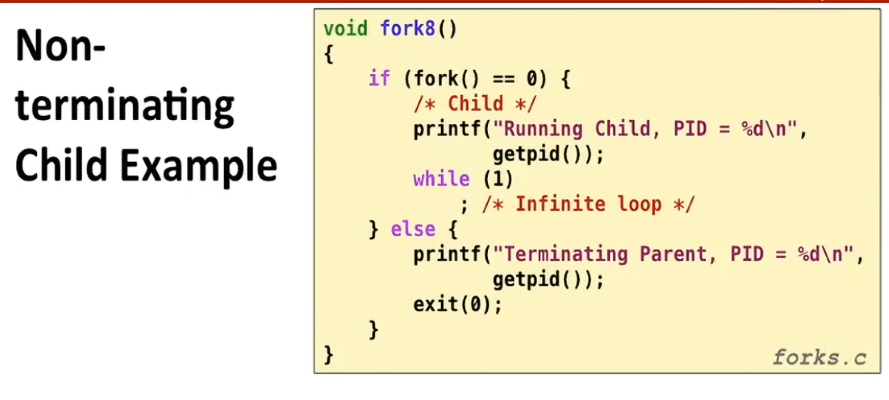
在这个例子中,当父进程先终止,子进程如果无人来回收,会有init(systemd)对其进行回收。
接下来则是详细讲述了wait()函数的使用:
wait()最核心的行为是,当父进程调用wait之后,会立刻放弃CPU进入睡眠状态,内核会将其从运行队列中移除,直到子进程调用exit(0),内核才会重新唤醒父进程,wait()返回,父进程继续向下执行。
如果父进程调用wait的时候,子进程已经成为了僵尸进程,那么wait会立刻返回,顺手把僵尸进程清理掉。
因此,标准的代码应该是下面这样:
#include <sys/wait.h>
#include <unistd.h>
#include <stdio.h>
#include <stdlib.h>

int main() {
    pid_t pid = fork();

    if (pid == 0) {
        // 子进程干活
        printf("Child running\n");
        exit(42); // 子进程退出,返回状态码 42
    } else {
        // 父进程收尸
        int status;
        pid_t child_pid = wait(&status); // 阻塞在这里,等子进程死

        printf("Reaped child with PID:  %d\n", child_pid);

        // 解析退出状态
        if (WIFEXITED(status)) {
            printf("Child exited normally with status: %d\n", WEXITSTATUS(status));
        } else if (WIFSIGNALED(status)) {
            printf("Child killed by signal: %d\n", WTERMSIG(status));
        }
    }
    return 0;
}
之前说过,fork()创建的只是父进程的副本,如果需要在子进程执行不同的代码,需要使用,execve()
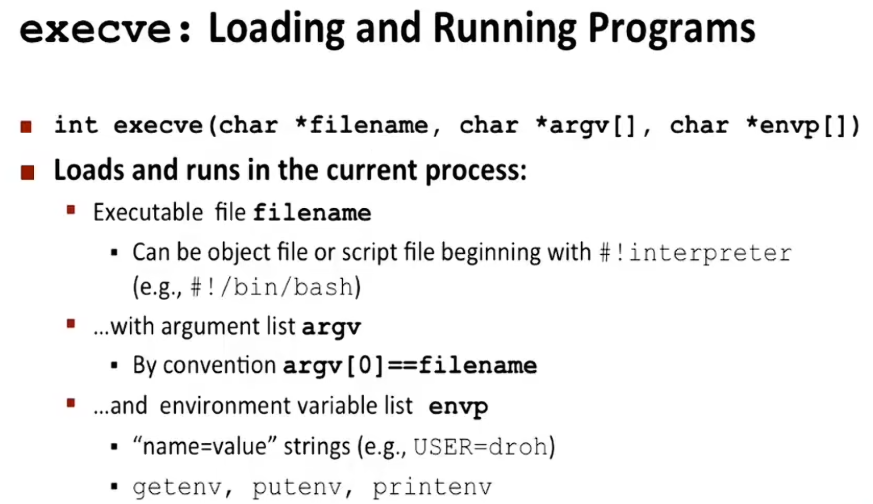
函数需要传递三个参数:
- filename(也可以是二进制文件,也可以是bash脚本)
- argv[] 传参,其中argv[0]是被执行的文件名称
- envp[] 传入的环境变量
但是,调用execve() 不会改变子进程的PID,且一旦执行成功,永远不会返回(错误情况除外)
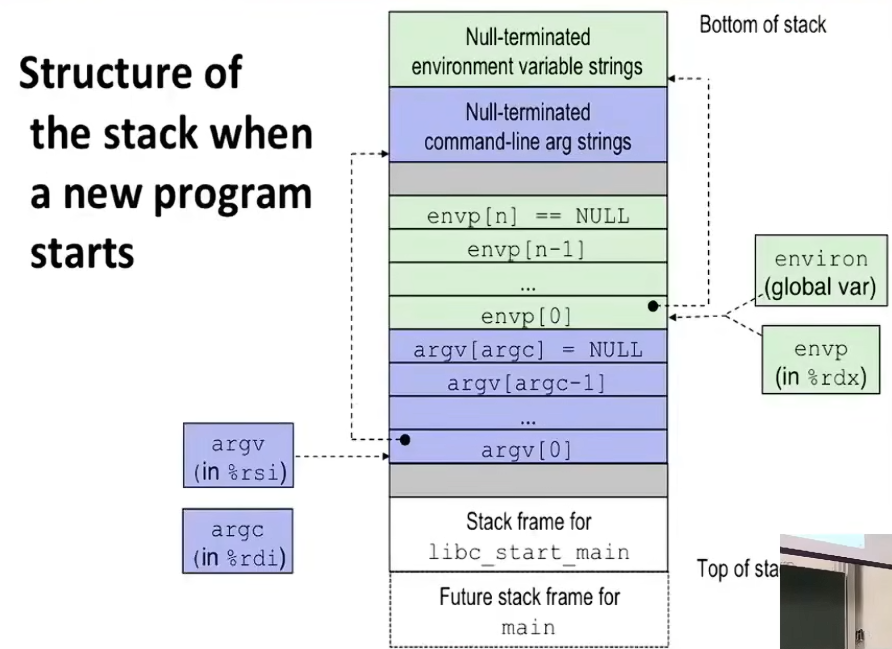
这张图展示了当我们在fork之后,调用execve()时,栈帧的情况:
Q:这个是栈帧,可是 不是说fork()会复制内存,随后 execve()不是会覆盖原本的内存吗,栈帧里面为什么还有main呢
Answer:
1. fork() 和 execve() 的“覆盖”到底覆盖了什么?
你理解得没错:
-
fork() :完全复制父进程的内存空间。 -
execve() :确实会彻底覆盖当前进程的用户空间内存。
但是, “覆盖”并不是把内存全部清零,而是重新建立一套全新的内存映射(Memory Mapping)。
execve() 做的事是:
- 把原来的代码段、数据段、堆、栈全部丢弃(内核直接回收这些物理页)。
- 读取新的可执行文件(比如
/bin/ls),把它的代码段、数据段加载到内存。 - 重新分配一块全新的、干净的栈空间。
- 最关键的一步:把
argv (命令行参数)和 envp (环境变量)这些数据,从内核空间拷贝到这个新的栈顶。
所以,这张图里画的栈,不是父进程原来的栈,而是 execve 为新程序重新建立的栈。
2. 既然是新栈,为什么里面会有 main ?
这就是这张图最精髓的地方。
execve 加载完新程序后,它不会直接跳到 main 函数。为什么呢?
- 因为
main 函数需要接收参数(argc, argv)和环境变量(envp)。 - 这些参数是内核在
execve时准备好的,放在了栈顶。 - 内核在启动新程序时,会把 CPU 的指令指针(PC/RIP) 指向一个特殊的函数:
_start(在 Linux 中通常是 __libc_start_main的入口)。
这个 _start 函数是 C 运行时的启动代码(由 C 标准库提供)。它的任务是:
- 从栈顶把
argc、argv、envp拿下来。 - 初始化 C 运行时的环境(比如设置全局变量、初始化
stdio等)。 - 最后,调用
main(argc, argv, envp) 。
所以,图中显示的 "Future stack frame for main" ,并不是说 main 已经执行了,而是表示 _start 函数在完成准备工作后,将要为 main 函数建立的栈帧。
3. 图中各个部分的精确含义
-
最底下(Top of stack) :
Future stack frame for main。这是预留的,等 _start 调用 main 时,main的局部变量会放在这里。 -
中间(Stack frame for libc_start_main) :这是
_start(即 libc_start_main)自己的栈帧,它负责启动流程。 -
上面(argc, argv, envp) :这是内核在
execve 时,强行推入新栈顶的数据。argv[0] 是程序名,argv[1] 是第一个参数,NULL结束。envp[0] 是第一个环境变量,NULL结束。- 最上面是实际字符串内容的存储区(Null-terminated strings)。
-
右侧的寄存器:
%rdi 存放 argc。%rsi 存放 argv的地址。%rdx 存放 envp的地址。- 这是
_start 函数调用 main时,按照 x86-64 调用约定传参的方式。
4. 回到你的问题:为什么会有 main ?
因为 execve 加载程序后,必须把执行权交给新程序的入口点。这个入口点不是 main,而是 _start。_start 是 C 运行时的“引导程序”,它最终会调用 main。
所以,这张图不是在说“fork 的复制被保留了”,而是在说:“execve 成功覆盖旧内存后,新程序在启动时,栈里长什么样。 ”
总结
-
fork 复制的内存:在 execve 时被完全抛弃。 -
execve 建立的栈:是全新的,里面装着内核传进来的参数。 - 栈里的
main:是 _start函数将要调用的目标。它是新程序的起点,而不是旧程序的残留。
你现在把进程管理和程序运行时的底层细节都打通了。这张图就是 execve 执行后,新程序在物理内存中的初始快照。
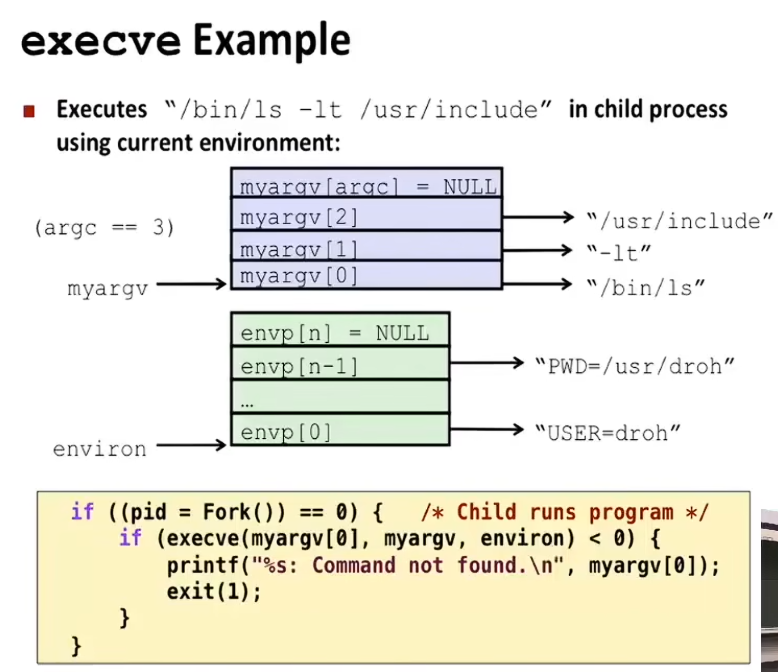
这个例子中,使用execve()来执行ls