L17 Virtual Memory: Concepts
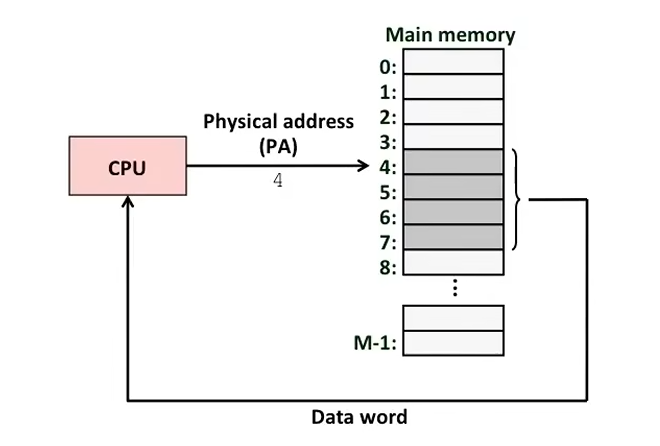
如图所示的内存读取方式:CPU直接向主存中读取数据。这通常适用于一些单片机,而非当前主流的服务器/计算机使用的"虚拟化内存"架构。
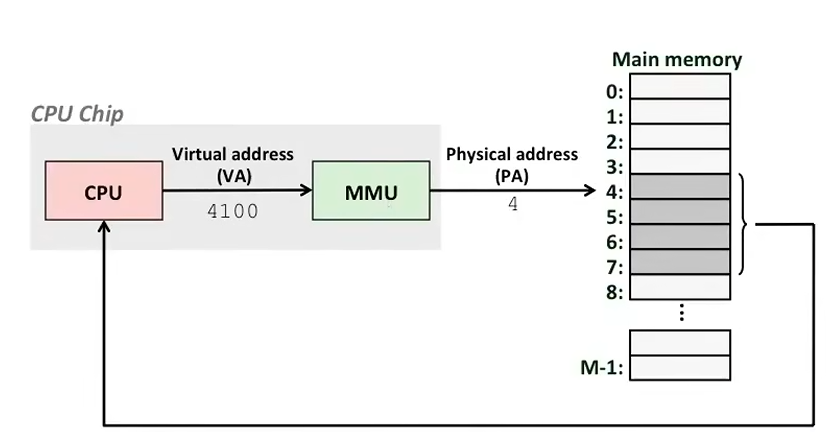
在这套“虚拟内存”中,我们使用一个虚拟地址对MMU(内存管理单元)进行访问,MMU会完成从虚拟地址到真实物理地址的映射。


为什么要使用虚拟内存呢?虚拟内存可以帮助我们更高效的使用主存,方便内存管理,以及隔离进程之间的内存。

虚拟内存,如果站在某种视角上来看,可以视作是磁盘的缓存——之前提到过,DRAM的速度远大于HDD/SSD存储,但是存储大小现在仍然在比较小的量级。因此可以视作缓存。
虚拟内存和物理内存之间,以“页”(page)为为单位进行数据传输。通常,一页的大小是4096Bytes,也就是4KB.
其中,物理页和虚拟页应该形成一一对应的关系。虚拟页分成了三种状态:
-
Unallocated(未分配) :
- 这个虚拟页还没有被程序使用(比如你还没
malloc这块内存)。 - 它在磁盘上不占用实际空间,在物理内存里也没有对应的页。
- 这个虚拟页还没有被程序使用(比如你还没
-
Cached(已缓存) :
- 这个虚拟页的数据已经加载到了物理内存(DRAM)中。
- 图中画了箭头,从左侧的“Cached”指向右侧的物理页(PP 0, PP 1…)。
- 此时,CPU 访问这个虚拟地址,MMU 直接把它翻译成对应的物理地址,速度极快。
-
Uncached(未缓存) :
- 这个虚拟页的数据还在磁盘上,还没有被加载到物理内存中。
- 图中它没有指向任何物理页。
- 此时,如果 CPU 访问这个虚拟地址,就会触发一个缺页异常(Page Fault) 。内核会暂停程序,去磁盘把这一页数据加载到物理内存(找一个空闲的 PP),然后更新页表,最后让程序继续执行。
虚拟内存和物理内存的映射关系是依靠PT(page table)来建立的

本质是一个由内核维护的数组,数组中的每一个元素叫做PTE(Page Table Entry)里面建立了VP到PP的映射关系
这张表本身也存在于内存中,由MMU负责实际查表,内核负责更改
页表是进程私有的,每个进程都有自己独立的页表,记录了自己的虚拟地址空间到物理地址的映射。当内核进行上下文切换的时候,页表会被切换(修改CPU的CR3寄存器)让MMU使用新的进程页表。
在PPT的这张图中,也对应了之前描述的三种状态:
-
Valid(有效位) :
- 1:表示这个虚拟页已经缓存在物理内存里了。MMU 可以直接根据后面的“物理页号”去访问。
- 0:表示这个虚拟页不在物理内存里(还在磁盘上,或者未分配)。此时如果 CPU 访问这个地址,会触发缺页异常(Page Fault) ,内核介入去磁盘加载。
-
Physical page number or disk address(物理页号或磁盘地址) :
- 如果
Valid == 1,这里存的是物理页号(PPN) 。 - 如果
Valid == 0,这里存的是磁盘地址(告诉内核,这一页的数据在磁盘的哪个位置)。如果这个虚拟页是“未分配”的,这里通常是 null。
- 如果
-
Valid == 1就是“缓存命中(Cache Hit)”。 -
Valid == 0就是“缓存未命中(Cache Miss)”。 -
null就是“未分配(Unallocated)”,根本不在磁盘上。

当VP5处于未分配状态的状态的时候,它里面没有数据,对应的位是无效,地址是null。当程序通过malloc请求内存,内核决定把VP 5分配给这个进程。
第一步:在磁盘上分配空间(虚线箭头)
- 内核首先要在磁盘(Virtual memory disk) 上,为
VP 5找一块空闲的存储空间。 - 图中右下角的虚线,从 PTE 5 指向了磁盘上的
VP 5。此时,PTE 5 里的 Valid 位依然是 0,但后面的字段从 null 变成了一个磁盘地址。这表示:“这一页的数据以后存在这里”。
第二步:建立页表映射(中间的表)
- 此时,
VP 5还在磁盘上,物理内存里还没有它。 - 关键点:分配(Allocate)并不等于立即加载(Load)。分配只是“预订了位置”,还没真正把数据搬进物理内存。
第三步:按需加载(触发缺页异常)
- 当程序第一次读写
VP 5 里的数据时,MMU 发现 PTE 5 的 Valid 位是 0(无效)。 - 这会触发一个缺页异常(Page Fault) 。
- 内核介入,去磁盘上把
VP 5 的数据加载到物理内存(DRAM)里找一个空闲的物理页(比如 PP 4)。 - 然后,内核修改 PTE 5:把
Valid 位设为 1,把后面的地址改成 PP 4的物理页号。 - 最后,重新执行那条引发异常的指令,这次 MMU 就能成功翻译地址了。
可是,到目前位置 VP5都还只是在磁盘上,并没有触达真实的DRAM
因此,当只是allocate时,没有真正的读写数据。只有当程序真的尝试在向VP5写入数据的时候,才会真正的向DRAM中写入数据。
这是延迟分配,按需分页机制。那为什么要这样呢?
因为物理内存是稀缺资源。
- 如果你
malloc(1GB),操作系统立刻给你分配 1GB 物理内存,但你可能只用了 1KB。剩下的 999MB 就白白浪费了。 - 通过延迟分配,操作系统可以“超售”内存。所有进程都以为自己有 4GB,但物理内存可能只有 16GB。只有当大家真正用到的时候,才按需分配。
- 这也是为什么你可以运行一个比物理内存还大的程序(比如 64GB 的数据库),只要你的磁盘够大,操作系统会通过页面置换(Swap) 来腾挪物理内存。

虚拟内存的一个核心思想:每一个进程都有自己专属的虚拟地址空间——通过内核为每个进程提供独立的页表来实现
在这张图中可以观察到 进程1 进程2的VP2指向了同一块物理内存区域。这个被称为共享内存(比如glibc.so就是靠这个来实现)

实际上,我们打开top,也能观察到刚刚的结论:
MiB Mem,是实际的的可用DRAM总览:
-
total:3917.2 MiB。这是分配给 WSL 虚拟机的物理内存总量。
-
free:2355.5 MiB。完全空闲的物理内存。
-
used:604.1 MiB。已经被进程实际占用的物理内存。这就是你写程序时,真正触发缺页异常后,分配出去的那部分。
-
buff/cache:1103.2 MiB。内核缓冲区(Buffer)和页缓存(Page Cache) 。
- 这是 Linux 的“偷懒”哲学:你读过的文件、写过的数据,内核不会立刻扔掉,而是留在内存里当缓存。
- 如果下次再读同一个文件,直接从内存拿,不用去磁盘。
- 注意:
buff/cache 里的内存,在程序需要时随时可以被回收。所以 free很小不一定是坏事,Linux 会尽量用满内存做缓存。
-
avail Mem:3313.1 MiB。应用程序真正可用的内存。它等于
free + 可回收的 buff/cache。这才是你判断内存够不够用的关键指标。
MiB Swap 是交换空间,当物理内存(DRAM)不够用时,内核会把一些“不常用”的页从物理内存换出(Swap Out) 到磁盘的 Swap 分区。当程序再次访问这些页时,触发缺页异常,内核再把它们换入(Swap In) 到物理内存。
在详细的进程的进程列表中,有三列参数 VIRT RES SHR。分别对应,虚拟内存,常驻内存,共享内存
1. VIRT(Virtual Memory Size)—— 虚拟内存
-
含义:这个进程 “以为” 自己拥有的内存总量。
-
对应知识:这就是之前学的虚拟地址空间。它包括了:
- 代码段、数据段、堆、栈。
- 通过
malloc 分配但还没真正写入的内存(未触发缺页异常的部分)。 - 通过
mmap映射的文件(可能还在磁盘上)。 - 共享库(比如 libc.so)。
-
特点:VIRT 通常非常大(几百 MB 到几 GB),但这不代表它真的占用了那么多物理内存。它只是“预订”了这么多地址空间。
2. RES(Resident Memory Size)—— 常驻内存
- 含义:这个进程真正占用的物理内存(DRAM) 。
- 对应知识:这就是你上一问说的“真正触达了 DRAM”的那部分。只有当你真正读写虚拟内存时,触发缺页异常,内核才会分配物理页,这部分才会计入 RES。
- 特点:RES 才是衡量一个进程实际内存消耗的关键指标。
top 里的 %MEM就是 RES 除以总物理内存。
3. SHR(Shared Memory)—— 共享内存
- 含义:RES 中,被其他进程共享的那部分内存。
- 对应知识:最典型的就是动态链接库(如 libc.so ) 。你的 10 个程序可能都用到了 libc,内核在物理内存里只存一份 libc 的代码,然后让 10 个进程的页表都映射到同一块物理页。这就是你之前学的“打开文件表/v-node 表共享”在内存层面的体现。
- 特点:SHR 包含在 RES 里,但不包含在“进程独占内存”里。计算进程实际独占内存时,通常用
RES - SHR。
虚拟内存同样可以帮助内存保护。PTE有权限扩展位,MMU可以靠这些权限位来确定进程是否有权限对内存块进行读写

比如,一个进程的代码段是不可修改的,栈如果开启了NX应该是不可执行。权限位通常包括这些:
- R/W(Read/Write) :0 表示只读,1 表示可读写。
- U/S(User/Supervisor) :0 表示只有内核(Supervisor)能访问,1 表示用户态(User)也能访问。
- XD/NX(Execute Disable / No Execute) :0 表示可以执行代码,1 表示禁止执行(防止代码注入攻击)。
- P(Present/Valid) :就是你上一问学的有效位(0 表示在磁盘上,1 表示在内存里)。
虽然是64位系统,地址是64位。但真正的虚拟空间是48位的。剩下的高位并不是“浪费”了,而是为了兼容性、性能和未来扩展故意留白的。
当前x86-64使用的是四级页表(PGD -> PUD -> PMD -> PTE)。每一级页表索引占 9 位,加上页内偏移 12 位,总共是 4 * 9 + 12 = 48 位。
关于四级页表:

1. 为什么需要多级页表?(单级页表的致命缺陷)
假设我们用单级页表:
- 虚拟地址是 48 位,页大小是 4KB(12 位偏移)。
- 那么虚拟页号(VPN)有 36 位。这意味着页表需要
2^36个条目。 - 每个条目 8 字节,那么单级页表的大小是
2^36 * 8 = 512 GB! - 结论:单级页表根本不可行,光页表就把内存吃光了。
多级页表的思路是:把页表本身也分页,只把当前用到的部分加载到内存。
2. 4 级页表的结构(PGD -> PUD -> PMD -> PTE)
x86-64 把 48 位的虚拟地址切成了 5 段:
| {: style="text-align: left;"}地址位 | {: style="text-align: left;"}名称 | {: style="text-align: left;"}作用 |
|---|---|---|
| {: style="text-align: start;"}47-39(9位) | {: style="text-align: start;"}PGD(Page Global Directory) | {: style="text-align: start;"}全局页目录索引 |
| {: style="text-align: start;"}38-30(9位) | {: style="text-align: start;"}PUD(Page Upper Directory) | {: style="text-align: start;"}上层页目录索引 |
| {: style="text-align: start;"}29-21(9位) | {: style="text-align: start;"}PMD(Page Middle Directory) | {: style="text-align: start;"}中间页目录索引 |
| {: style="text-align: start;"}20-12(9位) | {: style="text-align: start;"}PTE(Page Table Entry) | {: style="text-align: start;"}页表项索引 |
| {: style="text-align: start;"}11-0(12位) | {: style="text-align: start;"}Offset | {: style="text-align: start;"}页内偏移量 |
每一级页表都包含 512 个条目(2^9),每个条目指向下一级页表的物理地址。
3. 它是如何工作的?(MMU 的查表过程)
当 CPU 访问一个虚拟地址时,MMU 会像“走迷宫”一样,一级一级往下查:
- CR3 寄存器:CPU 有个特殊的寄存器
CR3,指向当前进程的 PGD(顶级页表) 的物理地址。 - 第一级:用虚拟地址的 PGD 索引(9位)在 PGD 里找到对应的条目。这个条目指向一个 PUD。
- 第二级:用 PUD 索引(9位)在 PUD 里找到对应的条目。这个条目指向一个 PMD。
- 第三级:用 PMD 索引(9位)在 PMD 里找到对应的条目。这个条目指向一个 PTE。
- 第四级:用 PTE 索引(9位)在 PTE 里找到最终的页表项。这个条目里包含了物理页号(PPN) 和权限位。
- 最终:用 PPN + Offset(12位)拼出真实的物理地址。
总共需要 4 次内存访问(如果不命中 TLB 缓存的话),才能完成一次地址翻译。
4. 多级页表的精髓:按需分配
多级页表最大的好处是节省内存。
-
如果进程只用了虚拟地址空间的一小块(比如堆区),那么:
- PGD 里可能只有 1 个条目有效(指向 PUD)。
- PUD 里可能只有 1 个条目有效(指向 PMD)。
- PMD 里可能只有 1 个条目有效(指向 PTE)。
- PTE 里可能只有几个条目有效(指向物理页)。
-
那些没有用到的地址空间,对应的 PGD/PUD/PMD 条目都是空的,不需要分配下一级页表。
-
这样,一个进程的页表可能只占用几十 KB,而不是 512 GB。
5. 结合你之前学的“缺页异常”
多级页表让缺页异常的处理更精细:
- 当 MMU 查表时,如果某一级页表的条目是空的(
Present = 0),就会触发缺页异常。 - 内核发现这个地址是合法的(在进程的 VMA 里),但对应的页表层级还没建立。
- 内核会分配一个新的页表页(比如 PTE 页),填充条目,然后返回,让 MMU 重新查表。
- 这就是“按需分页”在页表层级上的体现:不仅物理页是按需分配的,页表本身也是按需分配的。
在当前CSAPP课程简化的页表当中,虚拟地址向真实地址的转换是如下过程:

如图所示,一个虚拟地址可由两部分组成,低p位是偏移量VPO(比如,当p=12,就是2^12=4096,可就是4KB,也是单个缓存页的大小)。高位部分是虚拟页号(VPN),也就是真实情景对应的四级页表索引。
PTBR(page table base register)页表基址寄存器是一个特殊的寄存器,在x86中就是CR3,负责保存当前进程页表在物理内存中的起始位置。当操作系统进行上下文切换的时候,就会修改PTBR,指向新进程的页表。
当需要查找虚拟地址时,用VPN作为索引,去页表中查询对应的有效状态和物理页地址。当valid bit=0的时候,说明需要的虚拟页不在物理内存中(要么在磁盘上,是未分配)内核会触发缺页异常。当valid bit =1 的时候,MMU从PTE中取出PPN。随后讲PPN与VPO进行拼接。PPN放在高位 VPO放在低位,组成最终的物理地址。
我们假设一个 32 位的虚拟地址空间(方便计算),p = 12。
虚拟地址 1: 0x00001FFF
-
二进制拆解:
- 高 20 位(VPN):
0x00001(二进制 ...0001) - 低 12 位(VPO):
0xFFF(二进制 1111 1111 1111)
- 高 20 位(VPN):
-
含义:这是第 1 个虚拟页的最后一个字节(偏移量 4095)。
-
翻译:MMU 用 VPN=1 去查页表,假设查到的 PPN = 5。
-
物理地址:PPN + VPO =
0x00005FFF。
虚拟地址 2: 0x00002000
-
二进制拆解:
- 高 20 位(VPN):
0x00002 - 低 12 位(VPO):
0x000
- 高 20 位(VPN):
-
含义:这是第 2 个虚拟页的第一个字节(偏移量 0)。
-
翻译:MMU 用 VPN=2 去查页表,假设查到的 PPN = 8。
-
物理地址:PPN + VPO =
0x00008000。

这是直接在内存中找到了需要的结果,也就是hit的情况。总而言之就是——虚拟地址在交给MMU之后,成功的在PT中找到了对应的PTE并且提取到了PPN,将其组成了PA并最终再进行访问。
一次地址翻译,至少要访问内存两次! 这就是为什么需要 TLB(快表) 来缓存 PTE。如果 TLB 命中,第一步(读 PTE)就可以省掉,直接拿到 PPN,速度会快很多。

对于miss,则被称作为page fault。本质是无法直接从虚拟地址在PT中找到对应的有效PTE(有效位是0 )。有两种可能:
-
虚拟地址合法,但是数据还在磁盘上,内核需要去磁盘把数据读取进来
-
虚拟地址不属于该进程,或者触发了地址权限错误(比如尝试在NX上执行)内核无法修复,会向进程发送SIGSEGV直接终止进程
当page fault被触发。硬件会把导致缺页的虚拟地址存储到一个特殊的CPU寄存器中(在x86中式 CR2),随后触发一个同步异常,将CPU从ring3切换到ring0进入内核的缺页处理程序。
内核会首先检查CR2中的虚拟地址,判断范围是否合法(在VMA中查找),如果地址不合法则SIGSEGV,若合法。则继续判断VMA类型:
- 若VMA标记为文件映射(如mmap),内核会去page cache中找,就不会去磁盘中取数据(之前提及过page cache的实例)
- 若VMA标记为匿名映射(如malloc的堆)并且是第一次访问,内核会分配一个零页(zero page),直接映射过去
- 若VMA标记为已换出(swap),内核会去swap分区把数据取回来。
随后,内核在物理内存里找一个空闲的物理页(PP)。如果物理内存不够,会触发页面置换算法(如 LRU),把一些不常用的页换出到 Swap。再将磁盘的数据写入这个物理页,将对应PTE的有效位设置为1,登记PPN,设置权限位,刷新TLB。
做完这一切之后,CPU返回用户态,重新执行程序,再次尝试执行刚才失败的程序,发现这次可以命中了
关于VMA:
一句话解释:VMA 就是内核用来描述进程虚拟地址空间中一段连续、具有相同权限和属性的区域的数据结构。
为什么需要 VMA?
- 一个进程的虚拟地址空间并不是一整块连续的内存。它由很多“碎片”组成:代码段(
.text)、数据段(.data)、堆(Heap)、栈(Stack)、共享库、mmap映射的文件等。 - 这些区域有不同的属性:有的可读可写(堆),有的只读(代码段),有的可执行(代码段),有的映射到文件,有的映射到匿名内存。
- 内核不能为每一个虚拟页都记录属性,那样太浪费。它把这些连续且属性相同的页合并成一个“区域”,用 VMA 来描述。
VMA 里记录了什么?
vm_start 和 vm_end:这个区域的起始和结束虚拟地址。vm_flags:权限(读、写、执行)、类型(共享、私有)。vm_file:如果这个区域是文件映射,指向对应的文件。vm_ops:操作函数集(比如缺页时,内核调用哪个函数来处理)。
一个进程的地址空间,就是由很多个 VMA 组成的链表/红黑树。
三种VMA类型:
类型一:文件映射(File-backed Mapping)
-
来源:通过
mmap() 系统调用,把一个文件映射到内存。或者,可执行文件的代码段、数据段(由 execve加载)。 -
VMA 特征:
vm_file指向一个具体的文件。 -
缺页处理:
- 内核先查 Page Cache(内核的页缓存)。Page Cache 里缓存了最近读过的文件页。
- 如果 Page Cache 命中:直接把那个物理页映射到进程的页表里。
- 如果 Page Cache 未命中:从磁盘把文件对应的页读进 Page Cache,然后再映射。
-
特点:如果内存紧张,这些页可以被直接丢弃(因为磁盘上还有备份),不需要写回磁盘。下次访问时,再从磁盘读。
类型二:匿名映射(Anonymous Mapping)
-
来源:通过
malloc()(底层用 brk 或 mmap)分配的堆内存,或者栈。 -
VMA 特征:
vm_file是 NULL。它没有对应的磁盘文件,只是一块“匿名”的内存。 -
缺页处理:
- 内核知道这是匿名映射。
- 如果是第一次访问(比如
malloc 后第一次写):内核分配一个零页(Zero Page) ,把它映射到进程的页表里。零页是内核预先准备好的一页全 0 的物理内存,所有进程共享同一个零页,只读。 - 如果进程试图写这个零页:触发写保护异常,内核分配一个新的物理页,把零页内容复制过去(全 0),然后映射新的可写页。
- 这样,
malloc的内存就真正分配了物理页。
-
特点:匿名页没有磁盘备份。如果内存紧张,它们必须被换出到 Swap 分区,否则数据就丢了。
类型三:已换出(Swapped Out)
-
来源:之前是匿名页或文件页,但因为物理内存紧张,被内核的页面置换算法(如 LRU)换出到了 Swap 分区。
-
VMA 特征:VMA 本身没变,但对应的 PTE 里的
Valid = 0,并且 PTE 里存的是 Swap 分区里的槽位号(而不是磁盘文件地址)。 -
缺页处理:
- 内核发现 PTE 指向 Swap。
- 从 Swap 分区把数据读回物理内存。
- 更新 PTE,指向新的物理页。
- 如果 Swap 空间不足,可能需要先换出其他页。
-
特点:这是“内存超售”的代价。Swap 让进程可以使用比物理内存更大的地址空间,但换入换出会带来巨大的 I/O 延迟(这就是为什么
top 里 wa高的时候,系统会卡)。

TLB(Translation Lookaside Buffer)也就是翻译后被缓冲器/快表,是一个硬件缓存。缓存的内容是PTE页面条目。
如果没有这个TLB,在VA到PA的实际映射(四级页表),MMU需要查询五次内存:
- 查 PGD(访问内存一次)
- 查 PUD(访问内存一次)
- 查 PMD(访问内存一次)
- 查 PTE(访问内存一次)
- 拿到 PPN,拼出 PA,再访问内存一次(读真正的数据)

TLB有一些核心的特点,使得其可以快速查询VPN到PPN的关系:
- 极小:通常只有 64 到 1024 个条目(对比 L1 缓存的几万条)。
- 极快:通常只需要 1 个 CPU 周期就能完成查询(因为它是为地址翻译专门优化的硬件)。
- 包含完整 PTE:不仅包含 PPN,还包含权限位(R/W, U/S, XD 等),这样 MMU 在翻译时可以顺便做权限检查。
当CPU拿到虚拟地址的时候,会将虚拟地址拆分成VPO和VPN,随后见VPN拿到TLB中查询,如果命中,直接获取PPN,完全不需要访问页表;如果未命中,那么会走五次查询,拿到PPN之后,会把映射关系写入到TLB,方便下次命中。
除此之外,TLB之所以有效,也是得益于程序的空间局部性。
当程序进行上下文切换的时候TLB也需要进行更新:
- 方案 A:直接刷新(Flush) 整个 TLB。这会导致新进程启动时,大量 TLB Miss,性能下降。
- 方案 B(现代 CPU) :在 TLB 条目里加一个 ASID(Address Space ID) ,标识这是哪个进程的映射。这样切换进程时不需要刷新 TLB,只要 ASID 不同,就不会混淆。

多级页表前面讲过了,不在此过多赘述
内存开销:
我们假设一个进程完全占满了 48 位的虚拟地址空间(256 TB) ,而且每一页都真正被访问到了(触发了缺页异常,建立了映射)。这时候,四级页表的内存消耗如下:
1. 逐级计算
-
第 4 级(PTE,最低级):
- 它负责映射 4KB 的物理页。
- 要覆盖 256 TB 的空间,需要的页数是:
2^48 / 2^12 = 2^36个页。 - 每个 PTE 占 8 字节,所以这一级总共需要:
2^36 * 8 = 2^39 字节 = 512 GB。 - 换算成页表页(每个 4KB):
2^39 / 2^12 = 2^27个页表页(1.34 亿个)。
-
第 3 级(PMD,中间目录):
- 每个 PMD 条目指向一个 PTE 页(4KB)。一个 PTE 页覆盖的虚拟内存是
512 * 4KB = 2MB。 - 要覆盖 256 TB,需要的 PMD 条目数是:
2^48 / 2^21 = 2^27个。 - 每个 PMD 条目占 8 字节,总共需要:
2^27 * 8 = 2^30 字节 = 1 GB。 - 换算成页表页:
2^30 / 2^12 = 2^18个页表页(26 万个)。
- 每个 PMD 条目指向一个 PTE 页(4KB)。一个 PTE 页覆盖的虚拟内存是
-
第 2 级(PUD,上层目录):
- 每个 PUD 条目指向一个 PMD 页。一个 PMD 页覆盖的虚拟内存是
512 * 2MB = 1GB。 - 要覆盖 256 TB,需要的 PUD 条目数是:
2^48 / 2^30 = 2^18个。 - 总共需要:
2^18 * 8 = 2^21 字节 = 2 MB。 - 换算成页表页:
2^21 / 2^12 = 2^9 = 512个页表页。
- 每个 PUD 条目指向一个 PMD 页。一个 PMD 页覆盖的虚拟内存是
-
第 1 级(PGD,全局目录):
- 每个 PGD 条目指向一个 PUD 页。一个 PUD 页覆盖的虚拟内存是
512 * 1GB = 512GB。 - 要覆盖 256 TB(262144 GB),需要的 PGD 条目数是:
262144 / 512 = 512个。 - 每个 PGD 条目占 8 字节,总共需要:
512 * 8 = 4096 字节 = 4 KB(刚好一个页表页)。
- 每个 PGD 条目指向一个 PUD 页。一个 PUD 页覆盖的虚拟内存是
2. 总内存消耗
把四级加起来:
- PGD:4 KB
- PUD:2 MB
- PMD:1 GB
- PTE:512 GB
- 总计:约 513 GB
这是把博客当笔记用了吗(
感觉不如整合一些精华