L15 Exceptional Control Flow: Signals and Nonlocal Jumps
Linux所有的进程存在一个架构(这张图中不包括内核进程)
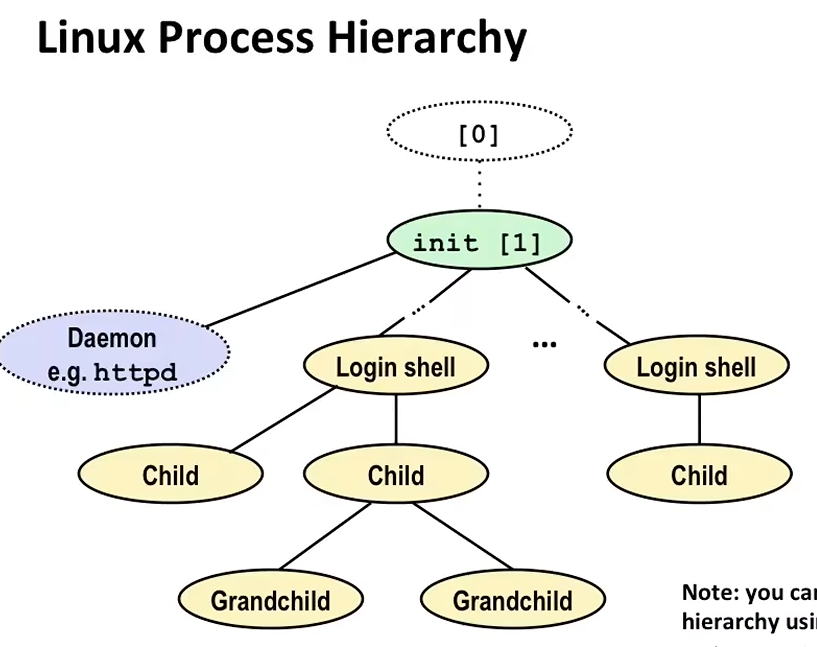
对于所有用户进程来说 systemd(init) 是他们的祖先,在之前提到过,可以用来回收僵尸进程。
所以,shell其实和别的程序没什么区别,无非就是被写在了/etc/passwd 作为了用户登录时默认打开的程序:
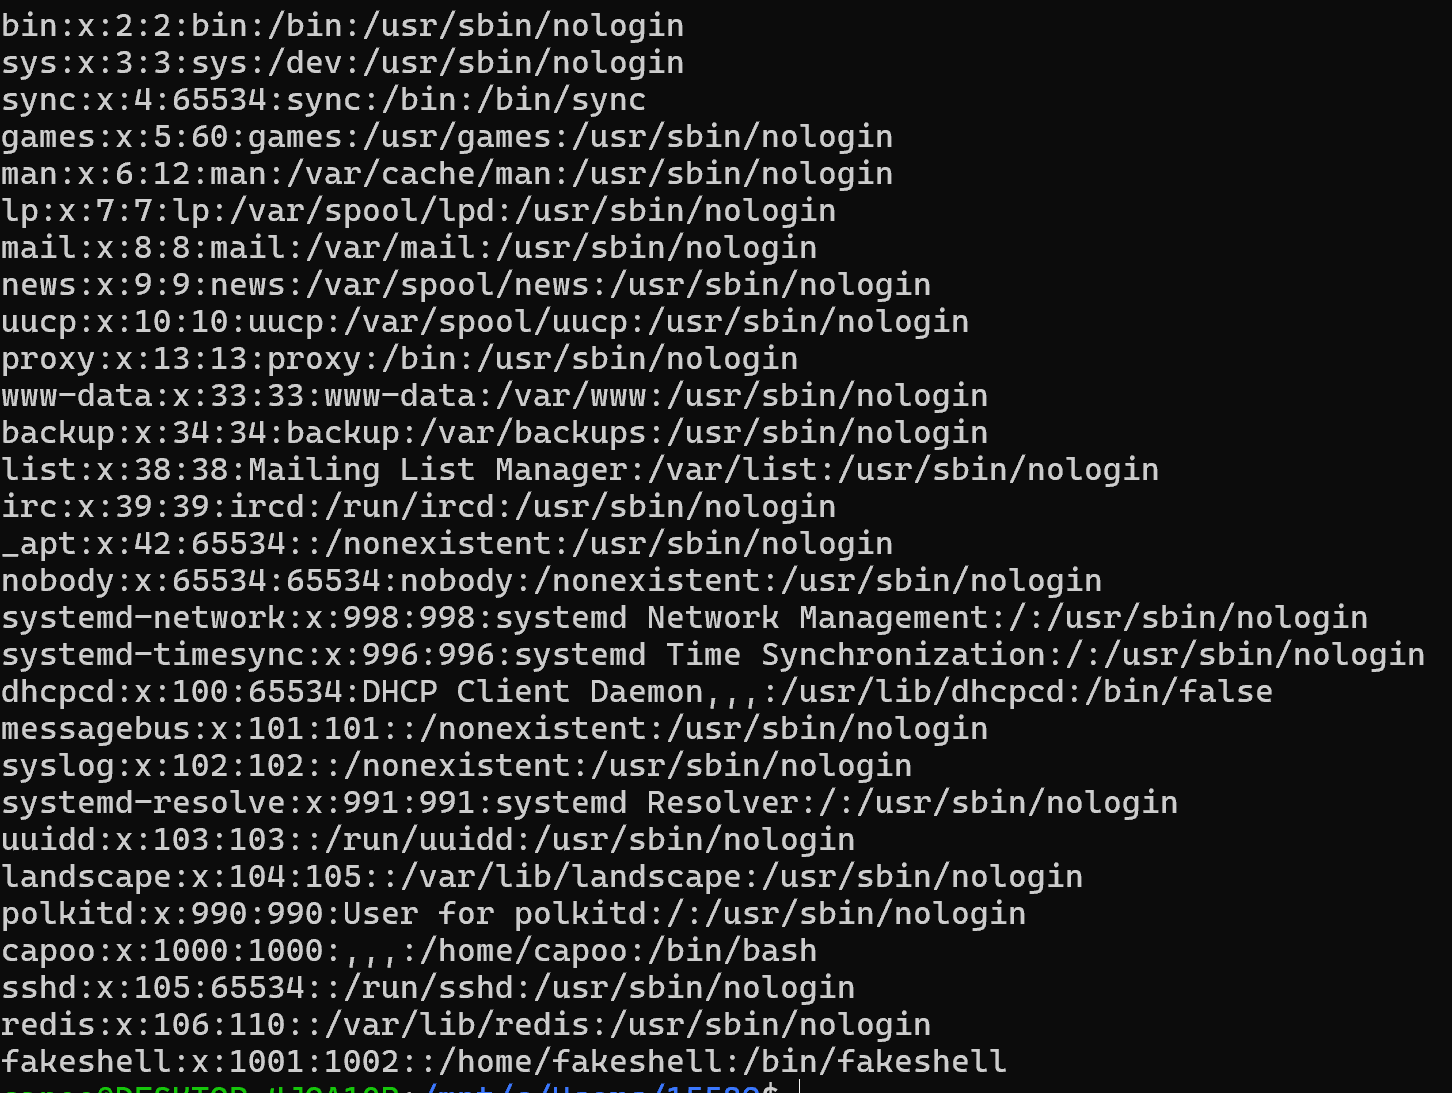
那么我们现在其实已经知道了shell的原理:其本质也是个程序,是将内核开放出来的接口进行了一定的整合,形成了一个命令行,如果说内核是类似后端的话 shell应该就是个前端。无论是ash fish bash 虽然可能输入的指令都不一样,但是能做到的效果是一样的。用户输入指令之后,shell作为父进程fork出新的子进程,然后执行用户输入的指令,随后再返回。
那么我们完全可以自己写一个shell:
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/wait.h>
#include <string.h>

#define MAX_ARGS 64

int main() {
    char input[256]; // 存储用户输入的命令
    char *argv[MAX_ARGS]; // 用来存放拆分后的参数


    while (1) {
        printf("fake-shell> ");
        fflush(stdout); // 确保提示符立刻显示

        if (fgets(input, sizeof(input), stdin) == NULL) break;
        input[strcspn(input, "\n")] = 0;

        if (strcmp(input, "exit") == 0) break;

        int argc = 0;
        char *token = strtok(input, " "); // 以空格为分隔符
        while (token != NULL && argc < MAX_ARGS - 1) {
            argv[argc++] = token;
            token = strtok(NULL, " ");
        }
        argv[argc] = NULL; // 参数数组必须以 NULL 结尾

        if (argc == 0) continue; // 如果用户直接回车,跳过


        // 创建子进程 (fork)
        pid_t pid = fork();
        printf("子进程被创建\n");

        if (pid < 0) {
            // fork 失败
            perror("fork failed");
            exit(1);
        }
        else if (pid == 0) {
            // ================= 子进程分支 =================
            // 4. 执行命令 (execve)
            // 这里使用 execlp,它是 execve 的封装,会自动去 PATH 环境变量里找 ls
            // 参数:文件名,参数0(程序名),参数1(结束标志NULL)
            printf("子进程执行指令\n");
            execvp(argv[0], argv);

            // 如果 execlp 返回了,说明执行失败了(比如命令不存在)
            perror("exec failed");
            exit(1); // 子进程异常退出
        }
        else {
            // ================= 父进程分支 =================
            // 5. 等待子进程结束 (wait)
            int status;
            waitpid(pid, &status, 0); // 阻塞在这里,直到子进程退出

            // 6. 检查子进程是否正常退出
            if (WIFEXITED(status)) {
                // printf("[Shell] 子进程正常退出,退出码: %d\n", WEXITSTATUS(status));
            }
        }
    }

    printf("Shell exited.\n");
    return 0;
}
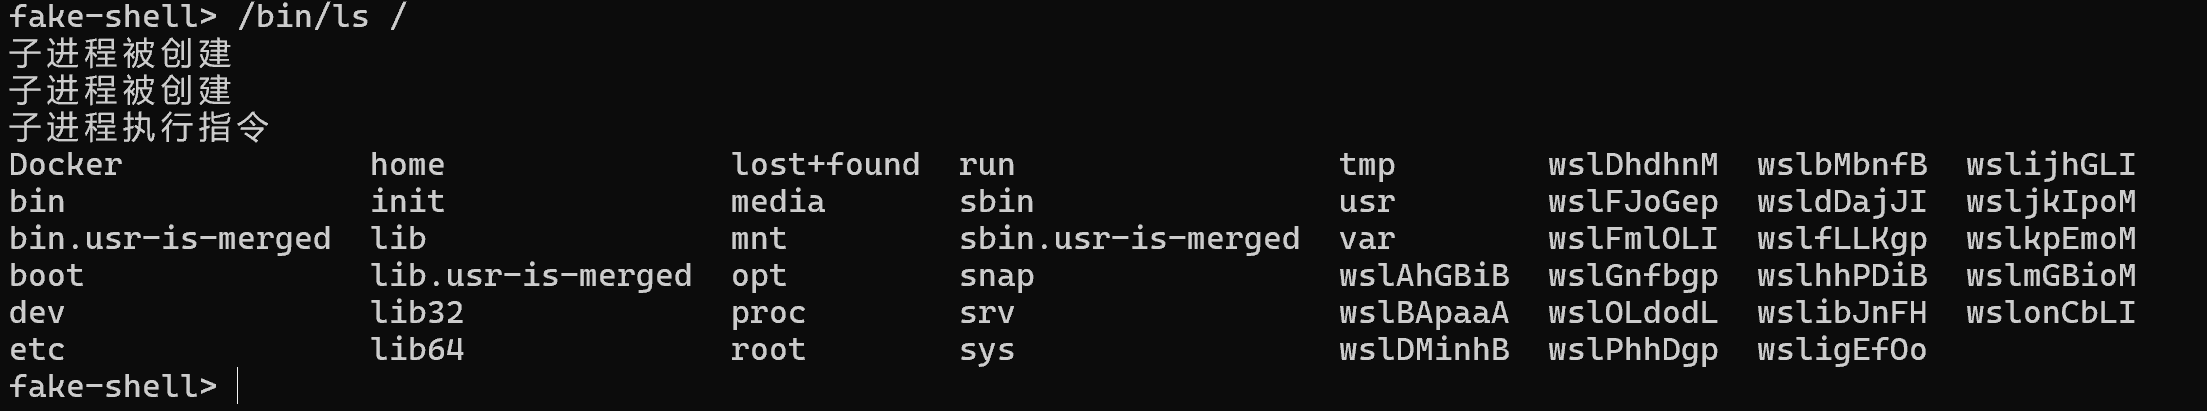
同时,我们也可以加上对&的适配,使其可以支持程序的后台运行。
但是这样会存在一个问题:我们现在的这个shell并不会去关心后台进程,这样的后台进程如果太多,就会导致内存泄漏,进而导致操作系统崩溃。
这就引出了 异常控制流 来帮助我们解决这个问题——内核会在shell的子进程结束的时候告知shell,随后shell就会对此作出反应,并放出waitpid,从而清除僵尸进程。这个告知shell的机制在unix 中被称作信号(signal)
那么,信号是用来通知进程 系统中发生了一次某种类型的事件 的一种标志,并且是最终由进程进行处理的。由内核或进程发出,最终由内核投递给目标进程 (通常来说,是内核发送给进程,但也可以由自己发送,比如调用kill()进行系统调用,向另一个进程发送信号) 。信号被使用一些1-64的数字进行区分。信号所能传递的信息只有一个ID,以及他被发出的事实
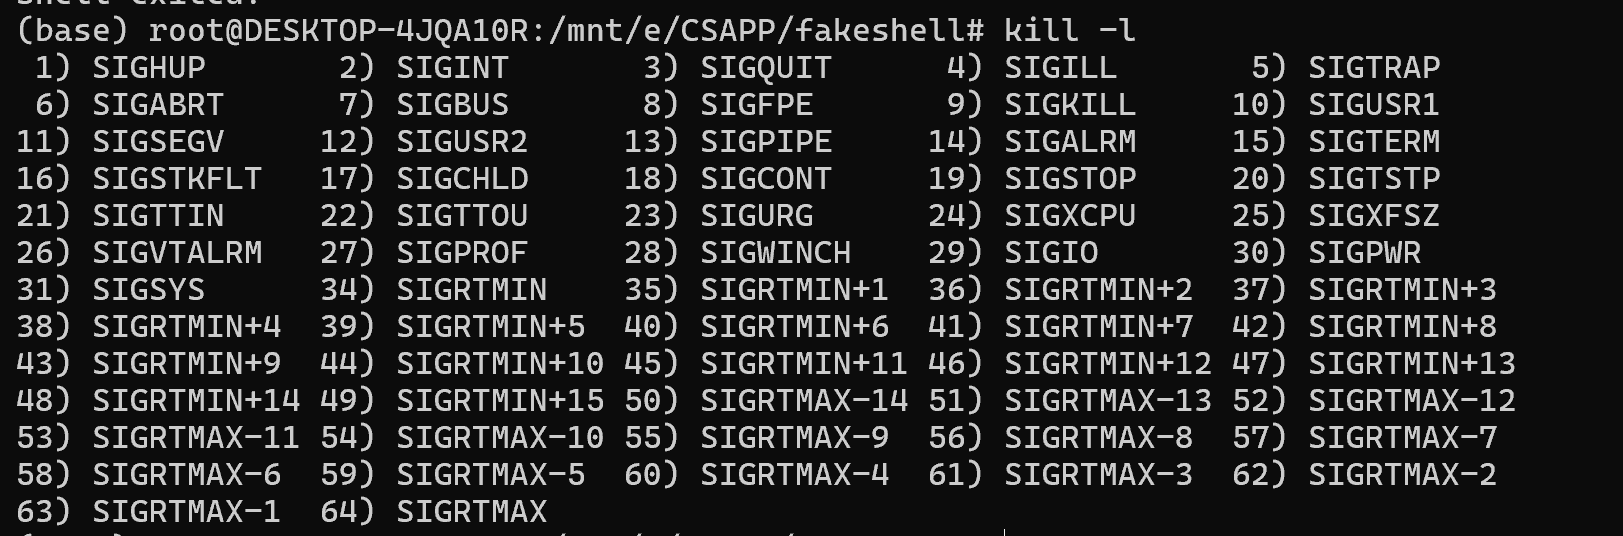
(教材中可能还停留在30,事实上,1-31实际标准信号,34-64是实时信号,32,33被保留给实时线程库使用)
这么一看,似乎 信号 和之前学的 中断 很像,他们有着相同点和不同点:
- 都遵循 异步打断 和 跳转处理
- 中断时硬件层面的打断(比如DMA),信号是软件层面的打断(除0、溢出、非法内存访问等)
有一些常见的信号如下:
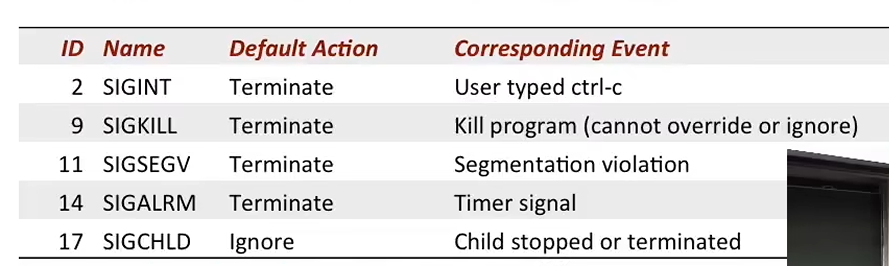
内核向进程传递信号的本质实际上是修改了目标进程的一些上下文状态。
内核发出信号,是有以下原因:1. 内核检测到了一些事件,比如除0、或者子进程的终止 2. 其他进程调用了kill(system call),这让内核向目标发送了信号
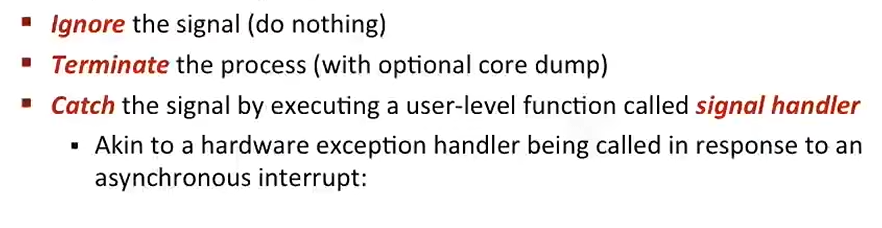
现在 目标进程收到了信号,内核会强制进程在收到信号之后做出应答。有下列常见的响应情况:
-
该信号被忽略
但是 SIGKILL 和 SIGSTOP 是不可被忽略的
-
进程被终止
这是默认行为(Default Action) 。很多信号(比如
SIGINT、SIGTERM、SIGSEGV)如果不做特殊处理,默认就是杀掉进程,有时还会生成 core dump(核心转储文件,用于事后调试)。 -
使用用户级的信号处理函数来捕获
可以通过注册 自定义函数,当信号被接收,内核会强制进程跳去执行这个自定义函数
如果内核发出了这个信号,但是暂时没有被进程接收,我们称这个信号是待处理的
只能有一个相同类型的待处理信号。最为重要的一点是,标准信号是不排队的——例如,如果某进程正在等待处理信号K,下一个信号K又来了,那么这个下一个即将到达的信号会被丢弃掉
Question:
-
信号为什么会等待
情况一:目标进程正在内核态运行(最常见)
- 你按下
Ctrl+C,内核产生 SIGINT。 - 此时,你的进程可能正在执行一个系统调用(比如正在
read 硬盘数据,或者正在 wait子进程)。 - 内核不能在一个系统调用执行到一半时,突然跳去执行信号处理函数(那样会破坏内核的原子性)。
- 所以,内核把信号标记为“待处理(Pending)”,等这个系统调用返回用户态之前,再检查并递送信号。
- 在这段等待时间里,信号就是“等待处理”状态。
情况二:目标进程正在睡眠(被阻塞)
- 进程可能正在
sleep(10),或者阻塞在 wait()上。 - 信号来了,内核会先把信号标记为“待处理”,然后唤醒进程(让它从睡眠变成可运行),等它被调度器选中,准备返回用户态时,再递送信号。
情况三:信号被阻塞(Blocked)
- 进程可以主动告诉内核:“我现在不想处理
SIGINT,先帮我屏蔽它。” - 内核会把
SIGINT 标记为“待处理”,但不递送。直到进程解除屏蔽,才递送。
- 你按下
-
为什么只能有一个相同类型的信号
这是因为内核用来记录待处理信号的数据结构非常“抠门”——它用的是位图(Bitmap) 。
- 在内核的
task_struct(进程控制块)里,有一个字段叫 pending,它是一个 32 位或 64 位的整数。 - 每一位(bit)对应一个信号编号。
- 比如,第 2 位是
SIGINT,第 9 位是 SIGKILL,第 17 位是 SIGCHLD。 - 当信号产生时,内核把对应的位设为 1。它只记录“有”还是“没有”,不记录“有几个”。
所以:
- 如果
SIGINT 的位已经是 1(待处理),此时又来一个 SIGINT,内核发现这一位已经是 1 了,直接丢弃,不会变成 2。 - 这就是“信号不排队”的底层原因——位图无法记录数量。
补充:
标准信号(1-31)不排队,但实时信号(34-64)是排队的。
- 实时信号使用链表或队列来记录,可以同时有多个相同的待处理信号。
- 它们会按照产生的顺序递送(FIFO)。
- 但实时信号是 Linux 特有的扩展,POSIX 标准信号(1-31)依然不排队。
- 在内核的
进程也可以阻塞(Block)信号的接收,也就是阻止进程在接收到信号之后对其进行响应。
待处理信号最多被接收一次
内核会为每个进程在其上下文中分配两个向量——一个是pending,还有一个是blocked。本质上就是一个整数(比如 32 位或 64 位),每一位(bit)对应一个信号编号。上面解释过为什么pending signal没有排队的概念。
当信号被传过来的时候,内核会首先将这个信号的对应位设置为待处理,当信号被开始处理的时候,将对应位清零。
同理,block向量作用类似,当K对应的block位为1,即使pending向量的K位为1,内核也不会传递信号,信号会一直卡在pending。进程可以通过sigprocmask()来控制block向量
对于每一个进程,都有一个进程组将其包含在其中。进程组是一个或多个进程的集合,每一个进程组都有一个唯一的ID(PGID):
-
进程组里面的第一个进程,他的PID就是进程组的PGID
即便是这个第一个进程可能后面死了,这个组的PGID依旧不变
-
只要组里面还有一个进程或者,这个进程组就存在,如果所有进程都死了,那么进程组就消失
就算是组长死了,仍然可以有新的成员加入,只不过新成员的PID不能等于PHGID
顺嘴一提,关于PID:
-
PID 的范围是有限的:
- 在 Linux 中,
/proc/sys/kernel/pid_max文件定义了 PID 的最大值。 - 默认值通常是 32768(或 4194304 在 64 位系统上)。
- 你可以用
cat /proc/sys/kernel/pid_max查看你系统的上限。
- 在 Linux 中,
-
PID 的分配是“循环递增”的:
- 内核分配 PID 时,会从 1 开始,依次递增:1, 2, 3, …, 32768。
- 当达到
pid_max 时,会回绕到 1 重新开始(跳过已经占用的 PID)。 - 所以,PID 是循环使用的。你刚才看到的 PID 671687 死了,过一会儿新进程可能会拿到同样的 PID。
- 并且,内核倾向延迟重用刚释放的 PID,避免某些程序把旧的 PID 误认为新进程。所以 PID 会一直递增一段时间,直到必须回绕。
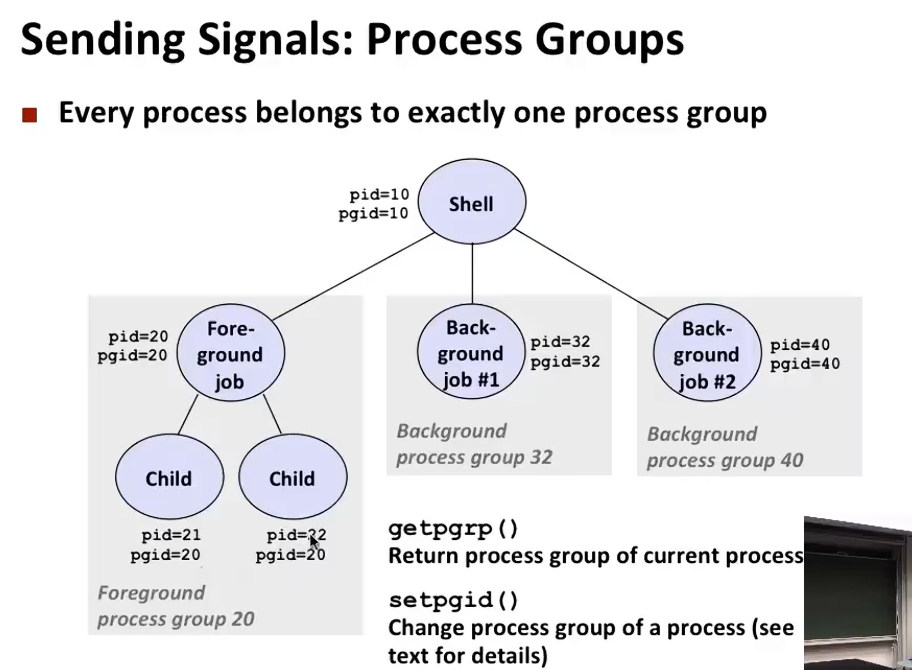
这个概念很重要,因为这就允许了同时向一些列进程发送信号:例如在使用kill杀死进程的时候,就可以通过向进程组ID发送-9,使组里面的所有进程都被终止
直接在shell中输入 Ctrl+C 也会让内核向前台任务发出 SIGINT 信号,进而达到终止的目的。输入 Ctrl+Z 也会让内核发出 SIGTSTP 这意味着暂时终止,直到收到SIGCOUNT才恢复
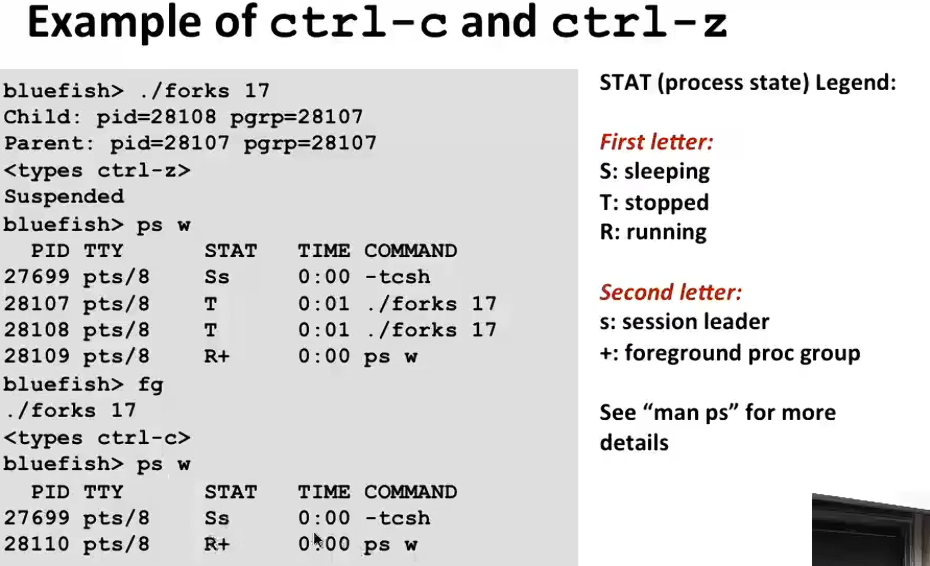
fg指令可以把挂起进程重新在前台激活
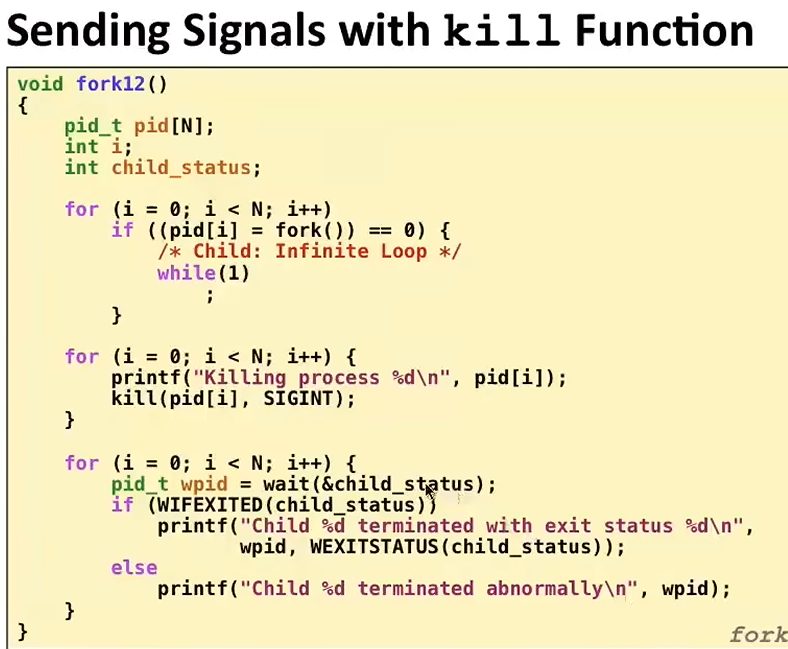
之前提到过,使用kill指令可以实现从另外一个应用向内核发起请求,终止某进程:
顺嘴一问:kill的行为本身其实和kill无关,他就是个向进程传信号的函数,只不过名字刚好叫kill。C语言中的kill() 是对底层ABI的封装调用,实际上还是出发了syscall
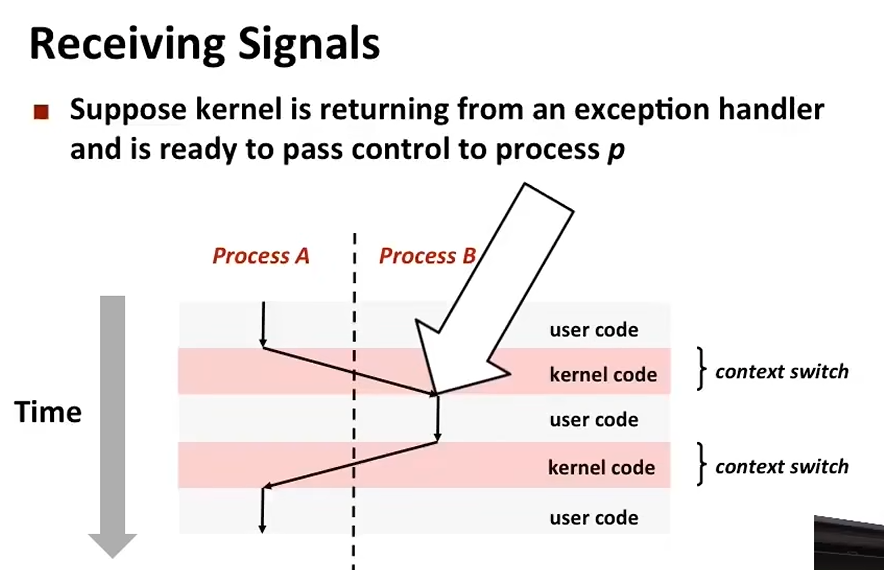
这张图展示了“信号是如何被接收”的,信号接收并检查的时机,发生在从内核态返回到用户态的时刻
- 只有在“内核刚干完活,准备返回用户态”这个瞬间,内核既有完整的控制权,又知道即将要跑谁的代码。此时,如果发现有信号,它就可以强行修改即将返回的用户态的栈和寄存器(比如修改 RIP) ,让进程先去执行信号处理函数,然后再回到正常代码。
具体怎么检查的,看↓:
Linux源码层面的检查
1. 检查发生在哪一行汇编?(物理位置)
当内核完成工作,准备从内核态返回用户态时,它执行的最后一条指令通常是 sysret(或 iretq)。
检查就发生在这条 sysret 指令执行之前的一瞬间。
在 Linux 内核源码中,这个检查点通常位于 exit_to_user_mode_loop() 函数里。它的伪代码逻辑如下:
// 准备返回用户态
while (work_pending()) {  // 检查有没有待办事项(包括信号、调度、通知)
    if (signal_pending(current)) {  // <--- 核心检查就在这里!
        do_signal(current);         // 如果有信号,就去处理它
    }
    // ... 处理其他待办事项
}
// 一切处理完毕,执行 sysret 返回用户态
2. signal_pending() 到底检查了什么?(你的位图知识)
这就是你之前学的 pending 和 blocked 位图发挥作用的地方。signal_pending() 本质上就是做两次位运算:
// 假设 pending 和 blocked 都是 64 位整数
if ( (pending & ~blocked) != 0 ) {
    // 发现有待处理且未被阻塞的信号!
    return true;
}
return false;
-
~blocked:把 blocked位图取反(本来被阻塞的位变成 0,没被阻塞的位变成 1)。 -
pending & ~blocked:做一个“与”运算。- 如果某一位是 1,说明:这个信号既在 pending 里(已产生),又不在 blocked 里(没被屏蔽) 。
-
只要结果不为 0,就说明“有信号需要立刻处理”。
3. do_signal() 具体是怎么做的?(核心逻辑)
一旦发现有待处理信号,内核就会调用 do_signal()。这个函数是信号递送的核心,它做了以下几件事:
第一步:找到优先级最高的信号
- 内核会遍历
pending & ~blocked的结果,找到编号最小的那个信号(或者按优先级排序)。 - 假设找到了信号
k。
第二步:准备用户态栈帧(伪造函数调用)
内核需要让进程在返回用户态后,看起来像是“被一个函数调用了”。它在用户态的栈上压入:
- 当前的寄存器状态(RIP、RSP、RAX 等)。
- 信号处理函数的入口地址。
- 信号编号
k。 - 一个特殊的返回地址(指向信号返回桩
sigreturn的代码)。
第三步:清零 pending 位
- 内核将
pending 位图中的第 k 位设为 0。这代表“这个信号已经被递送了,不再处于待处理状态”。 - 注意:这一步是在跳转到 Handler 之前完成的。
第四步:修改寄存器上下文
- 内核把 CPU 的 RIP 寄存器修改为信号处理函数的入口地址。
- 把 RSP(栈指针)修改为刚才伪造的栈帧地址。
- 此时,CPU 的“返回用户态”目标,不再是原来的下一条指令,而是信号处理函数。
4. 返回用户态后的“交接棒”
- 内核执行
sysret指令,CPU 从 Ring 0 切回 Ring 3。 - CPU 的 RIP 指向信号处理函数,开始执行。
- 信号处理函数执行完毕后,执行
ret指令,返回到那个“特殊的返回地址”(信号返回桩)。 - 信号返回桩执行
sys_sigreturn系统调用,再次陷入内核。 - 内核从用户态栈上恢复之前保存的原始寄存器(RIP 设回
I_next,RSP 设回原栈)。 - 最后再执行
sysret,这次真正返回被中断的代码,继续执行。
5. 一个容易被忽略的细节:为什么检查必须在内核态进行?
因为修改用户态的栈和寄存器是特权操作。只有在内核态(Ring 0),内核才有权限去写用户态的内存(通过 copy_to_user 等函数),也才有权限去直接修改 CPU 的 RIP/RSP 寄存器。
如果在用户态检查,恶意进程可以伪造一个假的栈帧,欺骗内核跳转到任意地址(这就是提权漏洞)。所以,检查必须由内核在内核态完成,且用户态代码不能干预这个过程。
总结
你问“到底是怎么检查的”,答案就是:
- 物理位置:在
sysret返回用户态之前。 - 检查逻辑:通过位运算
(pending & ~blocked) != 0判断是否有待处理且未阻塞的信号。 - 递送动作:内核在用户态栈上伪造栈帧,修改 RIP/RSP 寄存器,把执行流劫持到信号处理函数。
- 清零时机:在跳转到 Handler 之前,内核将
pending对应位清零。
接收信号总是会触发一些动作,每种信号都有预定义的行为,包括:
- 终止进程
- 挂起进程,直到接收到SIGCOUNT
- 忽略此信号
我们可以用一个叫做signal的系统调用来修改这些默认行为:
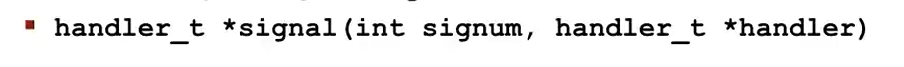
对于handler 我们可以用SIG_IGN(表示忽略signum这个信号),或者SIG_DFL(使用系统默认的信号行为),还可以是用户自己定义的函数,比如这样:
#include <stdio.h>
#include <signal.h>
#include <unistd.h>

// 1. 这就是你要传给内核的“句柄”函数
void my_handler(int sig) {
    printf("我抓到了信号 %d,我覆盖了信号行为,按Ctrl+C是没用的!\n", sig);
}

int main() {
    // 2. 把这函数的地址(my_handler)作为第二个参数传给 signal
    // 意思就是:把 my_handler 安装(install)到 SIGINT 上
    signal(SIGINT, my_handler);

    while (1) {
        printf("程序运行中... 按 Ctrl+C 试试\n");
        sleep(1);
    }
    return 0;
}
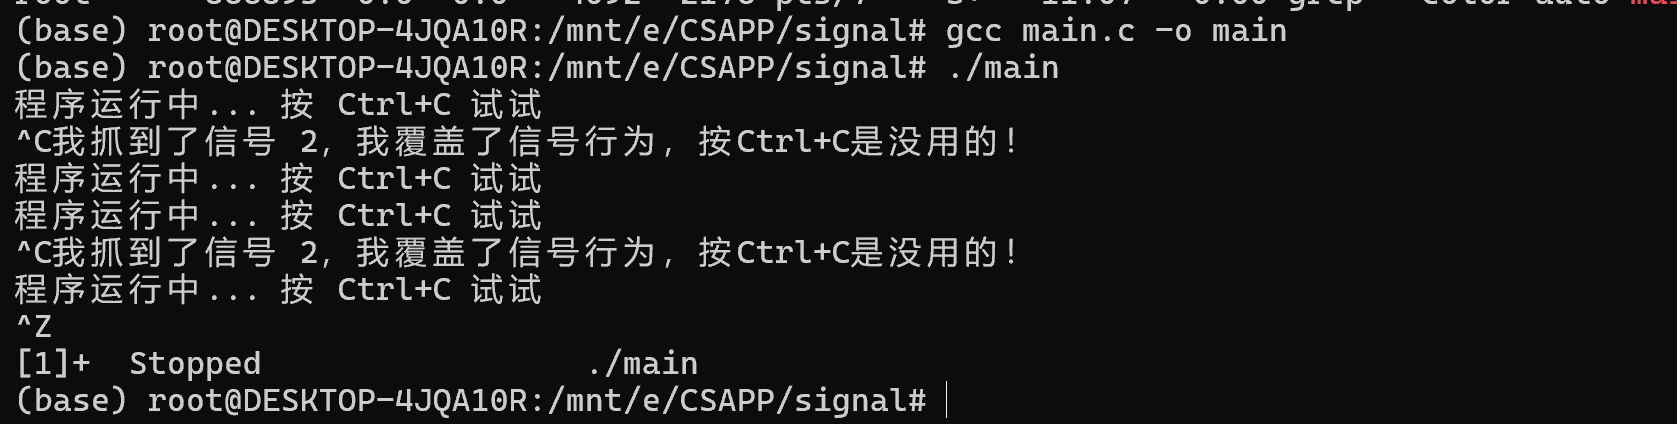
那么就有个问题了,“我不调用signal(),进程不就是在用默认行为吗,为什么还要专门一个SIG_DFL 来恢复”,有这样一个例举:
- 你的 Shell 程序一开始运行,出于某种原因(比如防止被 Ctrl+C 杀死),它调用了
signal(SIGINT, SIG_IGN),把 Ctrl+C 忽略了。 - 后来,你的 Shell 执行完了一段关键代码,不想再忽略 Ctrl+C 了,它想恢复成“按 Ctrl+C 就退出”的正常状态。
- 此时,它就可以调用
signal(SIGINT, SIG_DFL)。这相当于告诉内核:“我撤销之前的忽略设置,恢复成你出厂时的默认处理规则(也就是杀掉进程)。 ”
那么,这个机制的存在,使得信号处理和主进程可以看作是并发的:
#include <stdio.h>
#include <signal.h>
#include <unistd.h>
#include <string.h> // 需要用到 strlen

// 1. 这就是你要传给内核的“句柄”函数
void my_handler(int sig) {
    char msg1[] = "我抓到了信号,我覆盖了信号行为,按Ctrl+C是没用的!\n";
    write(1, msg1, strlen(msg1));

    char msg2[] = "句柄的信号处理被执行,即将 sigreturn,结束对信号的处理回到主分支\n";
    write(1, msg2, strlen(msg2));
}

int main() {
    // 2. 把这函数的地址(my_handler)作为第二个参数传给 signal
    signal(SIGINT, my_handler);

    while (1) {
        // 【修正】pritnf -> printf,并加上分号
        printf("程序运行中... 按 Ctrl+C 试试\n");
        printf("这句话代表 main 里面的循环仍然在进行\n");

        // 注意:printf 通常有行缓冲,加上 fflush 保证立刻输出到屏幕
        fflush(stdout);

        sleep(1);
    }
    return 0;
}
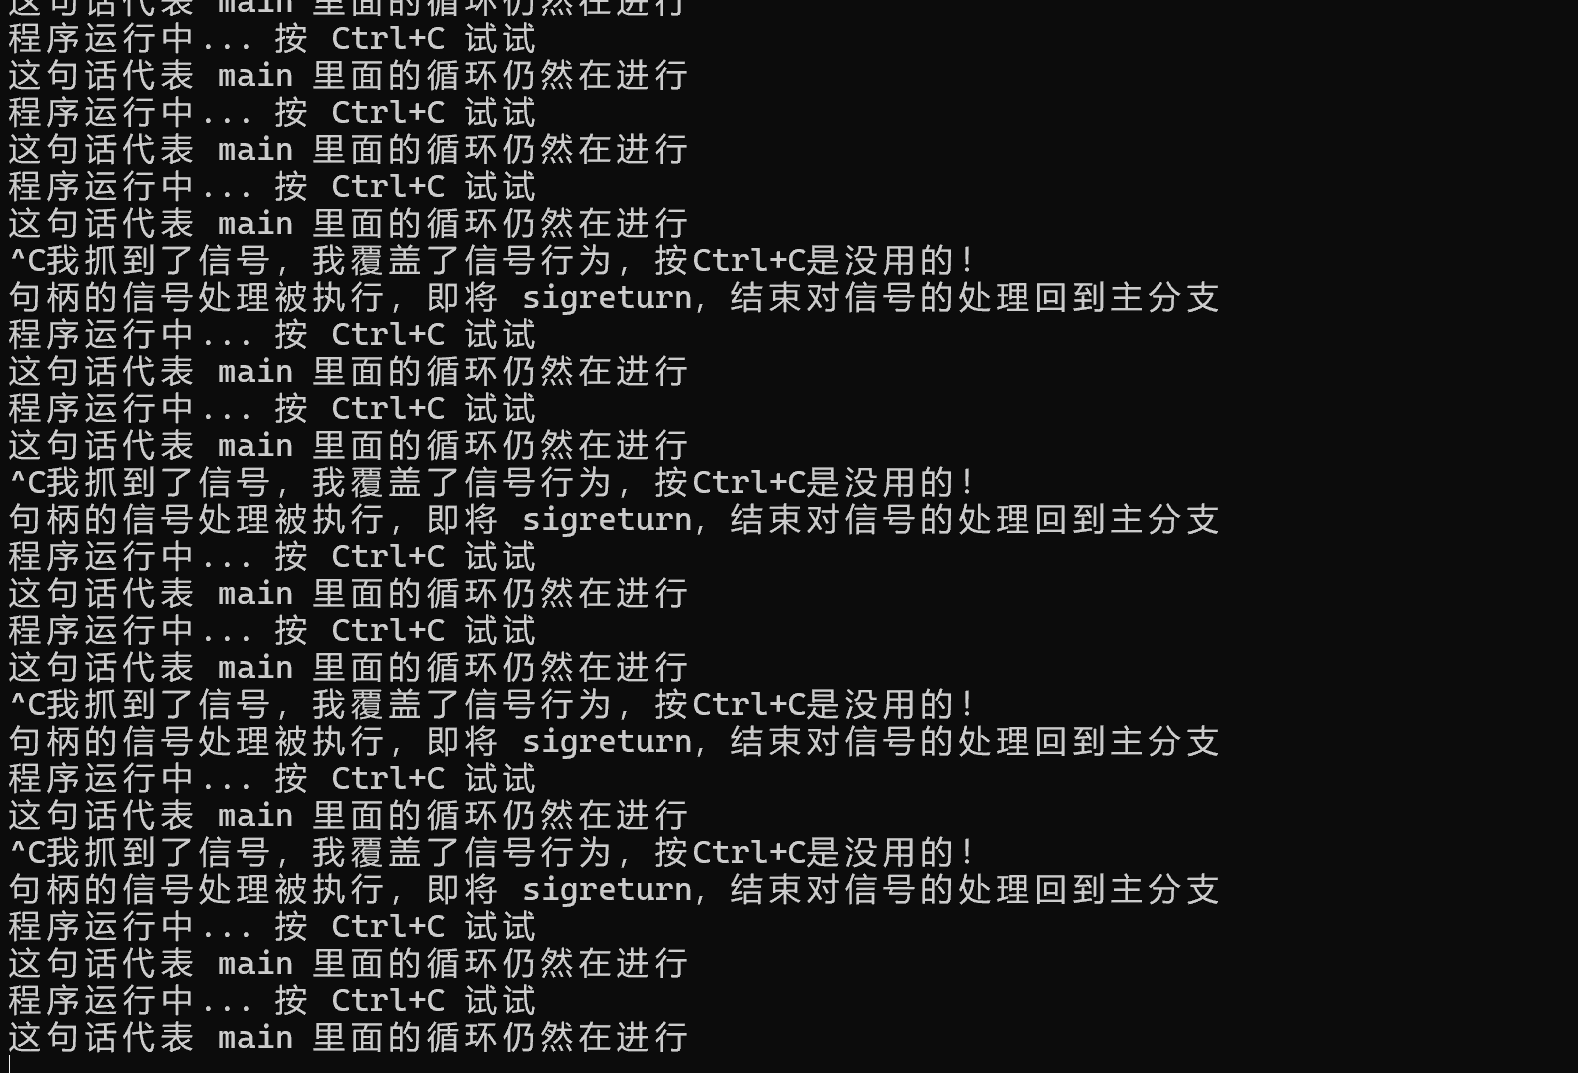
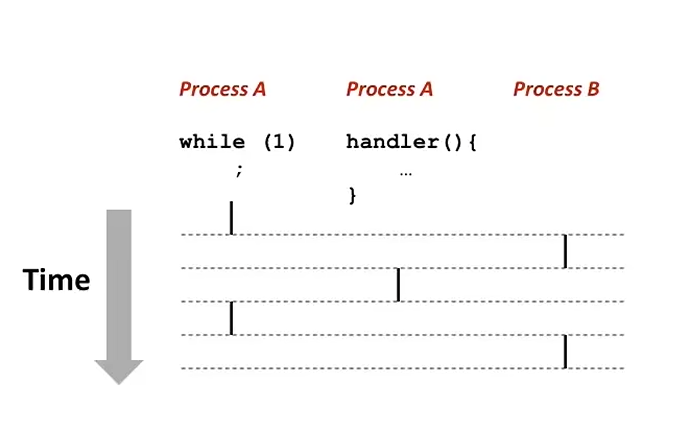
这个信号处理handler会和主进程共享一个PID,也因此使用同一个内存空间,共享所有的全局变量等
对于handler来说,本质上也是用户态程序,所以当信号从接收,到被处理,经历了这些过程:
-
信号产生,比如用户按下了Ctrl+C,内核在目标位置先将位置向量设置成1
-
当时机成熟的时候(程序从内核态向用户态返回),内核发现pending对应为1,block对应为0,内核决定传递这个信号。随后在目标进程用户态栈上 压入当前寄存器的状态(RIP,RSP,RAX等),随后在用户态栈上构造一个“假的函数调用栈”,把信号处理函数
my_handler的地址压入,并传入信号编号作为参数。随后 内核将pending对应位清零,代表这个信号传输过了
内核修改 CPU 的 RIP 寄存器,使其指向
my_handler的入口地址;修改 RSP,指向刚才伪造的栈帧。最后内核执行
sysret指令,CPU 从 Ring 0 切回 Ring 3。 -
现在CPU在用户态下,RIP指向了my_handler 开始执行信号处理程序
当handler处理结束之后,编译器与内核合作插入的代码会执行sys_sigreturn(system call) CPU重新回到内核态
-
回到内核态之后,内核把刚才保存的寄存器状态等恢复,让RSP RIP归位,重新指向原本程序应该执行的地方,随后,执行sysret 回到用户态
-
主程序从刚才被打断的地方继续执行
信号处理是可嵌套的:
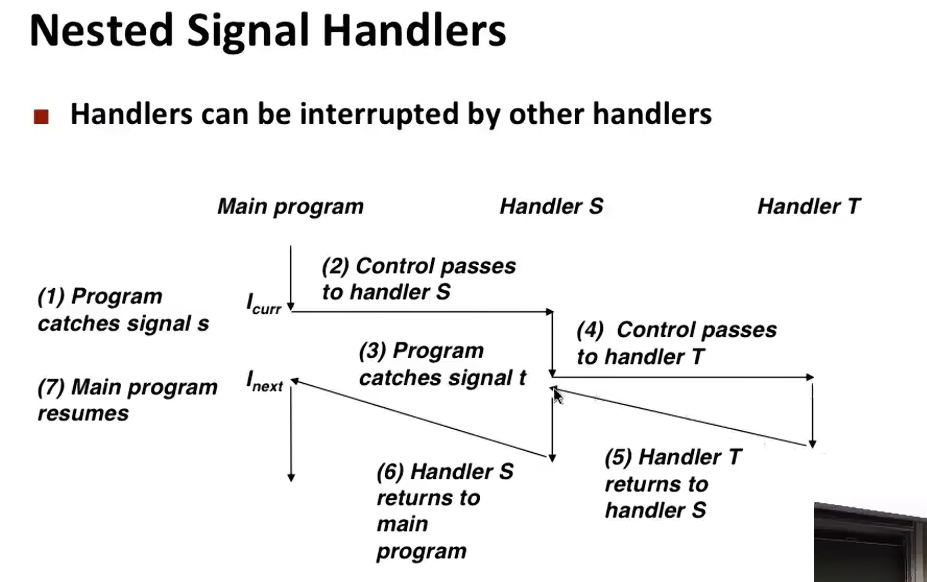
为什么要设计成可嵌套的呢?原因在于内核必须保证优先级高的的信号能够及时打断优先级低的信号处理,否则系统可能来不及响应致命错误。
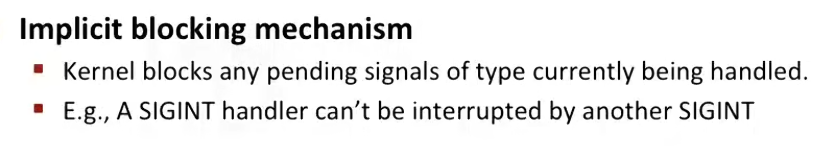
同时,内核也需要防止“无限嵌套”,比如信号T和信号S实际上是同一个,那么内核会暂时阻塞信号的处理。
对于信号的阻塞和解阻塞,我们使用sigprocmask()函数来完成(实际上是sys_sigprocmask的system call):
int sigprocmask(int how, const sigset_t *set, sigset_t *oldset);
how: 如何改,加入阻塞SIG_BLOCK,解除阻塞SIG_UNBLOCK,直接替换SIG_SETMASK
set:指向一个信号集 sigset_t(这个在内核中是一个复杂的数据结构),告诉内核要操作哪些信号
oldset:如果不为空,内核会把修改之前的旧位图保存在这里
对于信号集(sigset) 有四个辅助函数:
-
sigemptyset(&set) :清空集合。- 把
set里所有位设为 0。 - 为什么需要它? 这是一个“初始化”动作。通常你先声明一个
sigset_t set;,然后立刻调用 sigemptyset(&set);,确保里面没有脏数据。
- 把
-
sigfillset(&set) :填满集合。- 把
set里所有位设为 1(代表所有信号)。 - 应用场景:你想暂时屏蔽所有信号,保护一段极其关键的代码。先
sigfillset,再 sigprocmask(SIG_BLOCK, &set, NULL)。
- 把
-
sigaddset(&set, SIGINT) :添加信号。- 把
SIGINT对应的位设为 1。 - 应用场景:你想屏蔽
SIGINT 和 SIGCHLD,就连续调用两次 sigaddset。
- 把
-
sigdel set(&set, SIGINT) :删除信号。- 把
SIGINT对应的位设为 0。 - 应用场景:你想解除对
SIGINT的阻塞。
- 把
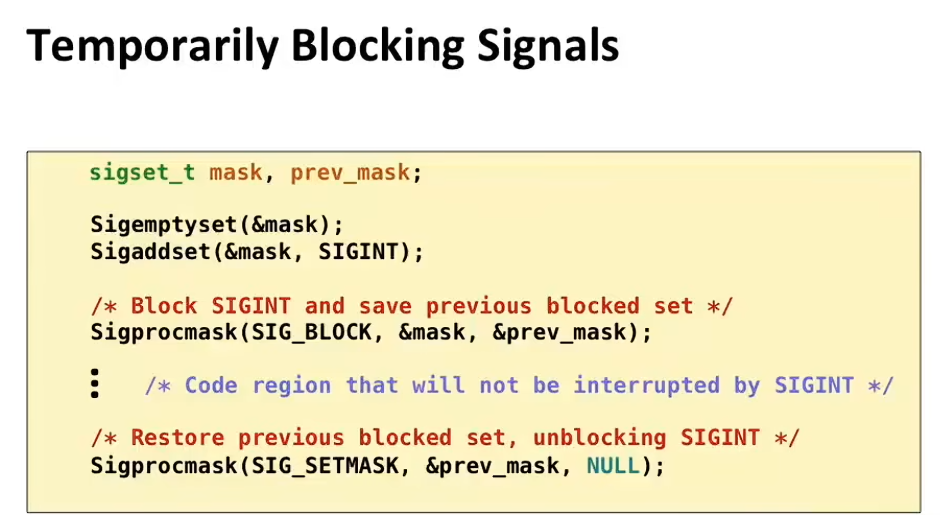
在这个例子中,我们临时阻塞了一组信号:
- mask集合被清空,全部置0
- mask里面的SIGINT位置变成1
- 执行sigprocmask,看到SIG_BLOCK说明需要把mask里面的信号加到进程屏蔽字中,并且会进程原有的blocked位图拷贝到prev_mask
- 程序执行完之后 将阻塞状态恢复到prev_mask
信号处理是一个独立的逻辑流,他可以随时打断主程序的运行,这就可能导致出现:
-
共享全局变量:你的主程序和 Handler 都可以访问同一个全局变量
int counter = 0;。 -
非原子操作:
counter++ 在汇编层面不是一条指令,而是三条:读内存 -> 加 1 -> 写回内存。 -
竞态条件(Race Condition) :
- 主程序读取
counter(值为 0)。 - 此时信号来了! 跳进 Handler。
- Handler 也读取
counter(还是 0),加 1,写回(现在 counter = 1)。 - Handler 返回。
- 主程序接着执行刚才没做完的加法:把之前读到的 0 加 1,写回内存。
- 结果:两次
counter++ ,但 counter 只变成了 1。数据丢失了!
- 主程序读取
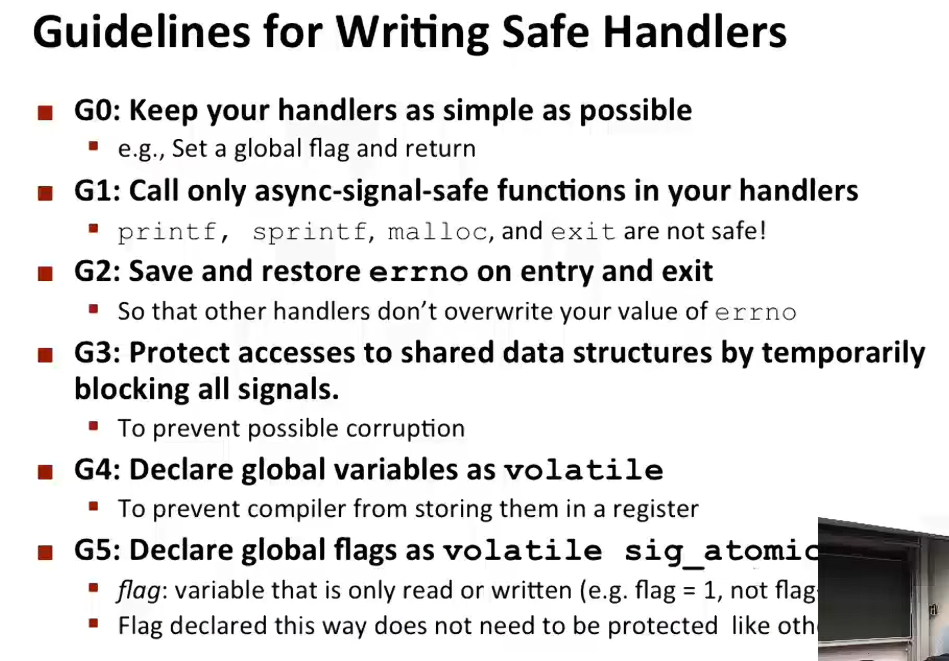
略有出入,但是可以用下列来说:
- 越简单越好:Handler 里只做最紧急的事(比如设置一个全局标志
flag = 1,或者把数据写入一个全局数组)。 - 只调用“异步信号安全”的函数:只能调用
write、_exit、waitpid 等少数函数。绝对不能调用 printf、malloc、free、exit。 - 保护共享数据:在修改全局变量前后,用
sigprocmask阻塞信号,防止被打断。 - 使用
volatile 关键字:告诉编译器这个全局变量是“易变”的,不要把它优化到寄存器里,每次都去内存里读。
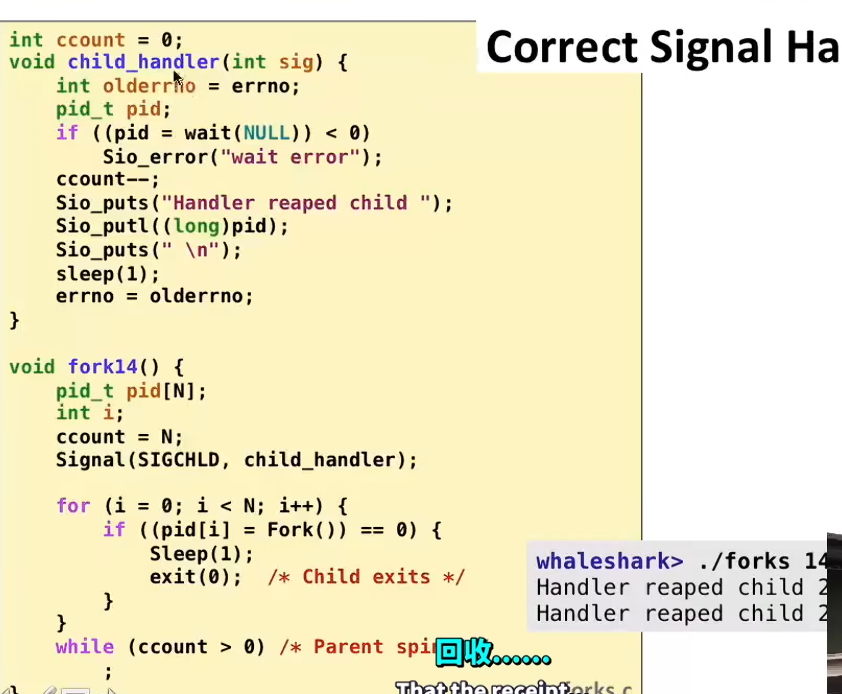
在这个例子中,虽然创建了5个子进程,但是实际上只回收了两个
问题一:在 Handler 里调用 sleep(1) (致命错误)
你注意看 child_handler 函数里有一句:
sleep(1);
这是一个极其危险的操作。
- 为什么危险?
sleep 不是“异步信号安全”的函数。更重要的是,它会让信号处理函数阻塞整整 1 秒。 - 后果:在这 1 秒内,如果还有其他子进程也退出了,内核会发送
SIGCHLD。但因为当前进程正在处理 SIGCHLD(且该信号通常默认被自动阻塞),新的 SIGCHLD会被挂起(Pending)。 - 最致命的:因为标准信号不排队,如果在这 1 秒内有多个子进程同时死掉,它们产生的多个
SIGCHLD 只会被记录为一个待处理信号。等 sleep 结束,Handler 只执行一次 wait,回收了一个子进程,剩下的子进程就变成了僵尸。
问题二: while (ccount > 0) ; 死循环(常见陷阱)
父进程在主函数里写了一个忙等待循环:
while (ccount > 0)
    ;  // 空循环,死等
- 父进程在这里疯狂消耗 CPU,等待
ccount减到 0。 - 陷阱所在:
ccount 是一个全局变量。父进程在 while里读取它,Handler 里修改它。 - 并发冲突:如果父进程的
while 正好读到 ccount 的值到寄存器里,此时信号来了,Handler 把 ccount减了 1 并返回。父进程继续用寄存器里的旧值判断,导致循环永远无法退出。 - 即使没有并发冲突,如果子进程死得太快,或者父进程在 Handler 执行完之前就进入了循环,逻辑也会很混乱。
问题三:Handler 里的 wait 没有循环(经典的 SIGCHLD 丢失问题)
这是最隐蔽、也是最核心的 Bug。看 Handler 里的代码:
if ((pid = wait(NULL)) < 0)  // 只 wait 一次!
    Sio_error("wait error");
ccount--;
- 如果多个子进程同时死亡,内核发来一个
SIGCHLD。 - 因为标准信号不排队,这个信号只会被递送一次。
- 你的 Handler 只调用了一次
wait,回收了一个子进程。 - 剩下的子进程就变成了僵尸,永远卡在进程表里。
ccount 也不会减到 0,父进程的 while循环就永远退不出来。
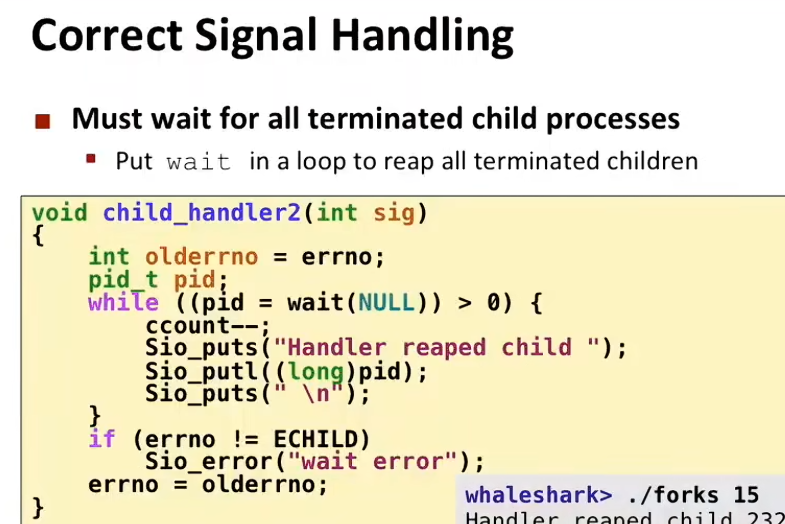
这里就完成了对刚才所说的,“只wait一次”的bug的修复。就算是只收到一个SIGCHILD,也能完成对五个子进程的回收
有一个细节,在最开始的时候,对errorno做了一个备份操作:
- 为什么这么做? 因为
wait() 在成功时会返回 PID,但在没有更多子进程可回收时,它会返回 -1 并设置 errno = ECHILD(No child processes)。 - 如果不在最后恢复
errno,那么当 Handler 返回后,主程序如果检查 errno,可能会误以为之前某个系统调用失败了,从而导致逻辑错误。 - 这就是为什么代码里那句
if (errno != ECHILD) Sio_error(...) 很重要——它确认了 wait返回 -1 不是因为出错,而是因为“所有子进程都回收完了”。
早期的UNIX对信号管理非常混乱,为了让你的代码在所有系统上都能正确运行,不要直接用老旧的 signal() 函数,而是要使用更现代、更强大的 sigaction() 函数。
-
罪状一:“有些系统捕获信号后,会自动恢复默认行为”
- 在旧系统中,你注册了
SIGINT 的 Handler。当信号来临时,Handler 执行。执行完后,系统自动把 SIGINT的处理方式改回默认(也就是杀掉进程)。 - 后果:如果你想让 Handler 一直生效,必须在 Handler 内部再调用一次
signal()重新注册。这非常麻烦,而且容易漏掉。
- 在旧系统中,你注册了
-
罪状二:“有些被中断的系统调用会返回 errno == EINTR”
- 这是你截图底部字幕在说的重点。假设你的程序正在
read()一个慢速设备(比如键盘),阻塞在那里。 - 此时一个信号来了,跳去执行 Handler。Handler 执行完返回。
- 有些系统不会自动恢复
read(),而是让它直接返回 -1,并设置 errno = EINTR(Interrupted system call,系统调用被中断)。 - 后果:你的代码必须手动检查
EINTR,如果发现是这个错误,就要重新调用 read()。如果不写这个检查,程序就会莫名其妙地报错。
- 这是你截图底部字幕在说的重点。假设你的程序正在
-
罪状三:“有些系统不会阻塞正在处理的信号”
- 你正在执行
SIGINT 的 Handler,此时又来了一个 SIGINT。 - 有些系统允许它打断当前的 Handler,形成嵌套(你之前学过嵌套 Handler 的危险性)。
- 有些系统则默认阻塞它,等当前 Handler 执行完再处理。
- 你正在执行
下列程序使用sigacion
handler_t *Signal(int signum, handler_t *handler) {	//包装
    struct sigaction action, old_action;

    action.sa_handler = handler;          // 1. 设置处理函数
    sigemptyset(&action.sa_mask);         // 2. 处理期间,阻塞哪些额外信号?
    action.sa_flags = SA_RESTART;         // 3. 关键!自动重启被中断的系统调用

    if (sigaction(signum, &action, &old_action) < 0)
        unix_error("Signal error");
    return (old_action.sa_handler);
}
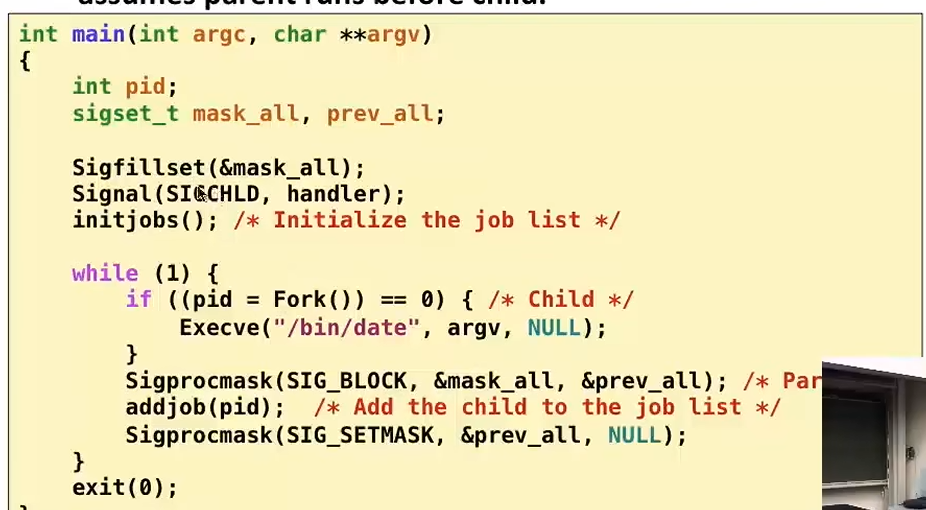
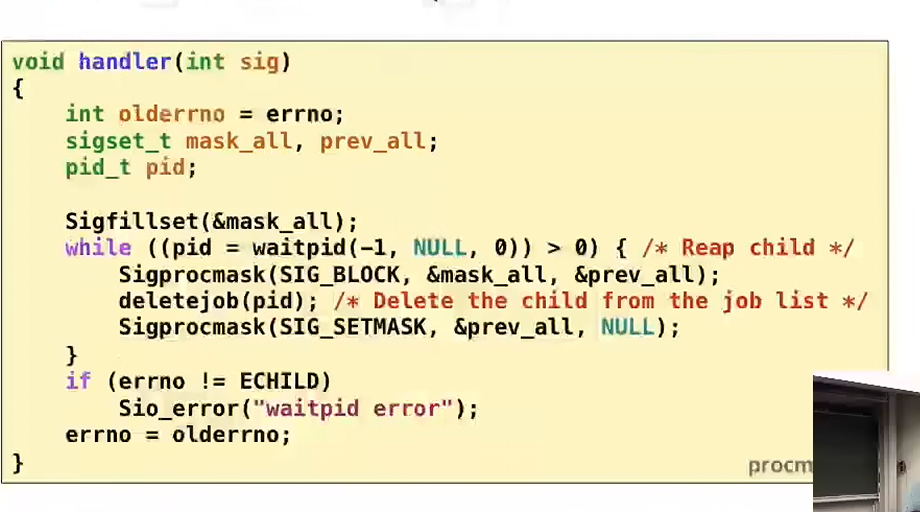
这段代码存在两次次信号屏蔽(父进程、子进程中),是为了维护共享的任务队列
如果没有,就有可能存在条件竞争的BUG:由于不知道父进程子进程谁先运行,可能会出现这种情况:子进程注册,随后很快的完成了任务,在父进程将其addjob(pid)之前就已经通过触发signal handler 并尝试将自己的pid进行删除,但是当前并不存在这个PID。
因此,有下列的修复:
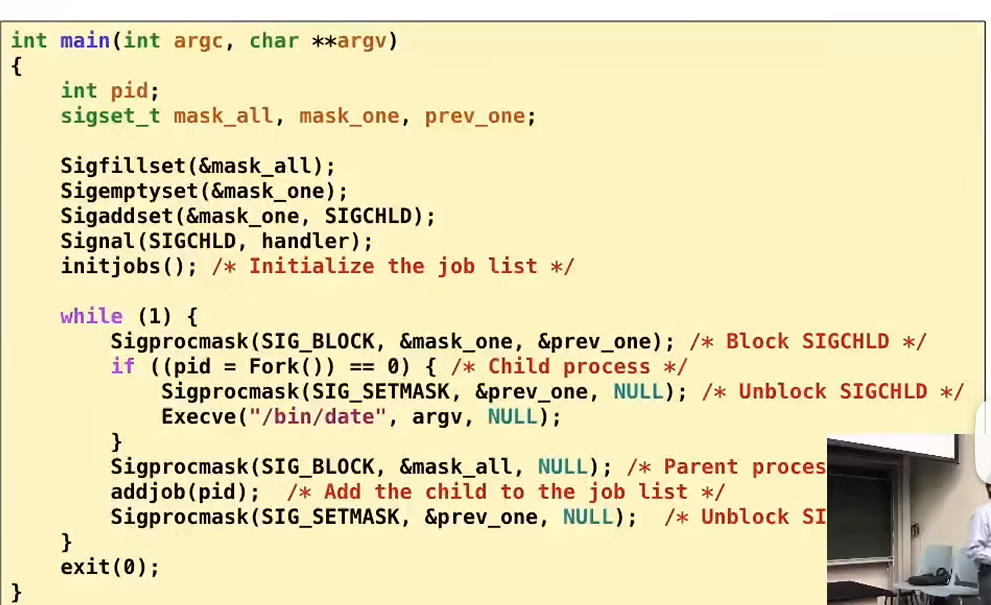
在父进程进行fork之前,就已经阻塞了SIGCHILD信号。这样就必须等到addpid被完成了之后,handler才能受理SIGCHILD。等于是限制时序
显式等待信号:
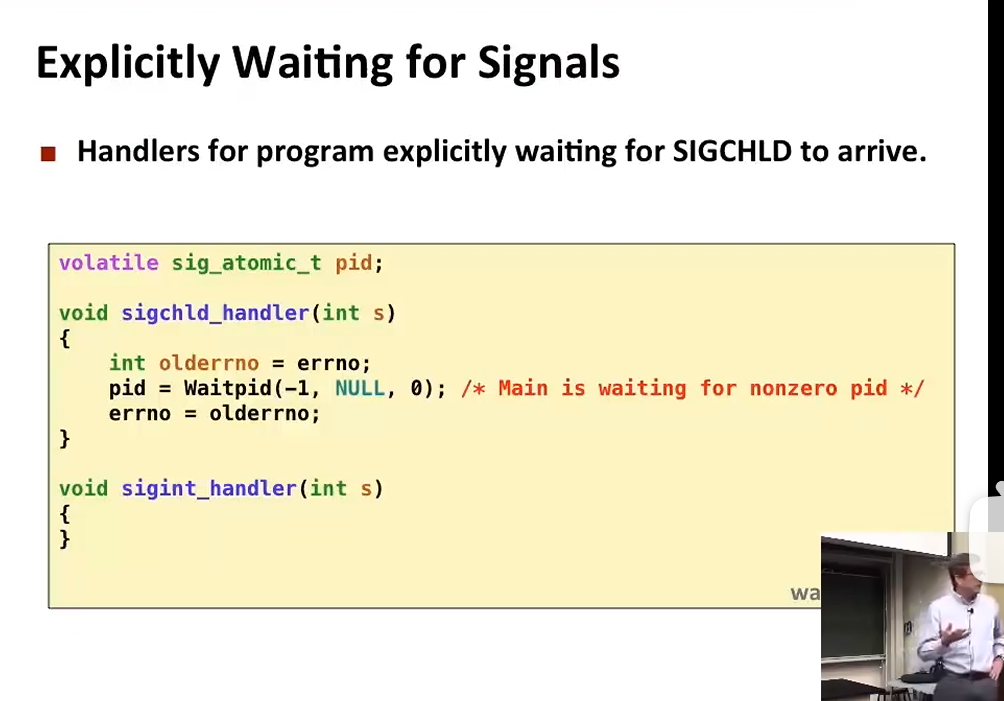
volatile:意思是告诉编译器,这个变量是“易变”的。因为它在主程序和 Handler 之间共享,编译器不能把它优化到寄存器里,每次必须从内存里读取。
sig_atomic_t:这是一个特殊的整数类型,保证在信号处理期间对他的读写是原子的
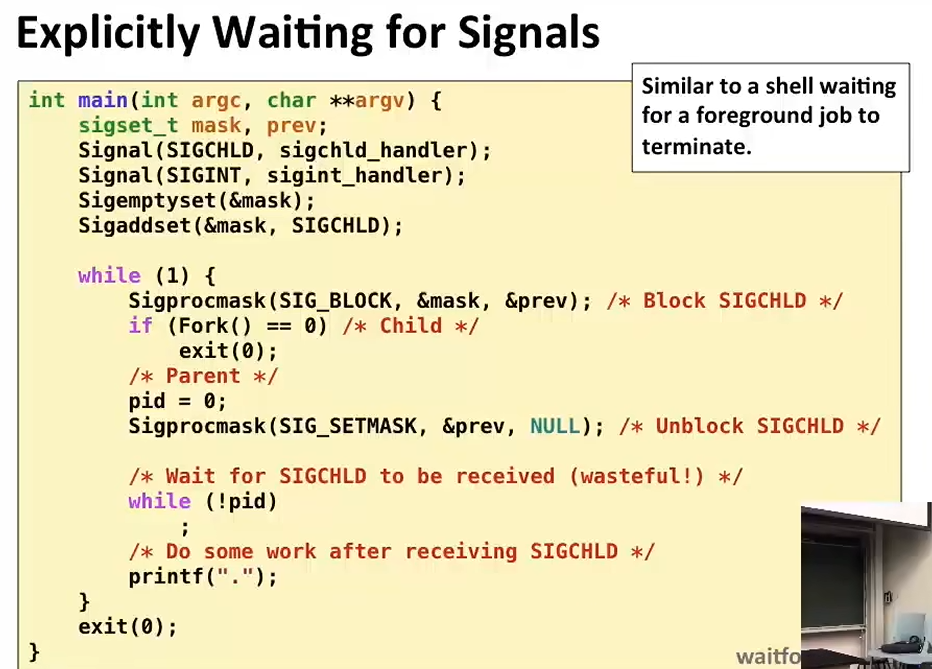
如果while里面用sleep() 这回非常的占用时间并且消耗资源。那如果用pause()呢?
补充关于pause的特性:
pause() 这个系统调用的定义是: “将当前进程挂起(睡眠),直到收到一个信号。”
这句话的关键在于:
- 如果没有收到信号,
pause()永远不会返回。 - 如果
pause() 不返回,CPU 就永远卡在 CALL pause 这条指令上,根本不会执行 JMP loop_start (跳回循环开头) 。
1. while (!pid) 在 CPU 眼里是什么?
当你写 while (!pid) pause(); 时,编译器会把它翻译成类似这样的汇编代码:
loop_start:
    LOAD  pid      ; 1. 从内存把 pid 读取到寄存器
    TEST  寄存器   ; 2. 检查这个值是不是 0
    JNE   exit_loop ; 3. 如果不是 0,跳出循环
    CALL  pause    ; 4. 如果是 0,调用 pause() 挂起
    JMP   loop_start ; 5. 返回循环开头,再检查一次
exit_loop:
    ...
你看,while (!pid) 这一个表达式,实际上包含了加载(LOAD) 和 判断(TEST) 两个步骤。
“还没执行完 pause”的精确含义是:
CPU 执行完了第 2 步(TEST 发现是 0),决定要跳去执行第 4 步(CALL pause)。但在第 2 步和第 4 步之间,有一个极短的指令间隙。
2. 把你描述的竞态翻译成汇编级时间线
让我们把那个“致命的瞬间”对应到这几条汇编指令上:
| 时间 | CPU 执行的汇编指令 | 发生了什么 | 寄存器/内存里的 pid 值 |
|---|---|---|---|
| T1 | LOAD pid |
父进程把 pid 读到寄存器 | 0 |
| T2 | TEST 寄存器 |
检查发现是 0,决定不跳转,准备去 call pause | 0 |
| T3 | 【硬件中断!】 | 就在这个间隙,内核调度器决定切换进程,或者 SIGCHLD 到了 | 0 |
| T4 | (跳去执行 Handler) | Handler 执行waitpid,然后执行pid = 1234; |
1234 |
| T5 | (Handler 返回) | 控制流回到主程序 | 1234 |
| T6 | CALL pause |
父进程执行 pause(),挂起自己 | 1234 |
| T7 | (永远沉睡) | pause 等待下一个信号。但子进程已死,SIGCHLD 已处理完 | 1234 |
关键点就在 T3:
- CPU 已经检查过了
pid == 0,它已经在寄存器里决定“我要去执行 pause 了”。 - 就在这个瞬间,信号来了。CPU 暂停主程序,去跑 Handler。
- Handler 把内存里的
pid改成了 1234。 - 但是!寄存器里的那个旧值(0)并没有变,因为那个值是在 T1 时加载的。CPU 的“决定”已经做出,它不知道内存已经变了。
- 所以 Handler 返回后,CPU 继续执行 T6:无条件地执行
CALL pause。 - 此时
pause() 真的被调用了。它检查有没有新的信号,发现没有(因为信号已经在 T4 被 Handler 处理了),于是挂起。 - 而主程序因为已经“过了”那个判断点,不会再回去重新检查
pid,所以它永远不会知道 pid已经变成了 1234。
总而言之:就是在这一个小段的时间内PID变化,导致错过了pause对sigchild信号的捕捉,从而导致循环死锁
为了解决上述的问题,最直接的办法就是消除这一段时间间隙。因而,引入了sigsuspend()——其本质是一个原子的“阻塞-挂起-恢复”
真实的sigsuspend(),是一个sys_sigsuspend调用,伪代码大致长这样:
int sys_sigsuspend(sigset_t *mask) {
    // 1. 关中断(或者获得一个全局锁,保证原子性)
    disable_interrupts();

    // 2. 修改当前进程的 blocked 位图(解除阻塞)
    current->blocked = *mask;

    // 3. 检查 pending 位图
    if (has_pending_signal(current)) {
        // 如果有待处理信号,立刻返回,不挂起
        enable_interrupts();
        return -EINTR;
    }

    // 4. 如果没有待处理信号,把进程挂起(睡眠)
    // 注意:挂起操作是在“关中断”的状态下完成的
    schedule_sleep(current);

    // 5. 当信号来临时,内核会唤醒这个进程,恢复它的 blocked 位图
    // ...

    enable_interrupts();
    return 0;
}
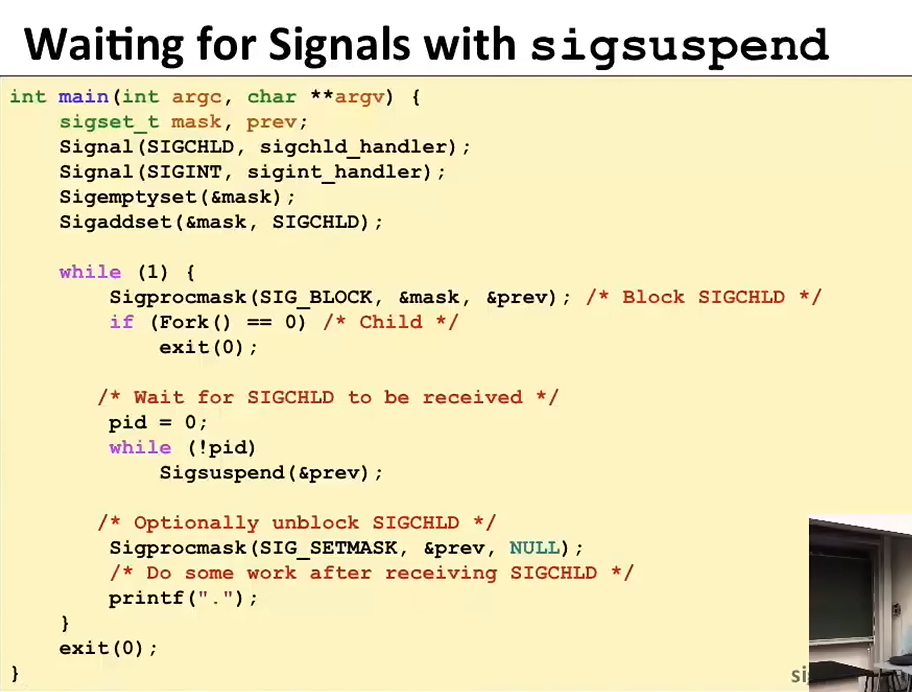
相比于pause,sigsuspend 的精髓在于:如果信号在 sigsuspend 执行前就到了,它会立刻返回,绝不会挂起。
| 时间 | 动作 | 结果 |
|---|---|---|
| T1 | 父进程检查pid== 0 |
决定调用sigsuspend |
| T2 | 父进程开始执行sigsuspend系统调用 |
进入内核 |
| T3 | 【信号到达!】 | 内核发现SIGCHLD已 Pending |
| T4 | 内核不挂起,立刻返回sigsuspend |
父进程从sigsuspend返回 |
| T5 | 父进程回到while (!pid)重新检查 |
此时信号可能还没被 Handler 处理 |
| T6 | 内核在返回用户态前递送SIGCHLD |
Handler 执行,pid = 1234 |
| T7 | Handler 返回 | 父进程继续 |