L10 Program Optimization
常见的优化,比如对于二维数组索引的优化:
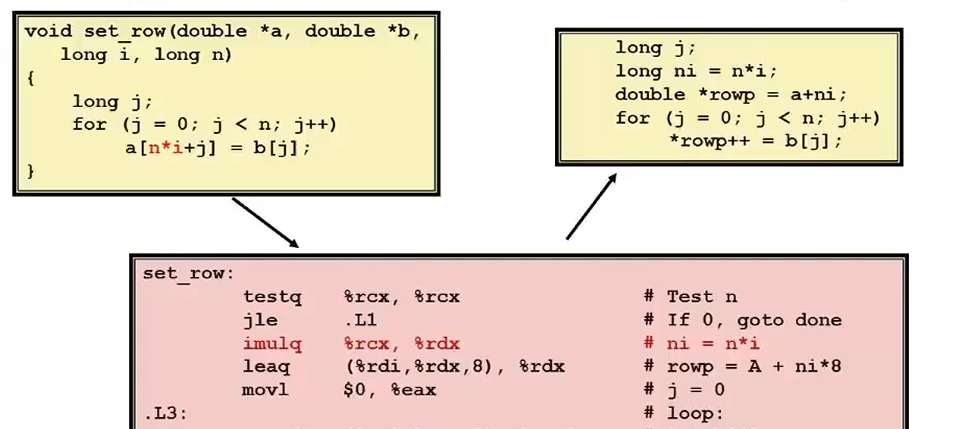
在这里把在循环体中需要反复计算的n*i提出 变成一个确定的变量,从而提升运行效率,GCC编译器通常在开启了1级优化的时候这么做。
还有gcc还会通过位移或加法运算来进行一个常数的乘法或者除法:
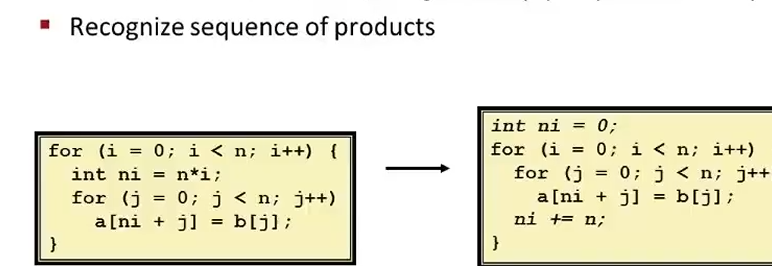
比如在这里,就可以使用可预测性更好的加法来替代数乘运算。
重复使用运算表达式也可以提升运行速度:
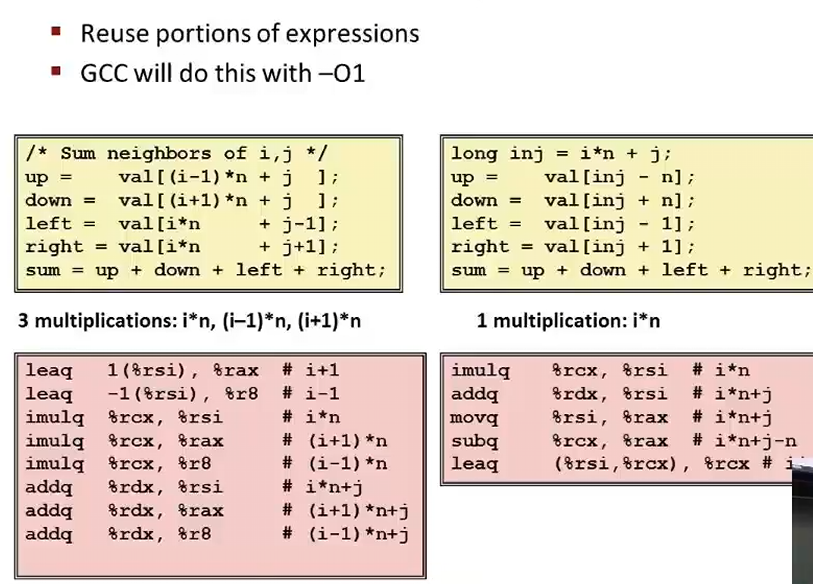
通过提取并复用计算过的表达式结果,用更廉价的加法/减法代替昂贵的乘法,从而大幅提升程序运行速度。
但是有些时候,编译器无法进行优化:
-
过程调用:
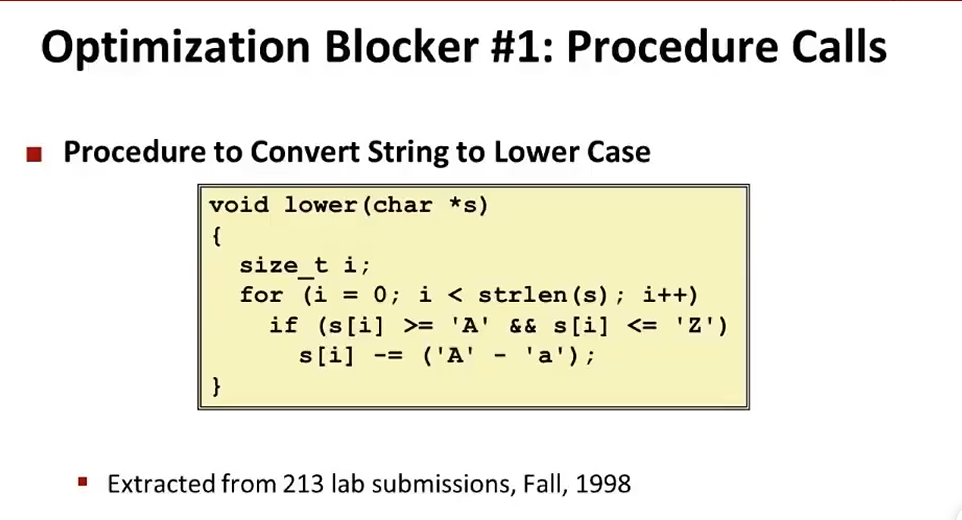
这张图中调用了一个 strlen(),每次循环strlen必须要重新计算字符串长度,是将整个字符串从头到尾遍历一遍(直到碰到\0)那么这样,这个循环的时间复杂度就从N变成了 N^2
同时,编译器是保守的,它无法确定,把strlen拿出来是安全的:
- 副作用(Side Effects)的未知性:
strlen 是一个外部函数(通常来自标准库)。编译器在单独编译这个文件时,不知道 strlen 的具体实现。它必须假设任何函数调用都可能产生副作用(例如修改全局变量、修改 s指向的内容)。 - 循环内部修改了内存:在循环体中,
s[i] -= ('A' - 'a'); 修改了字符串的内容。编译器无法确定:修改了 s 之后,再去调用 strlen(s)会不会得到不同的结果?(实际上对于大小写转换长度不变,但编译器无法进行这种语义级别的推理,它只看指令)。 - 无法进行“循环不变量外提”(Loop Invariant Code Motion) :只有当编译器能100%确定一个表达式在循环中每次的结果都一样时,才能把它提到循环外。因为
s 在被修改,且 strlen内部行为未知,编译器只能老老实实地每次迭代都调用一次。
可以这样改进:
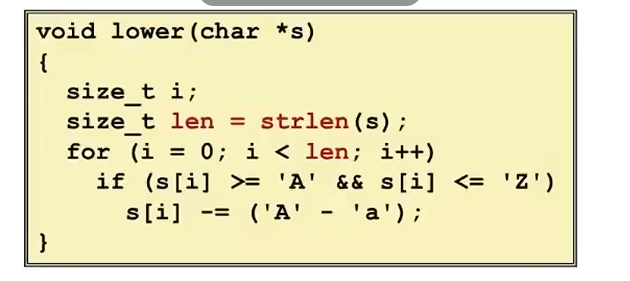
这样就只需要计算一次,而不是每轮循环都要调用函数
- 副作用(Side Effects)的未知性:
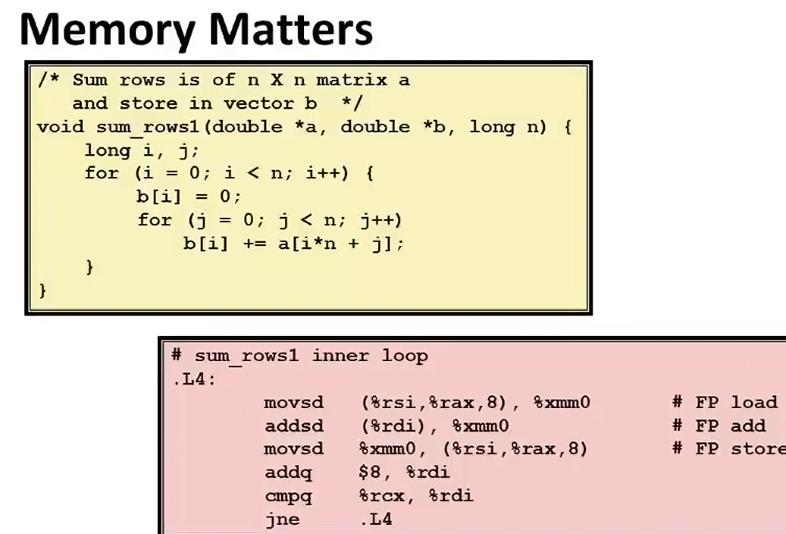
这里是直接在和内存进行交互,内存在和寄存器之间交换数据。因为C语言编译器会假设这一块内存区域存在别名。
1. 内存别名(Memory Aliasing)导致的优化阻碍
这是最核心的原因。请看 C 代码:
void sum_rows1(double *a, double *b, long n) { ... }
在这个函数签名里,a 和 b 都是 double * 指针。编译器在编译这段代码时,无法证明 a 和 b 指向的是两块互不重叠的内存。(程序的不同部分,指向同一块内存区域被称作 别名)
编译器必须假设最坏的情况:假设 b 和 a 有重叠区域(例如,b 指向 a 内部的某个位置)。
如果是这样,当内层循环读取 a[i*n + j] 时,这个操作可能会意外地修改 b[i] 的值。
因此,在每次循环迭代中,编译器不敢将 b[i] 缓存在寄存器中一直累加,因为它无法保证在读取 a 的下一个元素时,b[i] 有没有被意外改变。为了保证 C 语言语义的绝对正确性,编译器只能每一次迭代都乖乖地:
- 从内存读取当前的
b[i] (addsd (%rdi), %xmm0) - 计算完毕后,马上写回内存(
movsd %xmm0, (%rdi))
2. 指针运算的代价
你可以看到,循环里的 %rdi 实际上是 &b[i] 的地址。每次循环都在做指针加法(addq $8, %rdi),并在下一次迭代时通过这个地址去访问内存。而 %rsi 和 %rax 组合起来用于访问矩阵 a。
优化:
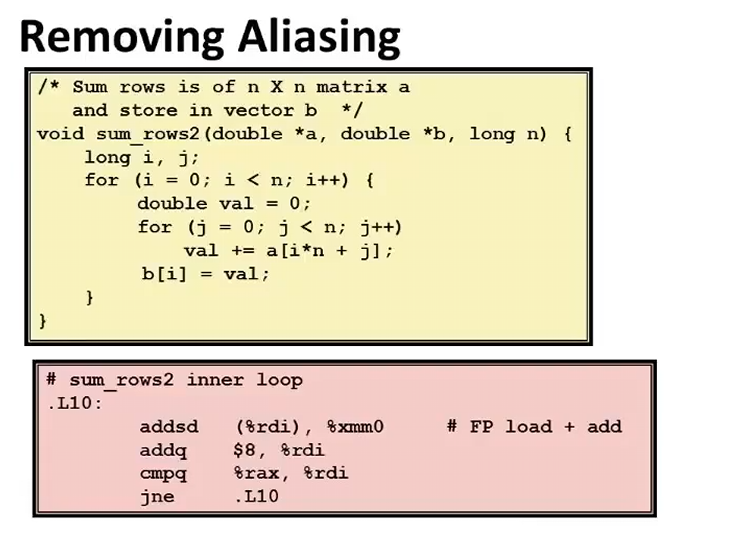
可以通过引入局部变量,但是受限于内存读写,这并不会明显加快运行速度
除此之外 数据结构层面的也可以提升程序运行效率:
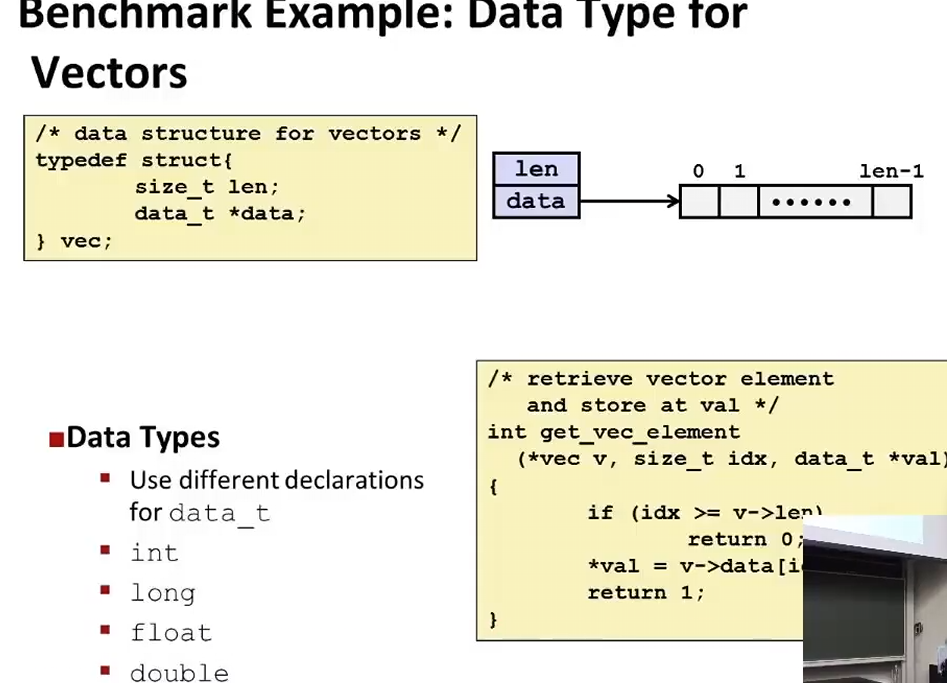
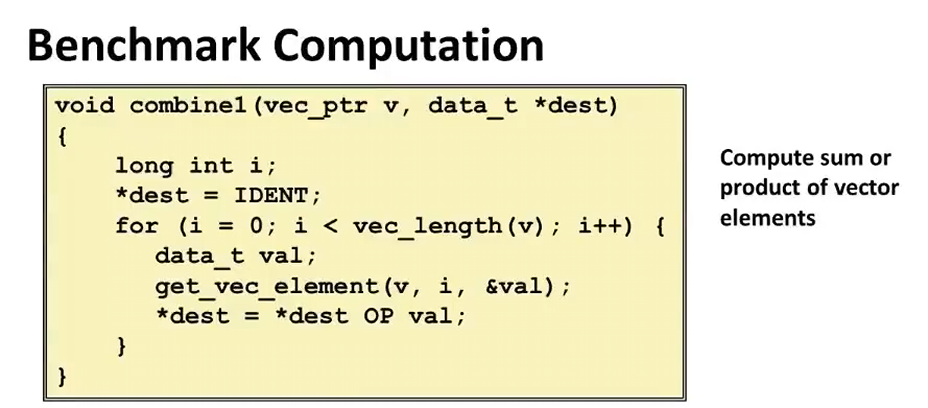
在这个例子中,构造了抽象数据类型,结构体的数据类型可自行定义。在基准测试中,会将 data_t 替换为 int、long、float、double 等不同数据类型,以此观察不同类型对性能的影响。
get_vec_element的作用 从向量中按索引读取数据。注意其中的边界检查(if (idx >= v->len))
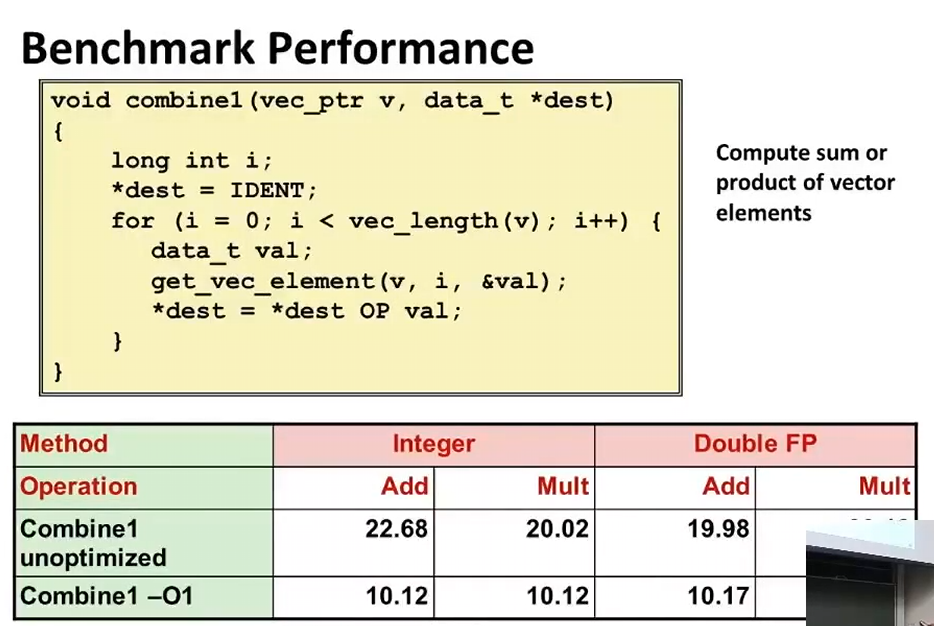
以下是最基础的优化:
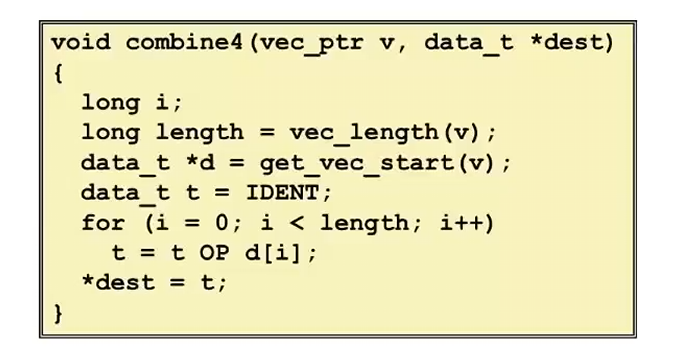
- 把计算长度的函数调用挪出了循环体
- 取消在每一轮循环中检查边界
- 局部变量中就计算好需要的数据
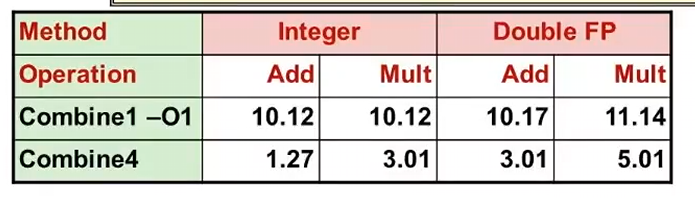
那么这些数字是哪里来的呢?是否真的到达了优化极限?在此之前得先知道一下现代CPU的结构:
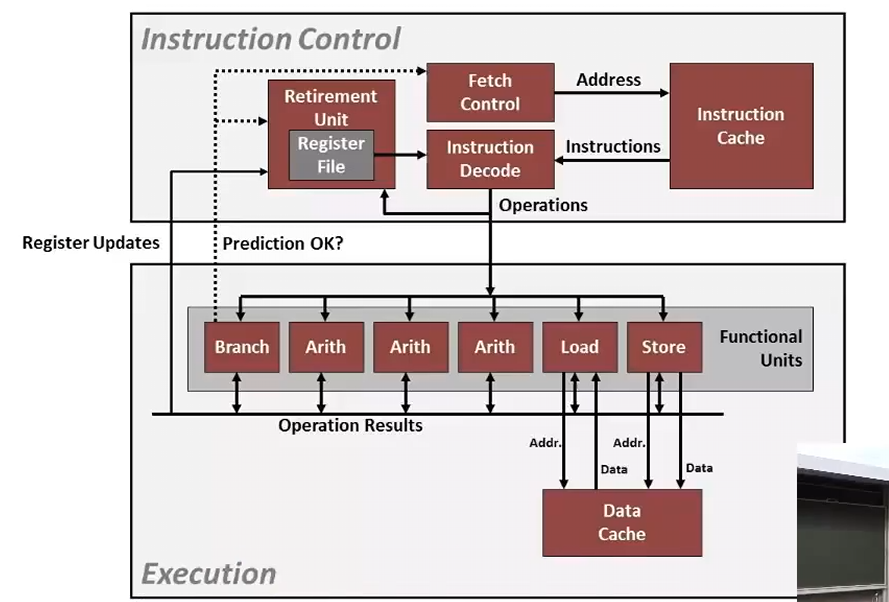
CPU会乱序执行,具备并发能力。等待被执行的指令会被先存储在CPU Cahce中,随后和缓存把指令送到 译码器 ,译码器会把指令拆分为低级操作,并且确定这些操作之间的依赖关系,确定这些操作之间的依赖关系。CPU还有一些运算单元,可以进行浮点数运算等操作。从内存中读取数据、写入数据到内存。一切操作都基于缓存——总的来说,就是会把程序中的拆分进行重组,使得这些单元尽可能的保持繁忙。一个时钟周期可以执行多条指令。
其中,功能单元使用了Pipeline(流水线技术),其基本思想就是将计算分解为一系列不同的阶段
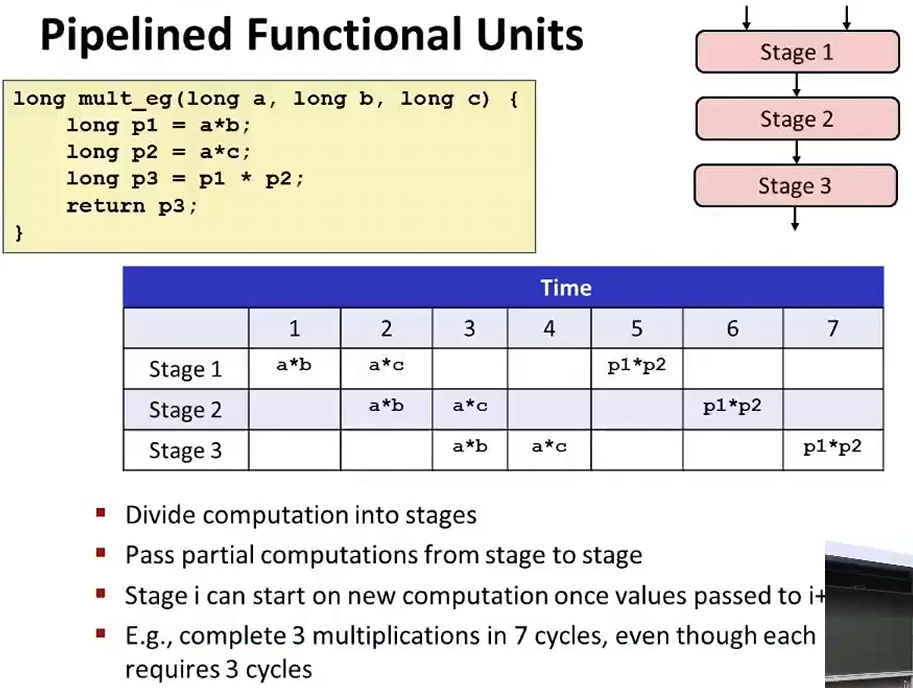
如果不采用流水线,做一次64位乘法需要耗费 3个时钟周期。那么按顺序执行这3个乘法,就需要 3 × 3 = 9个周期。
在这张图中,当 Stage 1 在周期3和周期4处于空闲(空白) 状态时,如果这是一个现代CPU,乱序执行(Out-of-Order Execution) 机制就会介入!
CPU会向后看(扫描后面的指令),如果发现还有其他完全无关的乘法(比如 x*y),就会把 x*y 塞进周期3的 Stage 1 里。这样,空白就被填补了,流水线利用率大幅提升。只用了七个周期就完成了这些操作。
课程在这里还介绍了Haswell架构的特点?
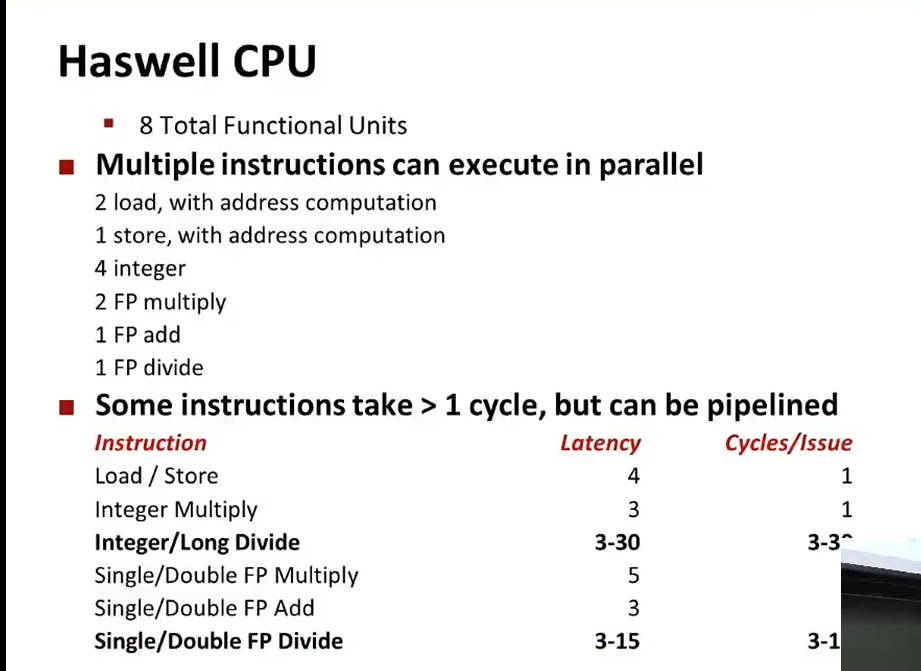
这张幻灯片是计算机体系结构课程(如CS:APP)中的经典内容,它以前几页的“流水线”和“乱序执行”理论为基础,展示了真实的Intel Haswell架构CPU(2013年发布,第四代酷睿)的具体硬件参数。
这张图的核心目的是告诉你:现代CPU如何通过大量的硬件资源来并行处理指令,以及为什么有些指令会成为性能杀手。
我们来逐层拆解这张图的含义:
Haswell
1. 硬件家底:8个总功能单元(端口)
-
8 Total Functional Units:Haswell CPU拥有8个执行端口(Port 0 到 Port 7),意味着它在硬件层面上最多可以同时执行8个互不干扰的微操作(uop) 。这被称为超标量(Superscalar) 架构。
-
Multiple instructions can execute in parallel(多条指令可并行执行):CPU内部把这些端口分配给了不同类型的运算:
- 2 Load(2个加载单元):专门负责从内存/缓存读取数据(顺便计算地址)。这暗示内存读取往往是瓶颈(因为读数据是最高频的操作,所以配了2个)。
- 1 Store(1个存储单元):专门负责往内存/缓存写数据。读多写少,配1个够用。
- 4 Integer(4个整数运算单元):负责加减乘除、位运算等。
- 2 FP multiply(2个浮点乘法单元)。
- 1 FP add(1个浮点加法单元)。
- 1 FP divide(1个浮点除法单元)。
这意味着: 只要指令没有数据依赖(比如你之前看到的 p3 = p1 * p2 就必须等前两步),CPU可以在一瞬间把2个浮点乘法和1个浮点加法同时塞进这三个单元里并行计算。
2. 核心概念:延迟(Latency) vs. 发射周期(Cycles/Issue)
这是这张幻灯片最重要的部分,它区分了“执行一次要多久”和“多久能开始下一次”。
- Latency(延迟) :指令从开始执行到算出最终结果所需的总周期数。
- Cycles/Issue(发射周期 / 倒数吞吐量) :连续发射两条相同指令所需的间隔周期。
1 / 发射周期就等于该单元的吞吐量。
看表格里的关键数据:
- Integer Multiply(整数乘法) :延迟3,发射周期1。
意味着:一次乘法需要3个周期才能算完(延迟),但由于它是全流水线的,你每个周期都能启动一次新的乘法(发射周期1)。这完美对应了你上一张PPT的流水线概念! - Load / Store(加载/存储) :延迟4,发射周期1。
这代表的是命中L1缓存时的延迟。如果发生缓存未命中(Cache Miss),延迟会飙升到几百个周期。 - FP Multiply(浮点乘法) :延迟5,发射周期1。
这就是之前提到的,为什么浮点乘法比整数乘法开销更大(延迟5对3)。但如果是向量化(SIMD),一次能处理多个数据,整体吞吐量依然极高。
3. 特殊的“异类”:除法(Divide)
表格里的 Integer/Long Divide 和 Single/Double FP Divide 暴露了CPU的软肋。
- 延迟高达 3-30 或 3-15 个周期。
- 更可怕的是,发射周期也是 3-30 或 3-15。
这意味着除法器没有完全流水线化。它不像乘法那样“每周期都能塞进去一个”,而是“每3到30个周期才能开始下一个”。由于除法极其复杂,它会在很长一段时间内霸占那个功能单元。如果在代码里循环做除法,整个流水线都会被它拖垮,后续指令全部堵死。这就是为什么编译器极度偏爱用“位移”或“乘法”来替代“除以常数”。
4. 串联你学过的所有知识
这张图完美闭环了你之前所有的疑问:
- 结合“流水线(Pipeline)” :表中发射周期为1的指令,就是完美的流水线实现。延迟3-5就是流水线分为了3-5个阶段。
- 结合“乱序执行(Out-of-Order Execution)” :Haswell拥有这么多功能单元,凭什么能填满?靠乱序执行。假设遇到了一条延迟30的整数除法,乱序引擎会让它去慢慢除,同时立刻从后面的指令流里抽出2个加载、4个整数加法和2个浮点乘法,塞满其他7个空闲端口。这是硬件用庞大的寄存器重命名和保留站换来的。
- 结合“内存至关重要(Memory Matters)” :你看Load/Store占了3个端口(总共8个),它们执行频繁且延迟高(4)。之前代码里
b[i] += a[i*n+j]反复读写内存,实际上就是在疯狂抢占这3个Load/Store端口,导致其他整数/浮点运算单元在“挨饿”。 - 结合“编译器优化” :之前的幻灯片里,GCC把乘法改成加法(强度削减)、提取公共子表达式,本质上就是为了减少运算次数,或者说把这些运算替换成“延迟更低、占用单元更少”的指令(比如加法和lea),让这8个功能单元不至于因为某几个长指令而闲置。
总结:
这张幻灯片是硬件设计者的“底牌”。它告诉软件开发者:“我给了你8个通道、多套并行单元,但我也有软肋(除法、内存加载)。”作为程序员,你的优化目标就是让代码尽可能填满这些单元(减少依赖),避开软肋(少用除法,提升缓存命中率) 。
Unrolling
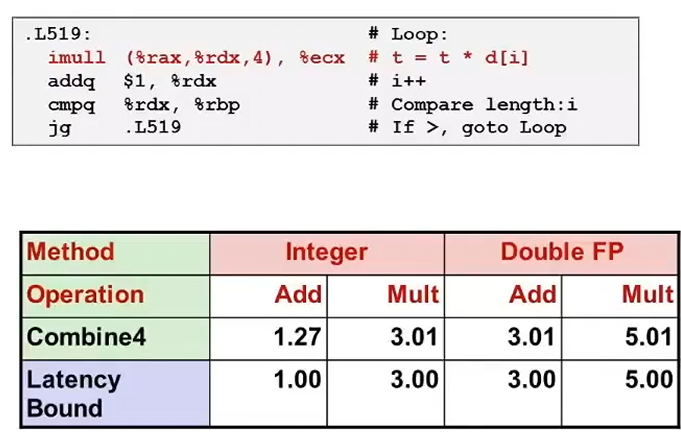
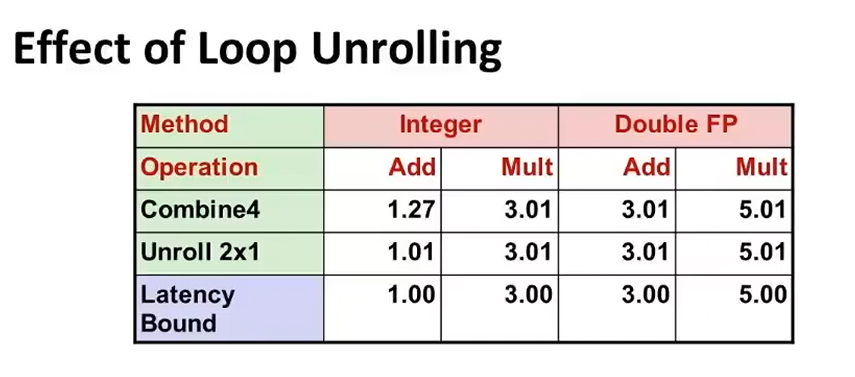
对于这种延迟限制,或许能够使用循环展开(Loop Unrolling)的思路进行优化:核心思想就是,用空间换时间
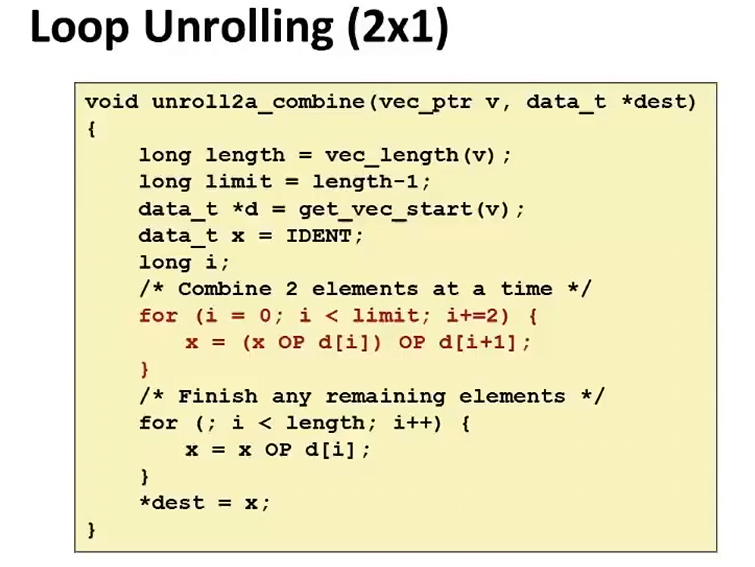
在这段代码中,标题的(2×1)指的是每次循环迭代处理两个元素,但是只使用一个累加变量
结合你前面学的“Haswell CPU”和“流水线”,这张幻灯片里的循环展开(Loop Unrolling) 其实是为了填补硬件流水线的空缺,并减少“不干正事”的指令开销。
一句话概括循环展开的核心思想:牺牲程序的代码体积(空间),换取程序的执行速度(时间)。
我们结合图片中的代码 2x1 来详细剖析这个思想。
1. 什么是“2×1”?
- 2×1 的意思是:每次循环迭代处理2个元素(
d[i] 和 d[i+1]),但只使用1个累加变量(x)。 - 相对应的有
2x2(每次处理2个,使用2个独立累加器),那个能更好地并行,后面会讲。
2. 为什么要进行循环展开?(动机)
在没有展开的普通循环中,每次处理一个元素,汇编代码大概是这样:
.Loop:
    addq (%rdi), %rax  ; 真正干活的指令 (计算)
    addq $8, %rdi      ; i++
    cmpq %rsi, %rdi    ; i < limit?
    jne .Loop          ; 跳转
你可以看到, “真正干活”的指令只有1条,但为了维持循环,需要3条指令(i++、比较、跳转)来控制流程。 这就占用了Haswell CPU宝贵的执行端口和前端带宽。而且,末尾的 jne 跳转会打断流水线(虽然分支预测能缓解)。
循环展开的优化思想体现在三个方面:
- 减少循环控制开销:原本循环N次要执行N次
i++、比较和跳转,现在循环N/2次,控制指令直接减半。 - 增加指令级并行(ILP) :展开后,循环体变大了,里面包含了两次独立的内存加载(
d[i] 和 d[i+1])。回顾上一张Haswell的图,CPU有2个Load端口,现在它可以一次性把这两个加载指令都发射出去,实现并行读取,隐藏内存延迟。 - 给乱序执行提供更大的调度窗口:CPU后端能一次性看到更多不相关的指令,便于填满那8个功能单元。
3. 代码结构解剖(图片里的细节)
图片代码非常严谨地处理了展开带来的问题:
limit = length - 1;:因为每次步进2(i+=2),如果数组长度是奇数,直接跑到最后会越界访问。所以主循环只跑到倒数第二个元素。- 第一个
for 循环:每次 i+=2,一次处理俩(d[i] 和 d[i+1])。 - 第二个
for 循环(收尾):for (; i < length; i++)。专门处理如果 length是奇数时,最后剩下的那个元素。 *dest = x;:最后把累加结果写回内存。
4. ⚠️ 进阶视角:这段代码隐藏的“性能陷阱”
虽然这张图是讲循环展开,但图中的代码 x = (x OP d[i]) OP d[i+1]; 暴露出一个重大瓶颈——真数据依赖(Data Dependency) 。
因为 x 在第一次运算后,第二次运算还要用到 x。如果 OP 是浮点乘法或加法,由于浮点数不满足结合律,编译器不敢把它拆成 (x OP d[i]) 和 (x OP d[i+1]) 同时算。这意味着,即使你循环展开减少了控制指令,真正的计算依然是一条极长的串行链:必须等第一步算完,第二步才能算。
真正的终极优化(2×2 展开):
为了打破这个依赖,程序员会使用两个累加器:
data_t x0 = IDENT;
data_t x1 = IDENT;
for (i = 0; i < limit; i+=2) {
    x0 = x0 OP d[i];
    x1 = x1 OP d[i+1];
}
x = x0 OP x1; // 最后合并
这样,两条计算链完全独立,Haswell CPU的“2个浮点乘法单元”就能同时满负荷运转,性能直接翻倍。
5. 串联你之前的所有知识
- 流水线(Pipeline) :展开减少了跳转指令,让流水线不会因为频繁跳转而频繁被冲刷。
- 乱序执行(OoO) :展开后的独立指令,是乱序执行引擎最好的“弹药”。
- Haswell CPU:展开就是为了把数据喂给Haswell那8个功能单元(特别是2个加载端口和2个浮点运算端口)。
- 编译器优化/内存别名:如果你没用
restrict,编译器可能不敢自动帮你展开或优化(担心 d 和 dest 内存重叠),所以需要像图中这样手动展开。
总结:循环展开是“空间换时间”的经典体现。它减少了相对开销,增加了并行机会。但这要求程序员理解硬件的流水线(Haswell图)和数据依赖(串行链)的本质,否则展开也不一定能提速。
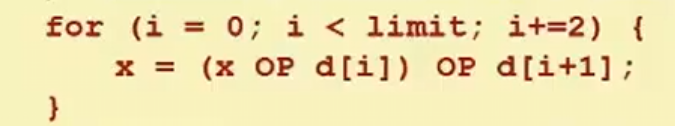
这里做了一个小的更改打破了这个限制:
before
after
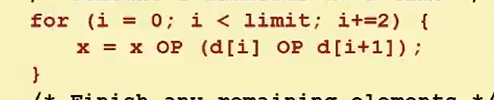
这张图片是对上一张幻灯片的一个极其关键的补充和纠正。
上一张图(x = (x OP d[i]) OP d[i+1])虽然做了循环展开,减少了一些循环控制开销,但它留下了极大的性能隐患——关键路径(Critical Path)太长。
而你图片中的这段代码:x = x OP (d[i] OP d[i+1]);,之所以能提升运行效率,核心原因是打破了串行的数据依赖链,大幅缩短了循环的关键路径。
我们一步步用Haswell架构(结合你之前的PPT)来推理:
1. 对比分析:两种结合方式的本质区别
假设 OP 是浮点加法(延迟为 3 个周期,参考之前 Haswell 表格)。
-
上一张图的写法:
(x OP d[i]) OP d[i+1]- 第一步:计算
x + d[i]。这必须等待上一轮循环的 x 算完。 - 第二步:计算
(x+d[i]) + d[i+1]。这必须等待第一步算完。 - 关键路径(每次循环的耗时) :
3周期 + 3周期 = 6个周期。即便 d[i] 和 d[i+1] 已经就绪,CPU也只能傻等前一步的结果。这叫做串行依赖(Serial Dependency) 。
- 第一步:计算
-
当前图片的写法:
x OP (d[i] OP d[i+1])- 第一步:计算
d[i] + d[i+1]。这个计算完全不依赖上一轮的 x! - 第二步:计算
x + (d[i]+d[i+1])。这里只依赖上一轮的 x。 - 关键路径(每次循环的耗时) :
3周期。 - 因为第一步计算
d[i]+d[i+1] 可以和前一轮 x 的计算并行进行(由乱序执行引擎调度到不同的功能单元),所以每次循环更新 x 的延迟只需要 3 个周期。循环性能理论上直接翻倍!
- 第一步:计算
2. 结合 Haswell CPU(硬件层面的解释)
回顾一下 Haswell 有 2个 FP add(浮点加法)单元。
-
在旧代码
(x + d[i]) + d[i+1]中,因为存在严格的前后依赖,这两次加法只能排队使用其中一个FP加法单元,另一个完全闲置。 -
在新代码
x + (d[i] + d[i+1])中:- 乱序执行引擎可以同时发射
d[i] + d[i+1] (用掉一个FP加法单元)和上一轮的 x + (上一轮的临时结果)(用掉另一个FP加法单元)。 - 完美契合了硬件的并行能力。
- 乱序执行引擎可以同时发射
3. ⚠️ 为什么编译器不自动帮我们这么改?(极其重要)
这是一个经典的面试题考点:因为浮点数不满足结合律(Associativity)。
在数学上,(x + a) + b 不一定完全等于 x + (a + b)(因为浮点数精度截断的问题)。
编译器非常保守,它绝对不敢在未开启 -ffast-math 等激进优化选项时,擅自改变浮点数的运算顺序。
因此,这段代码是程序员手动进行了数学层面的重构(Reassociation,重结合) ,明确告诉编译器:“我接受精度可能发生微小变化的风险,请帮我按这个顺序算,我要换取性能。”
4. 优化思想总结
这个代码案例完美展现了高性能编程的核心思想:增加指令级并行(ILP)。
不仅仅要展开循环减少跳转,更要找出算法中可以被提取出来的、互不依赖的计算(比如 d[i] OP d[i+1]),把它们从关键路径(更新 x 的路径)中剥离出来。
这也印证了你最开始学的“Reuse portions of expressions”和“Memory Matters”的终极奥义——我们要让CPU的每一个运算单元都忙碌起来,且不让任何一条指令饿着等数据。
2×2 Unrolling
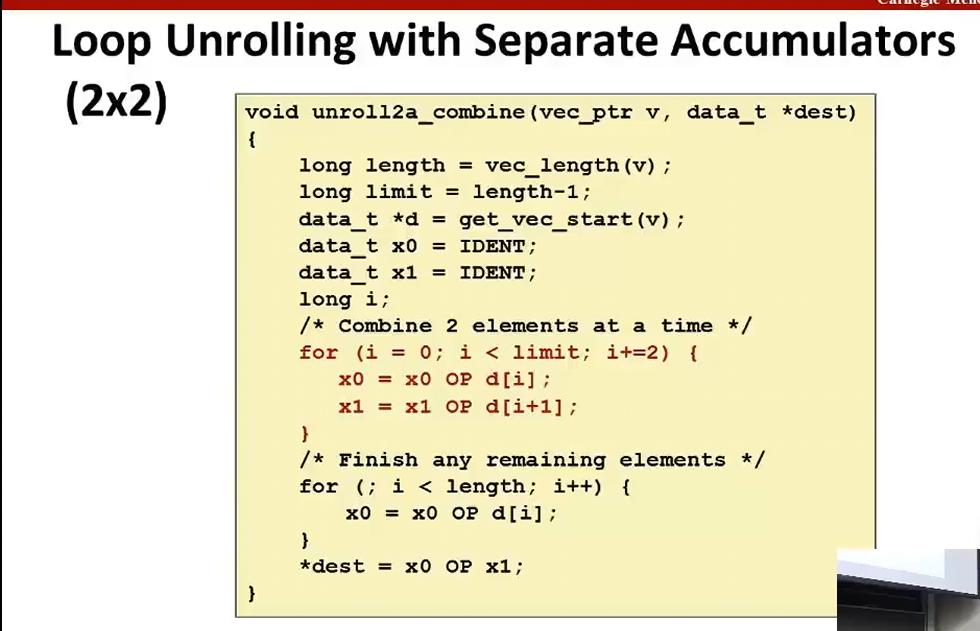
这段代码展示的是2×2 的循环展开思路
1. 什么是“2×2”?
- 第一个2:每次循环处理 2个数组元素(
d[i] 和 d[i+1]),由 i+=2可以看出。 - 第二个2:使用了 2个独立的累加变量(
x0 和 x1),而不是像之前那样只用一个 x。 - 最后把两个独立累加器的结果合并:
*dest = x0 OP x1;。
2. 为什么它能极大地提升效率?(打破依赖链)
我们来回顾一下上一张图(2×1)的痛点:它虽然缩短了关键路径,但最终还是要更新同一个 x。
无论是 (x OP d[i]) OP d[i+1] 还是 x OP (d[i] OP d[i+1]),每次循环都必须等待上一轮的 x 算完。这条串行的依赖链依然存在,成为了性能瓶颈。
而在“2×2”独立累加器版本中,依赖链被彻底斩断了:
- 计算
x0 = x0 OP d[i] 时,它完全不用等 x1的计算结果。 - 计算
x1 = x1 OP d[i+1] 时,它也完全不用等 x0的计算结果。
这就形成了两条完全独立的关键路径(Critical Path) 。
3. 完美契合 Haswell CPU 的硬件结构(结合你之前的图)
这就要连着你之前看过的“Haswell CPU”那张图了。还记得吗?Haswell拥有 2个 FP add(浮点加法)单元 和 2个 FP multiply(浮点乘法)单元。
- 过去(单累加器) :因为前后依赖,两次计算只能排队。同一个时刻,Haswell只能空着一半的浮点运算单元。这就叫“受限于延迟(Latency Bound)”。
- 现在(独立累加器) :乱序执行引擎看到
x0 = x0 + ... 和 x1 = x1 + ... 毫无关联,它可以同时将这两条指令发射到Haswell的两个浮点加法单元上并行执行。此时,程序的瓶颈从“指令延迟”变成了“硬件吞吐量(Throughput)”。这也是程序员最期望看到的“指令级并行(ILP)”。
4. 致命细节:为什么编译器不帮我自动做?
这是这个系列课程极其重要的一个考点:
因为浮点数的加法不满足结合律(Associativity)。
在数学上,(x0 + d[i]) + (x1 + d[i+1]) 的浮点数精度舍入结果,绝对不等于 (((x0 + d[i]) + x1) + d[i+1])。
IEEE 754标准要求严格遵守运算顺序。因此,除非你在编译时加上 -ffast-math(告诉编译器“我放弃严格的浮点标准,给我疯狂提速”),否则编译器绝对不敢擅自把 x 拆成 x0 和 x1。
所以,这个优化必须由程序员手动写出来,这是在和编译器“抢活干”。
5. 代码结构解析
limit = length - 1;:防止越界(当 length 为奇数时,主循环走完 i停在倒数第二个元素)。- 主循环:每次步进2,疯狂并行计算。
- 收尾循环:处理剩下那个倒霉的、没配对的元素(如果长度为奇数)。
- 合并:
*dest = x0 OP x1;将两条并行链的结果汇总。
6. 优化金字塔总结(你走过的路)
- 朴素循环:每次循环1个元素,代码短,但受限于延迟和循环开销。
- 2×1 循环展开:减少循环控制指令,但依然受限于单累加器的串行依赖。
- 2×1 重结合(数学变换) :缩短了单次迭代的关键路径,但最终合并仍需等待。
- 2×2 独立累加器:打破依赖链,实现并行计算,完全榨干 CPU 的多个功能单元,达到吞吐量上限。
结合最开始教的“复用表达式”,你会发现,所谓的高级优化,本质上就是看穿程序的数学依赖,重组代码结构,把无法并行的串行任务,巧妙地拆解成能塞进硬件并行通道的独立任务。
AVX2
如果不使用循环展开,还能怎么做呢?Haswell CPU引入了新的指令集叫做 AVX2(Advanced Vector Extensions 2),专门用于SIMD(单指令多数据,Single Instruction Multiple Data)运算。其中YMM寄存器是SIMD的物理载体:
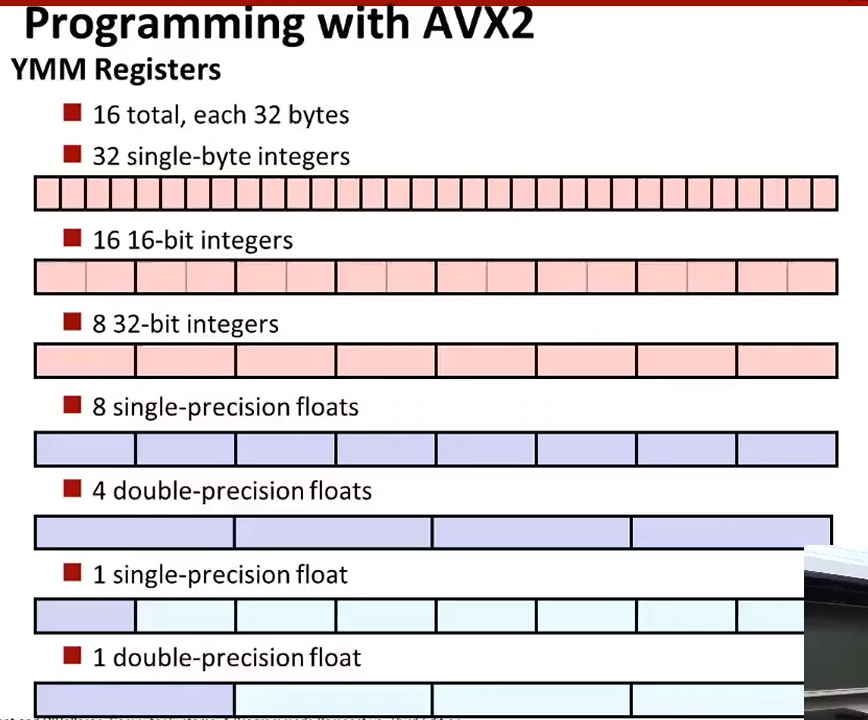
图里写明:共16个,每个 32 bytes(256位) 。(注:在x86家族中,XMM是128位,YMM是256位,ZMM是512位)。
核心思想:以前做加法,addq %rax, %rbx 只能让两个64位的数相加。而现在,你可以用一条 vaddps 指令,让8个单精度浮点数在同一个周期内同时相加。
为什么能变快呢?
之前讲2×2独立累加器时,我们手动写了 x0 和 x1 两个独立变量,把两次计算塞给Haswell的2个浮点加法单元并行做。这是指令级并行(ILP) 。
现在有了AVX2,如果我们把数组 d 里的8个单精度浮点数打包塞进一个YMM寄存器,我们只需要写1条汇编指令,就能同时算出8个数的加法。
如果你的代码是 2×2 展开(2个累加器)+ AVX2(每个寄存器装8个数),你的程序吞吐量将直接提升 2 × 8 = 16倍!
AVX2 虽然强大,但编译器依然不敢自动将你的标量代码变成AVX2向量代码。因为浮点数不满足结合律,编译器无法确定把8个加法同时相加是否符合你的浮点精度要求。除非你手动使用Intrinsics(内联函数,如 _mm256_add_ps ) ,或者使用 -ffast-math 强行让编译器“放飞自我”。
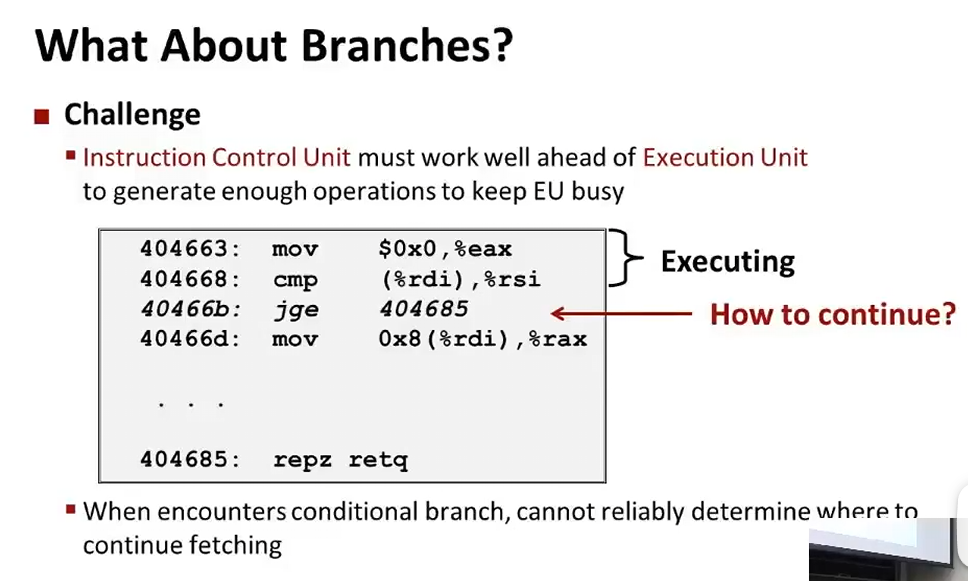
在现代流水线和乱序执行的CPU中,前端取指(Fetch)的速度必须跟上后端执行(Execution)的速度。但是,一旦遇到条件跳转,CPU就不知道下一步该去哪里取指了。这里的解决方案是分支预测。
1. 矛盾所在:前端与后端的脱节
- Instruction Control Unit(指令控制单元/前端) :负责从内存中取指令、译码,然后源源不断地喂给后端的执行单元(Execution Unit, EU,包含你之前看到的Haswell的8个功能单元)。
- 挑战(Challenge) :为了让Haswell那8个功能单元不闲着(Keep EU busy),前端必须提前取来几十条指令,供乱序执行引擎调度。
- 但是,看看中间那段汇编代码。当执行到
jge 404685(条件跳转:如果大于等于则跳转)时,前面的 cmp 指令还在执行单元里算着呢,结果还没出来! - 此时,前端就卡住了:下一条指令是去
404685 呢,还是顺着往下走 40466d 呢?这就是图中标注的 "How to continue?" 。 - 正如幻灯片底部所写:当遇到条件分支时,无法可靠地确定在哪里继续取指。
2. 遇到问题,硬件怎么解决?—— 分支预测登场
如果CPU不做出任何处理,就干等着 cmp 算出结果,那流水线就会产生巨大的“气泡”,之前的优化全部白费。
因此,硬件设计师引入了分支预测(Branch Prediction) :
- CPU内部有一个专门的分支预测器(Branch Predictor),它根据历史执行记录(比如这个循环之前跳转过99次), “猜” 这一次会不会跳转,跳到哪里。
- 有了猜测结果,前端就可以继续狂飙取指,后端的乱序引擎也能继续满负荷工作。
3. 猜错怎么办?—— 流水线冲刷(Pipeline Flush)
猜对了,性能起飞。
猜错了(比如循环最后一次退出时),CPU必须撤销(Rollback) 猜测路径上执行的所有工作,清空流水线,从正确的地址重新开始取指。这个代价极其昂贵,通常要浪费十几个到几十个时钟周期(相当于损失几百条指令的执行时间)。
4. 结合你之前学过的知识,串联起来!
- 乱序执行:没有分支预测,乱序执行就是个瘸子。指令窗口再大,遇到分支就卡住了,根本乱序不起来。
- Haswell CPU:Haswell在分支预测上投入了巨大的晶体管,有着极高的预测准确率(通常在95%以上),这也是它能塞进那么多执行单元的前提。
- 循环展开(Loop Unrolling)为什么有效:现在你再回头看循环展开!原来循环100次,要执行100次
cmp 和 jge(100次分支预测)。展开2次后,循环变成了50次,分支指令直接减半!这极大地减轻了分支预测器的压力,也减少了预测失败的几率。 - AVX2 向量化:AVX2也是同理,一次处理8个数据,处理1000个数据的循环从1000次变成125次,分支预测带来的控制开销被压缩到了极致。