L09 Machine-Level Programming V: Advanced Topics
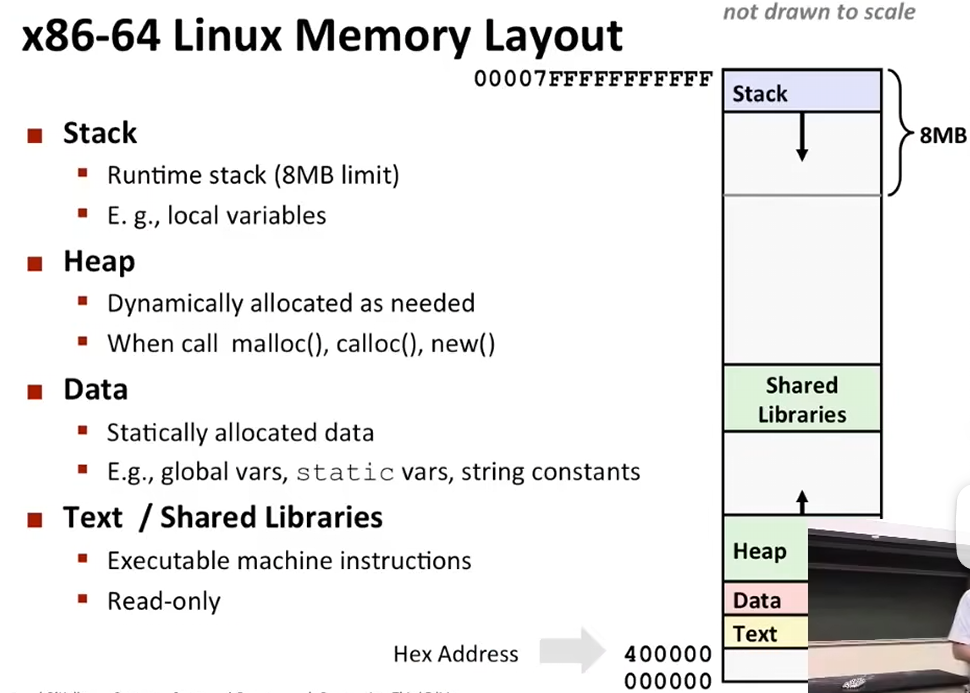
x86-64 Linux中的内存大致可以分为以下板块:
-
Stack 栈
运行时的栈,8MB限制
-
Heap 堆
根据需求动态分配,当 调用 malloc() calloc() new() 的时候创建
-
Data
静态分配的数据,比如全局变量,静态常量
.data:已初始化的全局/静态变量(如int x = 5;)。.bss:未初始化或初始化为 0 的全局/静态变量(如int x;)。.bss在 ELF 文件中不占实际磁盘空间,加载时才由操作系统清零分配。
-
Text / Shared Libraries
可执行程序(就是程序存放的地方)可读可执行。这就是你反汇编看到的
Text 代码段,存放机器指令。只读。存放 ELF 文件的头部、段表等元数据。
现在64位的机器会限制使用47位的内存地址 256TB
这张图的顶部是 0x7FFFF 底部是 0x400000
- 顶部(高地址
0x7FFF... ) :是 Stack(栈) ,因为栈是向下增长的(向低地址生长)。 - 底部(低地址
0x400000 ) :是 Text(代码段) ,因为程序代码通常从固定的低地址开始加载。 - 中间的空洞:
Heap(堆) 向上增长,Shared Libraries(共享库)向下映射,它们中间留了巨大的空洞。这留出了极大的弹性空间——如果堆和栈用不完中间的空洞,它们就不会相撞(相撞就会 Stack Overflow 或 OOM)。
例如有下列程序:
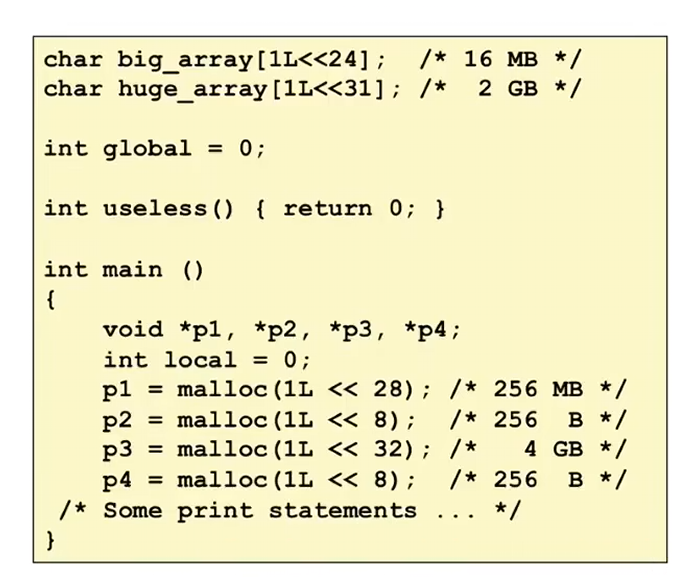
于是他们的分布如下:
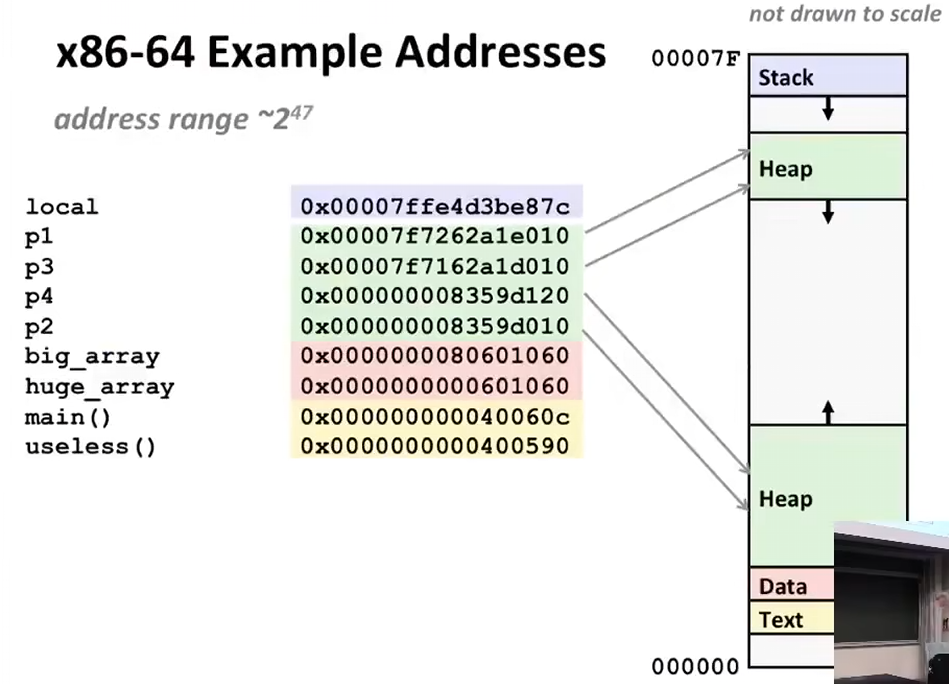
1. 地址与内存区域的映射(看图1右侧)
-
local (0x00007ffe…) → Stack(栈)- 最高地址区域(约 0x7fff…,正好是 47 位),栈从高地址向低地址生长。
local 是main函数里的局部变量,理所当然在栈上。
- 最高地址区域(约 0x7fff…,正好是 47 位),栈从高地址向低地址生长。
-
p1 (0x00007f72…) 和 p3 (0x00007f71…) → Shared Libraries / mmap 区域- 注意这两个指针的地址都是
0x7f... 开头。它们虽然是通过malloc 分配的,但因为申请的空间非常大(p1 是 256MB,p3 是 4GB) ,glibc 的malloc 会直接使用 mmap 系统调用,在共享库附近分配一块独立的内存,而不是去挤那个传统的堆(Heap)。
- 注意这两个指针的地址都是
-
p2 (0x00000008359d010) 和 p4 (0x00000008359d120) → Heap(堆)- 这两个指针是
0x08... 开头(相对较低),并且都在同一个区域。因为它们只申请了 256 字节(很小),glibc 会使用 brk 系统调用,在传统的堆区(紧挨着 Data 段上方)分配。 - 仔细观察
p2 和p4 的差值:0x...d120 - 0x...d010 = 0x110 = 272 字节。这正好是 256 字节的请求 + 16 字节的堆块管理开销(元数据)。这证明了它们在连续的堆上。
- 这两个指针是
-
big_array (0x000000080601060) 和 huge_array (0x0000000601060) → Data / BSS 段- 这些是全局数组(未初始化),位于低地址的静态数据区(
.bss)。 - 它们的地址(
0x08... 和0x06...)看起来比堆的地址(0x00000008...)还要低一点,这是因为全局变量在程序加载时就已经分配好了固定的虚拟地址。2GB 的huge_array更是直接撑大了 BSS 段。
- 这些是全局数组(未初始化),位于低地址的静态数据区(
-
main() (0x00000000040060c) 和 useless() (0x000000000400590) → Text(代码段)- 最低的地址区域(
0x400...),存放机器指令,且只读。
- 最低的地址区域(
2. 图2代码中的隐藏知识点(如何解释这些地址)
图2的 C 代码解释了为什么会有图1的地址分布:
int local = 0; → 随main 函数在栈上分配。malloc(1L << 28); → 申请 256 MB(超过 MMAP 阈值,约 128KB)。所以走mmap,映射到共享库区域(得到0x7f...地址)。malloc(1L << 8); → 申请 256 字节。走brk 拓展堆(得到0x08...地址)。malloc(1L << 32); → 申请 4 GB。毫无疑问走mmap,落在共享库区域(得到0x7f...地址)。char big_array[1L<<24]; → 全局变量,放在 .bss 段(16MB)。char huge_array[1L<<31]; → 全局变量,放在 .bss 段(2GB)。useless() 和main() → 代码,放在 .text 段(0x400000 附近)。
3. 你提到的“47位 / 128TB”验证
图1左上角的 address range ~2^47 和顶部栈地址 00007F... 遥相呼应。
0x00007FFFFFFFFFFF 正是用户空间地址的极限(即 2^47 – 1)。
在 Linux 下,用户空间只能用到这个上限。再往上走(即 0xFFFF800000000000 以上),就是操作系统的内核空间了。你之前笔记里记的“限制使用47位内存地址 256TB”也没错(因为内核空间和用户空间各占 47 位,加在一起就是 256TB 的虚拟地址空间,但当前进程只能看到自己这 128TB)。
4. 总结你的理解
你把这四个板块:Stack、Heap、Data、Text 背下来并且明确了它们的地址特征。
现在配合这个实验,你可以把它变成条件反射:
- 看到
0x7fff...→ 栈变量 - 看到
0x7f...→ 大型 malloc(mmap)、共享库 - 看到
0x400...→ 代码段 - 看到
0x08...或极低地址 → 全局变量(Data/BSS)、小型 malloc(brk 堆)
在共享库附近分配一块独立的内存,而不是去挤那个传统的堆(Heap) 可是图里面标注的还是heap
此外 假设我这台计算机只有32GB的ram 也是这样的内存地址吗
1. 为什么图里标注的还是“Heap”?
你的眼睛非常毒。图里箭头确实指向了标有“Heap”的绿色大块区域,但实际上:
- CSAPP 教材的简化:在这张图里,作者把由
brk 系统调用管理的“传统堆” 和由 mmap 系统调用管理的“内存映射区(Memory Mapping Segment)” ,在视觉上笼统地合并成了一个大绿色的“Heap”区域。这是为了方便教学。 - 真实的 Linux 布局:实际上在真实的进程地址空间里,
0x7f... 开头的那片区域(p1、p3 所在位置,以及共享库Shared Libraries 所在位置)统称为 mmap 区域(内存映射段) 。它从高地址向低地址生长(向下增长)。 - malloc 的分水岭:
p2 和p4(256字节)会走brk,放在传统堆(紧挨着 Data 段,向上生长,地址0x08...);而p1(256MB)和p3(4GB)太大了,直接走mmap,放在共享库下方(地址0x7f...)。 - 总结:图里那个大绿块,是指代所有动态分配的内存(包括 brk 和 mmap) 。所以箭头指向它并没有错,只是它具体分为“低地址的传统 Heap”和“高地址的 mmap 区域”。
2. 如果我的电脑只有 32GB RAM,地址还是这样吗?
答案是:是的,虚拟地址的排布完全一模一样。这是虚拟内存最伟大的魔法。
无论你的物理内存(RAM)是 32GB、16GB,甚至只有 4GB,你的程序看到的虚拟地址空间永远是一张 128TB(47位)的巨大地图。
这里你务必要分清两个概念:
- 虚拟地址(Virtual Address) :程序里看到的地图(128TB)。不管物理内存有多少,这张地图的画法是不变的。
- 物理内存(Physical RAM) :你实际拥有的 32GB 硬件。
为什么只有 32GB 内存,却能写出 2GB 的数组(huge_array )和申请 4GB 的 malloc ?
- 按需分页(Demand Paging) :当你声明
char huge_array[1L<<31](2GB)时,操作系统并不会立刻分配 2GB 的物理内存。它只是在你进程的虚拟地址地图上划了一个 2GB 的“虚拟圈”,标记为“未映射”。只有当你真的去读写这块内存的某个字节时,操作系统才会触发“缺页异常”,临时分配 4KB 的物理内存页给你。 - 交换空间(Swap) :如果你的物理内存真的用完了,操作系统还会把暂时不用的数据挪到硬盘上的 Swap 分区里。
那图里到底哪里变了?
- 绝对地址变了(ASLR) :现代操作系统开启了地址空间布局随机化(ASLR) 。每次你运行这个程序,
local 的地址可能从0x7ffe... 变成0x7ffc...,p1 的地址也会在0x7f... 范围内随机漂移。但相对位置(谁能用哪些前缀)是不变的。 - 物理内存分配变了:如果你真的去遍历那个 2GB 的
huge_array并写入数据,你的 32GB 物理内存会被迅速消耗,甚至可能触发 OOM(内存溢出)杀手。但如果你只是声明它,它根本不占你 32GB 里的一丁点空间。
缓冲区溢出:
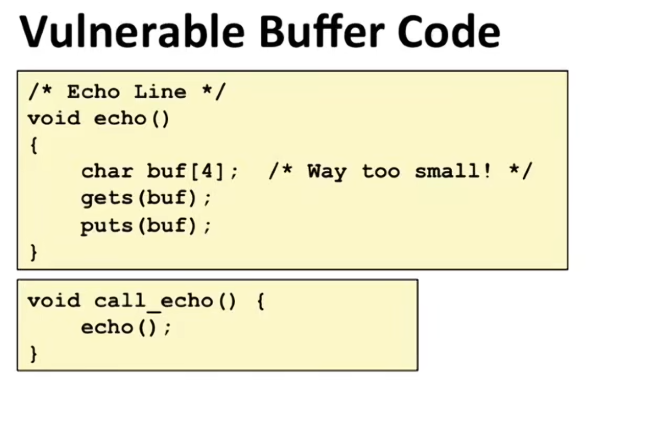
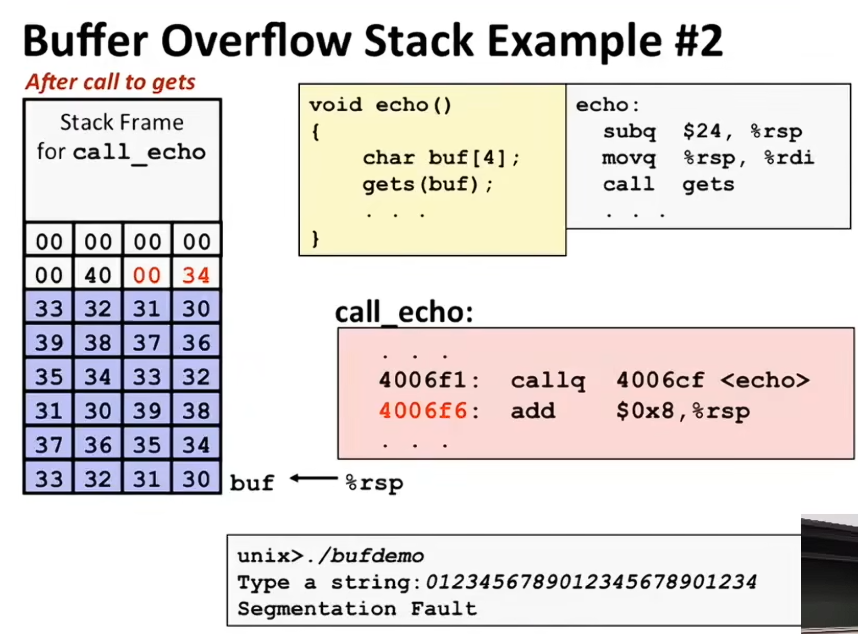
这段代码的汇编是这样的:
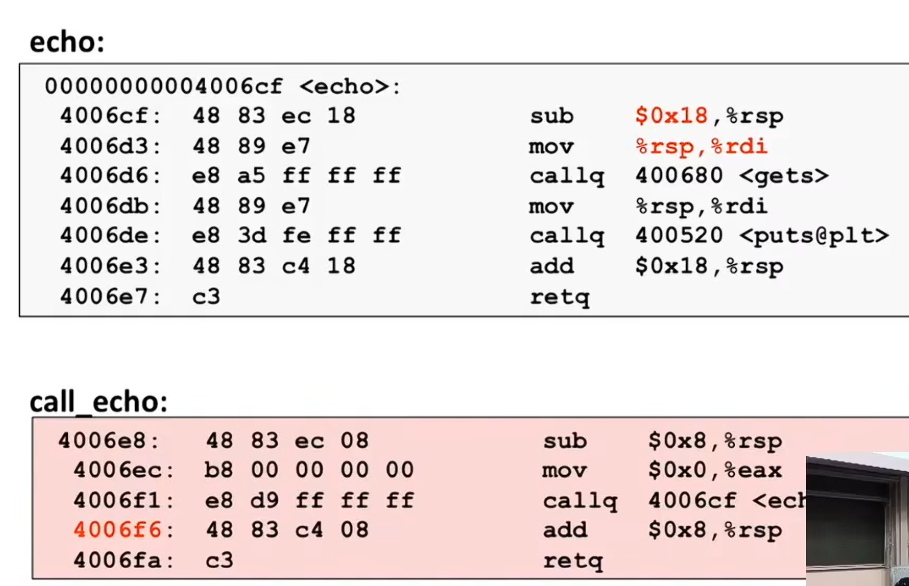
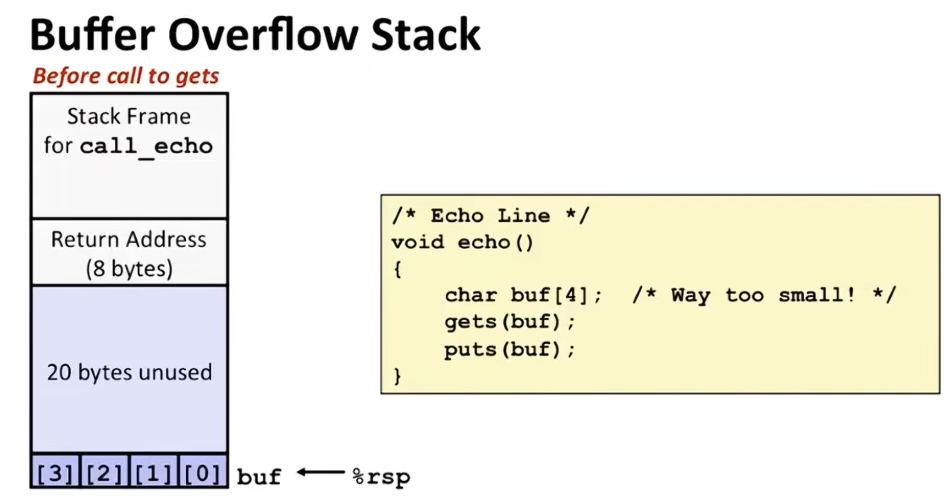
这个 0x18 (24字节)是编译器为整个 echo 函数分配的“总栈帧大小”(包含了缓冲区、填充数据、对齐空间)。
1. 为什么是 24 字节(0x18)?(栈对齐的硬性规定)
在 x86-64 Linux 下,System V ABI 有一条铁律:当执行 call **指令时,** %rsp 必须 16 字节对齐。
我们顺着调用链算一下:
- 进入
call_echo 时,%rsp 是 8 mod 16(因为call指令压入了 8 字节的返回地址)。 - 在
call_echo 里执行了sub $0x8, %rsp。此时%rsp是 0 mod 16。 - 然后
call echo,CPU 又压入 8 字节的返回地址。进入 echo **时,** %rsp 又变成了 8 mod 16。 - 为了在
echo 里调用gets 和puts 时恢复 16 字节对齐,编译器执行了sub $0x18, %rsp。 - 计算:
0x18 (24) = 16 (为了对齐的调整) + 8 (弥补之前 call 压入的返回地址)。8 - 24 = -16,正好是 16 的倍数。 - 所以,这 24 字节里,只有 4 字节是真正给
buf 用的,剩下的 20 字节全是“编译器为了对齐硬塞的 Padding(填充)” 。
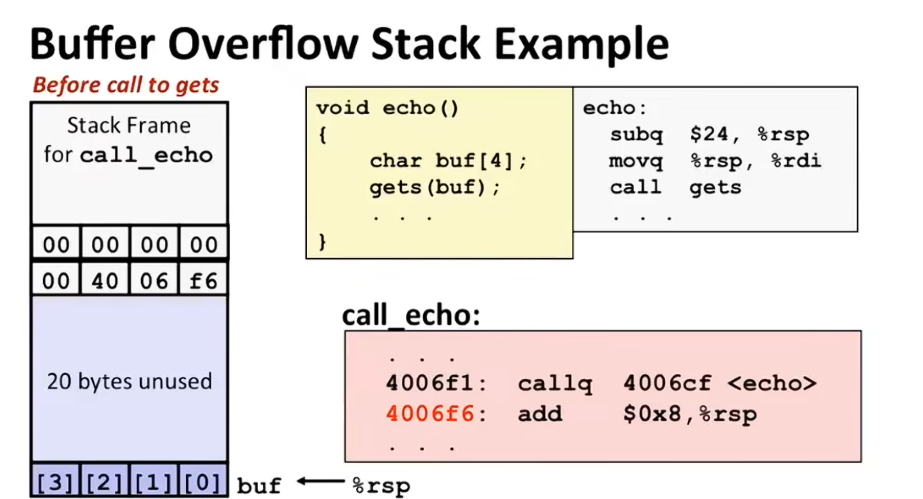
2. 真实的栈帧布局(在 pwndbg 里能看到)
当执行到 callq <gets> 时,栈内存是这样的(从低地址到高地址):
| 地址偏移 (相对 rsp) | 内容 | 大小 |
|---|---|---|
rsp + 0 |
buf[0..3] (gets 的起始写入点) |
4 字节 |
rsp + 4 |
编译器填充的 Padding(废弃空间) | 4 字节 |
rsp + 8 |
编译器填充的 Padding(废弃空间) | 8 字节 |
rsp + 16 |
编译器填充的 Padding(废弃空间) | 8 字节 |
rsp + 0x18 (24) |
echo 的返回地址 (执行完 ret 后要跳回 call_echo 的 0x4006f6) |
8 字节 |
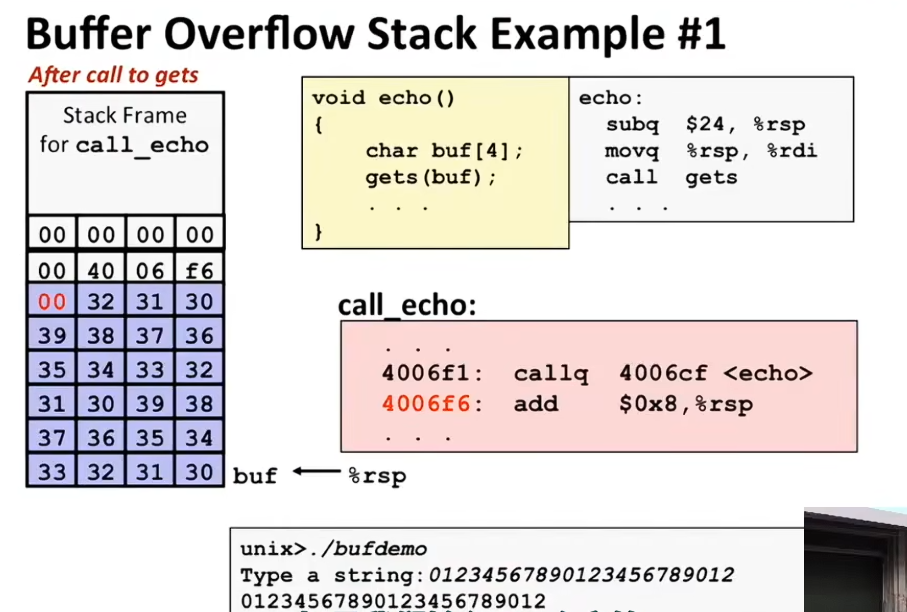
看到了吗? 你的 char buf[4] 依然只有 4 字节。只要输入的字符超过 4 个,就会立刻踩进“填充”区;输入超过 24 个(0x18),就会精准覆盖到返回地址。
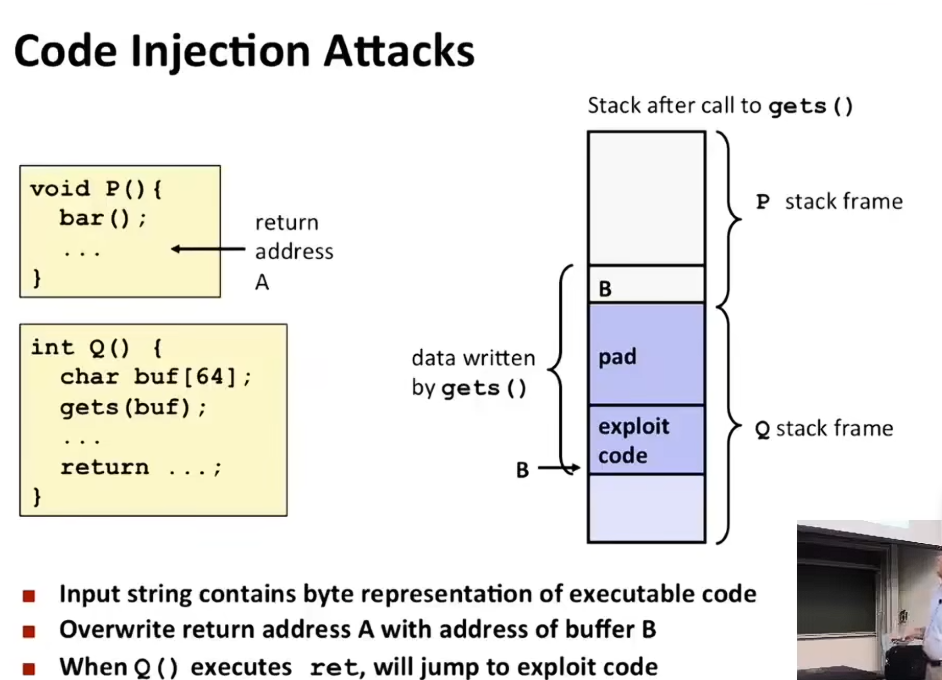
- “Input string contains byte representation of executable code”
你的输入字符串里,包含了可以直接让 CPU 执行的机器码(比如执行execve("/bin/sh", 0, 0)的汇编指令)。 - “Overwrite return address A with address of buffer B”
你利用gets 的溢出,精准地把栈上的返回地址A 覆盖成了 B (缓冲区起始地址) 。 - “When Q() executes ret, will jump to exploit code”
当Q() 执行ret 时,CPU 会把被篡改的返回地址(即B)弹进%rip。然后 CPU 跑去地址B 处取指令——此时 %rip 指向的是栈,而栈上恰好是你刚写进去的机器码。 于是 CPU 开始执行你注入的代码,攻击成功!
这涉及计算机体系结构里一个非常关键的保护机制:NX(No-eXecute)位。
你刚才在 checksec 里看到的 NX enabled,就是用来防止这件事的。我帮你把这个历史演变和底层原理彻底讲透:
1. 为什么“理论上”可以?(CPU 的“盲人”视角)
在 CPU 硬件眼里,内存里的数据只是一堆 0 和 1。CPU 的“取指-译码-执行”周期非常机械:
- 去
%rip指向的地址取 1 个字节。 - 译码,看是不是合法的机器码。
- 执行。
CPU 根本不在乎这块内存是叫“代码段(Text)”还是叫“栈(Stack)”。只要 %rip 指向了栈上的地址,且那个内存页有“可执行(x)权限”,CPU 就会毫不犹豫地把栈上的数据当成指令来跑。
2. 曾经的黄金时代(32位与未保护系统)
在早期的 x86 32 位 Linux 或者现在某些没有开启 NX 的 CTF 题里,栈的权限是 rwx (可读、可写、可执行) 。
这就是你上一张图(Code Injection Attacks)能够成功的直接原因:攻击者把 Shellcode(一段机器码)写进 buf,然后把返回地址 A 覆盖成 buf 的地址 B。ret 一执行,%rip 跳到 B,CPU 就开始在栈上执行攻击者的机器码。
3. 现代操作系统的防线(NX / XD 位)
为了彻底杜绝这种攻击,硬件和操作系统联手推出了保护方案:
- 硬件层面:AMD 叫 NX(No-eXecute),Intel 叫 XD(Execute Disable)。在 CPU 的页表(Page Table)中增加了一个特殊标志位。
- 操作系统层面:Linux/Windows 加载程序时,会将栈和堆标记为
rw- (可读写,不可执行) 。 - 发生了什么? 当攻击者依然用代码注入,把返回地址覆盖成栈地址时,
ret 执行,%rip 跳到栈上。CPU 的 MMU(内存管理单元)在取指瞬间检查页表,发现当前页的 NX 位被置位,立刻触发硬件异常(段错误 / Segmentation Fault) ,进程直接被杀。
你之前看 vmmap 时,栈是 [stack] 且权限是 rw-p,那个 p 是私有(Private),没有 x,这就意味着代码注入在现代 Linux 上打不通。
4. 现代 Pwn 的解法:ROP(返回导向编程)
既然不能执行自己的代码,攻击者就想了一个聪明的办法:借用程序本来就有的代码。
- 我不往栈里写机器码了(写了也执行不了)。
- 我去程序或
libc 里找现成的指令片段(Gadgets,比如pop rdi; ret)。 - 我利用溢出,把这些已有代码的地址排布在栈上。
- 当
ret 执行时,%rip 跳去代码段(有x 权限)执行这些片段,拼凑出system("/bin/sh")的效果。
这就是为什么你上一题算偏移量、找 p64(system_addr) 是现在的主流打法,而直接在栈上写 Shellcode 的做法在 NX enabled 的环境下已经行不通了。
💡 特殊情况:什么时候现在还能在栈上执行代码?
如果你非要执行栈上的代码,现代系统下也不是绝对不行:
- CTF 题目故意关掉 NX:
checksec 显示NX disabled,此时你依然可以快乐地写 Shellcode。 - 利用
mprotect 等系统调用:如果有漏洞能让你调用mprotect 把栈的内存页权限改为rwx,你就能在栈上执行了(但这通常需要非常复杂的 ROP 链)。 - JIT(即时编译) :像 JavaScript 引擎(V8)为了防止性能损耗,会动态生成机器码并放在可执行的堆上,攻击者有时会利用 JIT 喷射(JIT Spray)来绕过 NX。
为了避免缓冲区溢出,在最基础的程序设计上可以:
- 可以用更安全的输入方式,比如用fgets替代gets
- 用strncpy替代strcpy
- scanf使用的时候可以增加 %s
更安全的,可以使用ASLR(Address Space Layout Randomization),即地址空间分布随机化
ASLR 通常随机化这些区域:
- 栈的起始位置/栈顶附近
- 共享库、动态链接器的加载基址
mmap映射区基址- 堆的起始地址,取决于系统配置
- PIE 可执行文件的加载基址
- vDSO、vvar 等
在 Linux 中,ASLR 强度由 /proc/sys/kernel/randomize_va_space 控制:
0:关闭1:随机化栈、共享库、mmap 等2:在 1的基础上再随机化堆
所以结论是:
ASLR 是地址空间布局随机化;栈起始地址随机化是 ASLR 的一种表现形式/子集。若二选一,应选“内存地址随机化/地址空间布局随机化”,而不是“仅栈起始地址随机化”。
除了ASLR,还有子统计安全保护机制:不可执行代码段,也就是常说的NX位或DEP:
- 传统 x86 的致命缺陷:在早期的 x86 架构中,内存页只能被标记为“只读(read-only)”或“可写(writeable)”。没有单独的“可执行(execute)”权限。这意味着:只要一块内存是可读的,CPU 就允许执行里面的代码。攻击者只要能把恶意代码塞进栈里,就能骗过 CPU 去执行它。
- x86-64 的改进:引入了明确的“执行(execute)”权限。操作系统借此将栈(Stack)标记为不可执行(non-executable) 。
如果开启了 NX 保护,当攻击者试图让 CPU 执行栈上的 exploit code 时,CPU 会发现该内存区域(栈)只有读写权限,没有执行权限,于是抛出硬件异常(段错误),直接让程序崩溃,从而阻止了攻击。
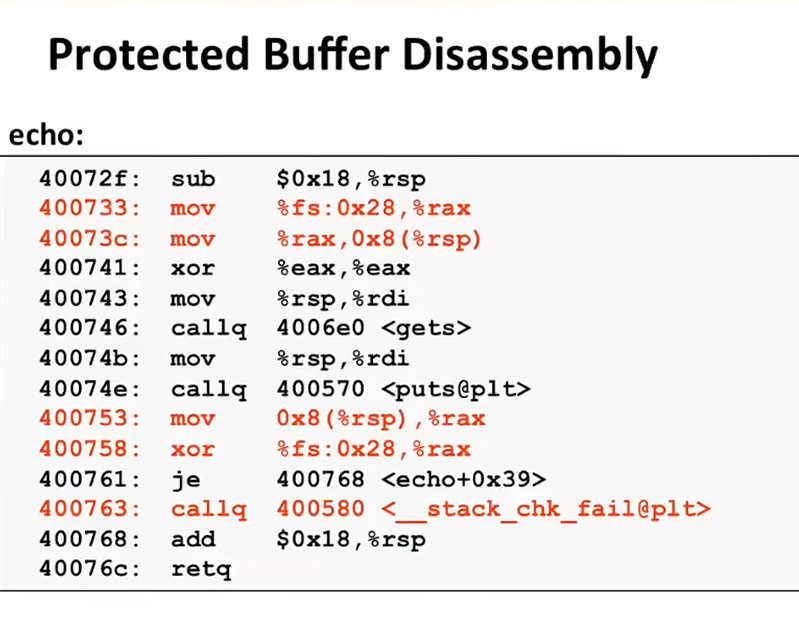
Canaries(金丝雀)对防护也有作用:它是一种放在栈上的特殊随机值,用来检测是否发生了栈缓冲区溢出。
1. 工作原理(Idea)
- 放置位置(Place special value just beyond buffer) :
函数在进入时,会在栈上的局部变量(缓冲区) 和保存的返回地址(以及栈帧指针) 之间,偷偷塞进去一个随机值(这就是金丝雀)。
内存布局大致如下:
[ 局部变量/缓冲区 ] -> [ 金丝雀值 ] -> [ 保存的栈帧指针 EBP ] -> [ 返回地址 ] - 检查机制(Check for corruption before exiting function) :
函数在执行完毕、准备返回之前,会去检查这个金丝雀值是否还是原来那个。
2. 如何防御攻击?
在上一张 PPT(NX)中,攻击者试图用 gets() 溢出缓冲区,覆盖返回地址 B。
但现在有了金丝雀,攻击者为了覆盖返回地址,必须先覆盖掉前面的金丝雀值。由于攻击者不知道这个随机值是什么,他们填进去的数据大概率会改变金丝雀。
当函数准备返回时,检查机制发现金丝雀值被篡改了:
- 程序会立刻调用
__stack_chk_fail函数。 - 程序直接崩溃(抛出异常并终止),绝不会去执行被覆盖的恶意返回地址。
3. GCC 编译器实现(PPT下方)
-fstack-protector:这是 GCC 提供的一个编译选项,用于自动插入金丝雀保护代码。- 现在通常已经作为很多现代操作系统的默认配置(Now the default),不需要程序员手动去写代码,编译器在编译时自动加上。
💡 延伸:金丝雀的种类
攻击者也在不断进化,所以金丝雀也分几种:
- Terminator Canary:包含
\x00(空字节)、换行符、EOF 等。因为很多溢出函数(如 strcpy, gets)遇到这些字符会停止读取,从而防止溢出覆盖。 - Random Canary:程序启动时生成一个完全随机的值。每次运行都不一样。
- Random XOR Canary:将随机值与返回地址等关键数据异或,不仅防覆盖,还防信息泄露。
总结:现代系统防御体系(三剑客)
到此,你已经集齐了现代系统抵御栈溢出攻击的三大防线:
- ASLR(地址空间随机化) :让攻击者找不到代码在哪(无法预测地址)。
- NX/DEP(不可执行位) :就算攻击者跳过来了,CPU 也拒绝执行栈上的代码(上一张PPT)。
- Stack Canary(栈金丝雀) :只要攻击者敢乱写,函数在返回前就会报警拉闸(这张PPT)。
这三者通常是协同工作的,极大地提高了软件的安全性。
push   %rbp                 # main 的基地址入栈,保存调用者的 rbp
mov    %rsp, %rbp           # 把当前栈指针复制给基址指针,建立 main 的栈帧
sub    $0x10, %rsp          # 给 a[10] 分配 16 字节栈空间(高位向低位生长,所以 rsp 减 0x10)
; ...
lea    -0x10(%rbp), %rax    # 【纠正】这是把 rbp-0x10 这个“地址值”放入 rax,没有访问内存!
mov    %rax, %rsi           # scanf 的第 2 个参数 (buffer)
lea    0xe4f(%rip), %rdi    # scanf 的第 1 个参数 "%s" (通过 RIP 相对寻址)
mov    $0x0, %eax           # 调用可变参数函数前清零 eax
call   scanf@plt
; ...
lea    0xe4a(%rip), %rdi    # system 的参数 "whoami"
call   system@plt
; ...
mov    $0x0, %eax           # main 返回 0
leave                       # 等价于 mov %rbp, %rsp; pop %rbp
ret                         # 等价于 pop %rip
高地址
[   返回地址 RIP   ]  <-- rbp + 0x8 (8字节)
[   保存的 RBP     ]  <-- rbp (8字节)
[   填充对齐区     ]  <-- rbp - 0x8 到 rbp (6字节,为了凑齐16字节分配)
[   a[0] ~ a[9]   ]  <-- rbp - 0xC (10字节)
低地址
针对这些防护,现在又有了新的攻击手法,即 ROP (Return-Oriented Programming),返回导向编程
ROP 的核心思想是:利用程序自身或者动态链接库(如 libc)中已经存在的代码片段(Gadgets),通过操控栈上的返回地址,把它们像拼乐高一样拼接起来,形成一条攻击链。
什么是 Gadget?
Gadget 是一段以 ret 指令(0xC3)结尾的极短指令序列。
比如:
pop rdi; retpop rsi; pop r15; retsyscall; ret
这些 Gadget 本身就是程序正常编译后产生的合法指令。攻击者只需要知道这些 Gadget 在内存中的绝对地址。
具体执行流程演示:
假设攻击者构造了如下 Payload(攻击载荷)覆盖栈:
高地址
| ... (其他数据)
| [ system 函数的地址 ]   <-- 准备作为 ret 的目标
| [ "/bin/sh" 的地址  ]   <-- 准备被 pop 给 rdi
| [ pop rdi; ret 的地址 ] <-- 覆盖原本的返回地址
| [ 填充垃圾数据      ]
低地址 (rsp 当前指向这里)
当原函数执行 ret 时,奇妙的化学反应开始了:
- 第一步:
ret 弹出栈顶的 pop rdi; ret 的地址,赋值给 rip。程序跳转到这个 Gadget 执行。 - 第二步:执行
pop rdi。把此时栈顶的 "/bin/sh" 的地址 弹出,完美存入 rdi 寄存器。此时 rsp 下移 8 字节,指向了 system 函数的地址。 - 第三步:执行
ret。把此时栈顶的 system 函数的地址 弹出,赋值给 rip。程序跳转到 system函数执行。 - 最终结果:程序执行了
system() 函数,并且因为第二步的操作,rdi 里已经装好了 "/bin/sh" 的地址。
等价于执行了: system("/bin/sh") ,攻击者成功拿到 Shell!
Unions会使用占用空间最大的域的大小来分配内存,一次只能用一个