L08 Machine-Level Programming IV: Data
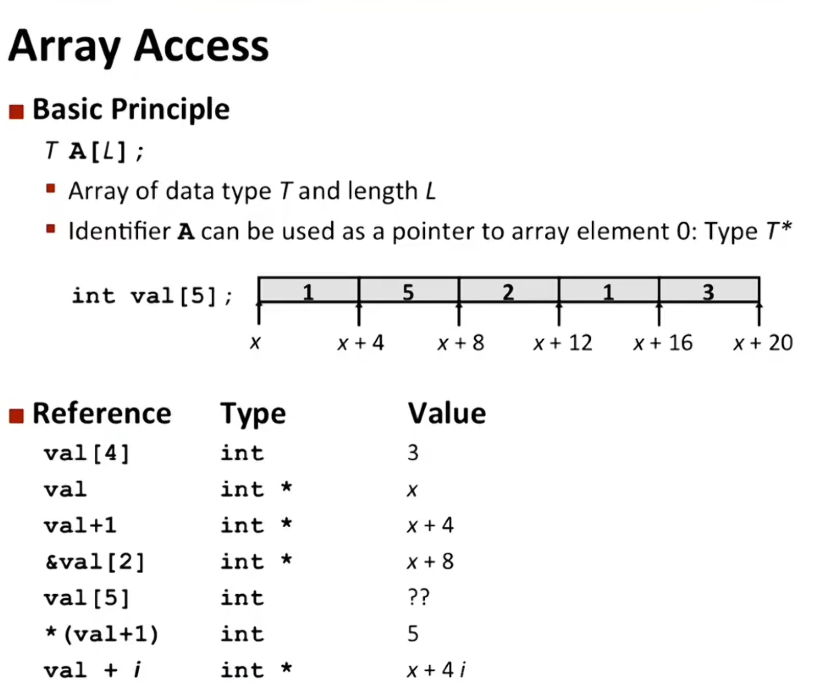
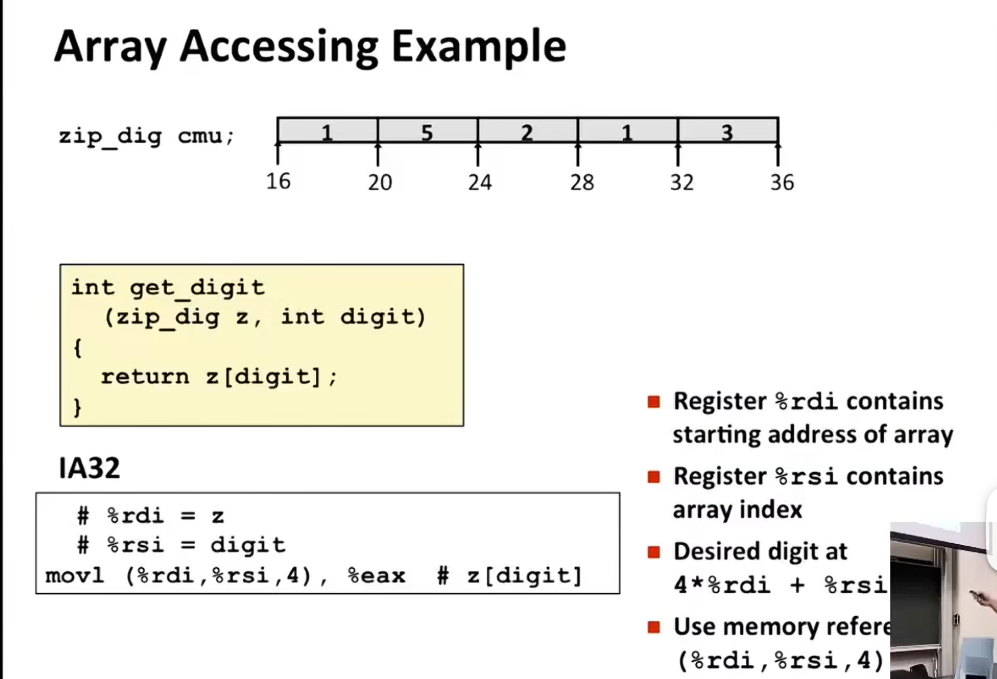
在这个实例中 rdi表示一个数组地址,rsi是需要查询的下标,所以%rdi,%rsi,4 是在以4字节为步长,找rdi寄存器中起始地址+4z的地址,然后内存引用,把这里面的值传递给eax(32位的rax清空高32位),这里的PPT做的有问题
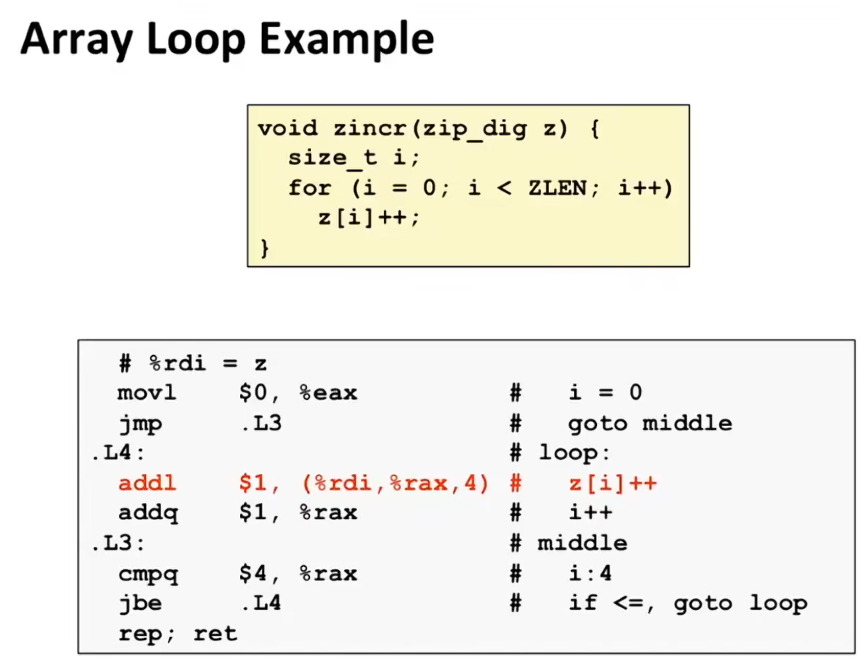
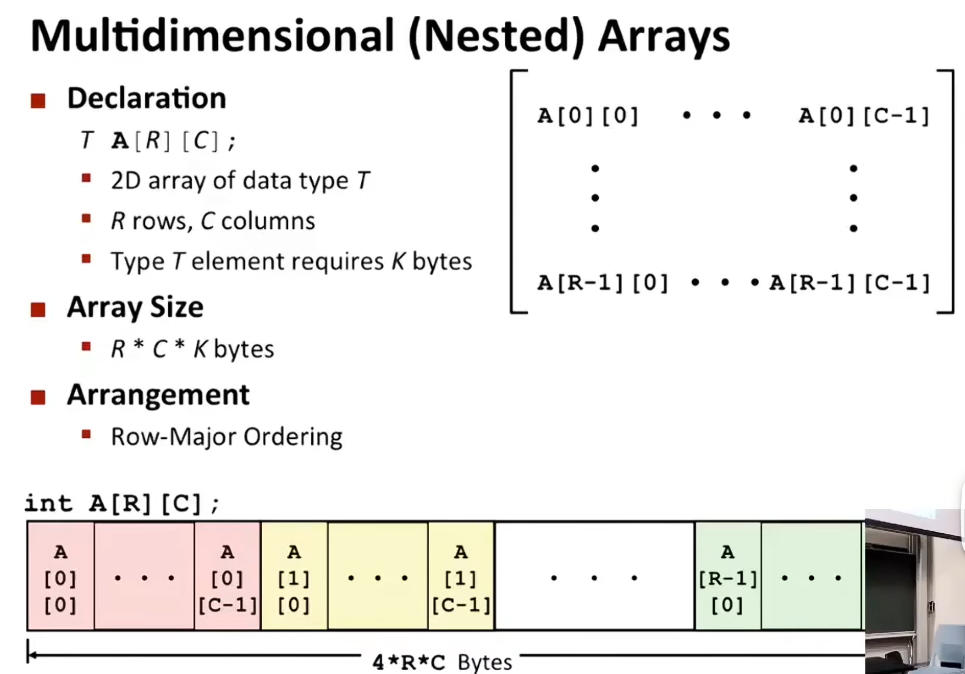
在64位操作系统(现在的主流环境)下:
-
sizeof(A1) = 8字节:因为A1是一个指针(地址),在64位系统里,所有指针变量的尺寸固定是 8 字节(8 * 8 = 64位)。 -
sizeof(*A1) = 4字节:因为A1 是int 类型指针,解引用*A1 得到的就是一个int 类型的变量。在常规C语言标准中,int占 4 字节。
为了让你把这个问题和刚刚那张“多维数组”的 PPT 彻底融合,再帮你补充几个极其容易踩坑的延伸点:
1. 结合 PPT 的“多维数组”场景
PPT 里的数组是 int A[R][C]。
假设 A1 是 int * 类型(例如 int *A1 = A[0]; 或 int *A1 = &A[0][0];):
A1 指向的是数组里的某一个格子(一个int)。sizeof(A1)= 8 字节(指针本身)。sizeof(*A1) = 4 字节(格子里的数据int)。
2. 如果你写 int (*A1)[C] = A; 呢?(这是一个常考陷阱)
如果 A1 被声明为指向整个数组的一行的指针(行指针):
-
sizeof(A1):依然是 8字节(它还是一个指针)。 -
sizeof(*A1):此时解引用得到的是一整行(即一个包含C 个int的数组)。- 所以结果是
4 * C 字节。如果 C=5,那sizeof(*A1)就是 20 字节。 - 这也就是 PPT 底部写的
4 * R * C的一个推导逻辑。
- 所以结果是
3. 一个经典陷阱:如果 A1 是一个数组名呢?
如果代码里直接写 int A1[10];,那 A1 不是指针,而是数组本身。
sizeof(A1) 会变成 40 字节(10 * 4),而不是 8 字节。因为数组名在sizeof 面前不会退化成指针。- 但只要把数组名传进函数当参数,函数里的
sizeof(A1) 就会立刻退化成指针,变回 8 字节。
二维数组 行优先排序
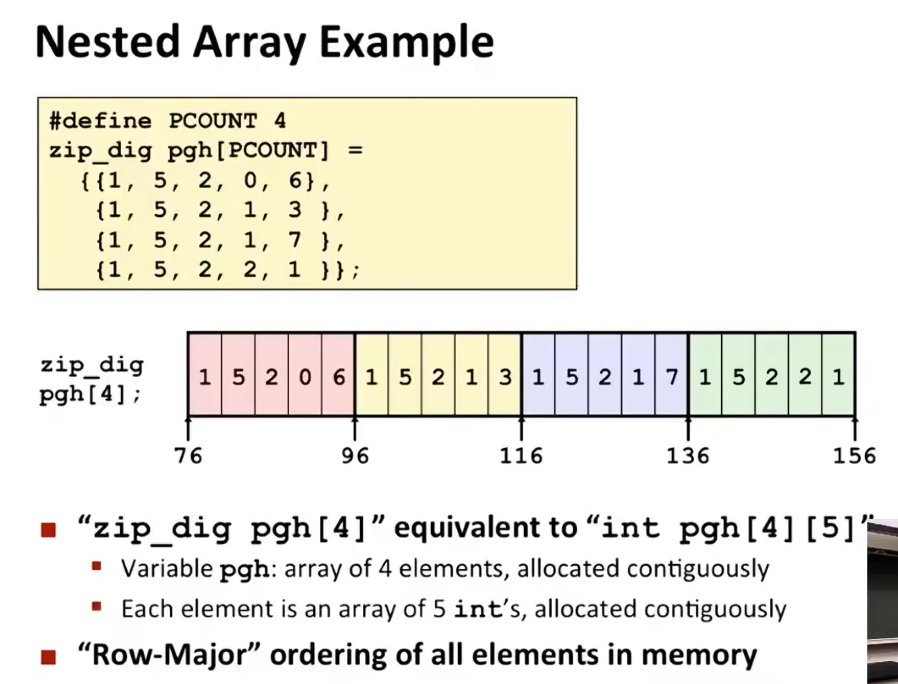
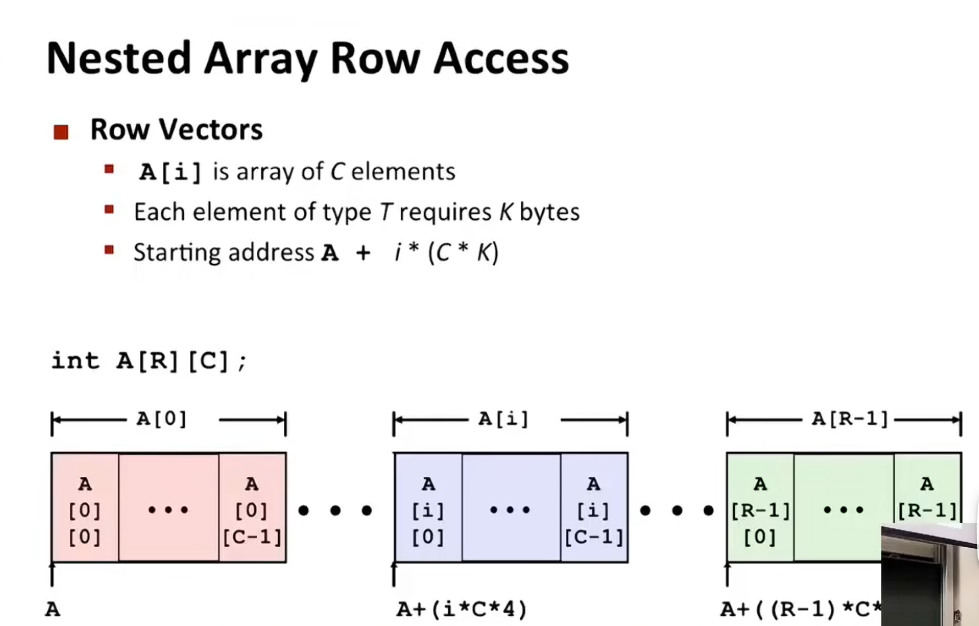
寻址公式 : 起始+i*(c * k) i是行 c是元素个数 k是每个元素的占用大小
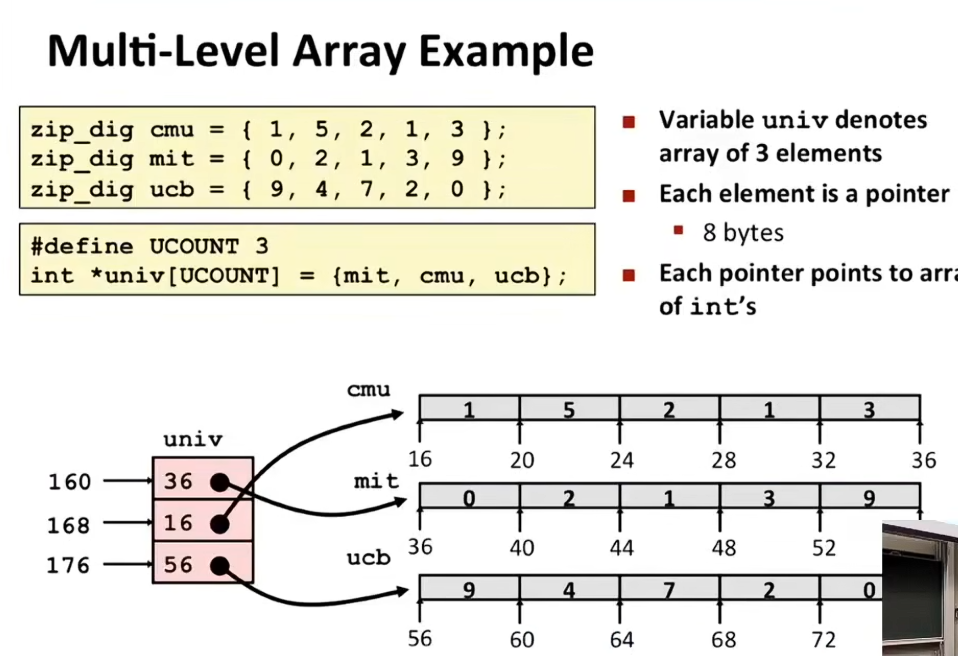
这张图(CSAPP 教材的经典内容)是在向你展示 “多级数组(Multi-Level Array)” ,也就是指针数组。它是对比上一张“嵌套数组(Nested Array)”的另一种二维数据组织方式。
直接回答你的困惑:如果说上一张图是“真正的二维矩阵”,这张图就是“散落的数组”加了一本“通讯录”。
我帮你把这张图的核心逻辑拆解成四个层面:
1. 代码到底声明了什么?
仔细看左侧代码:
zip_dig cmu = { 1, 5, 2, 1, 3 };  // zip_dig 就是 int[5]
zip_dig mit = { 0, 2, 1, 3, 9 };
zip_dig ucb = { 9, 4, 7, 2, 0 };
#define UCOUNT 3
int *univ[UCOUNT] = {mit, cmu, ucb};
univ 是一个数组,大小为 3。univ 里的每个元素是一个指针(int * ) 。- 这些指针分别指向了三个独立的数组(
mit,cmu,ucb)。 - 因为
univ 存的是指针,所以在 64 位系统下,每个元素占 8 字节。
2. 内存图上的具体情况(图的解读)
-
左侧
univ 数组(地址 160, 168, 176) :univ[0] 在地址 160,存的值是36(即mit的首地址)。univ[1] 在地址 168,存的值是16(即cmu的首地址)。univ[2] 在地址 176,存的值是56(即ucb的首地址)。- 总大小:3 个指针 × 8 字节 = 24 字节(从地址 160 到 184)。
-
右侧三个独立数组(地址 16, 36, 56) :
- 它们分散在内存的其他地方,各有 5 个
int(每个 20 字节)。 - 黑线箭头就是“指针赋值”的体现:
univ里的指针分别指向了这三个远端数组。
- 它们分散在内存的其他地方,各有 5 个
3. 和上一张图(嵌套数组)的核心区别
这才是这张 PPT 真正的教学目的!
| 对比项 | 上一张图(zip_dig pgh[4]) |
这一张图(int *univ[3]) |
|---|---|---|
| 物理内存布局 | 连续。40 个 int 紧密排列在一起。 |
不连续。24 字节的指针数组 + 3 块独立的 20 字节数组。 |
| 总内存大小 | 4 * 5 * 4 = 80 字节 | 24 + (3 * 5 * 4) = 84 字节 |
| 汇编寻址方式 | 基址 + (行索引 * 20) + (列索引 * 4) |
两次内存访问(双重解引用): 1. 先取指针: univ[i]2. 再取数据: *(univ[i] + j * 4) |
| 灵活性 | 死板。每行长度必须一样。 | 灵活。每行长度可以不一样(也就是 C 语言里的“锯齿状数组”)。 |
| 缓存局部性 | 极好。一整块连续数据,CPU 缓存命中率高。 | 较差。数据散落各地,容易产生缓存未命中。 |
4. 怎么算 univ[2][3] 的值?(考试常考)
如果是嵌套数组,公式是:基地址 + (2 * 5 + 3) * 4。
但在多级数组里,你要分两步走:
- 查通讯录:去
univ 数组找第 2 个元素(偏移2 * 8 = 16 字节)。从地址160 + 16 = 176 处取出56。 - 去实地取货:以
56 为基地址,找第 3 个int(偏移3 * 4 = 12 字节)。去地址56 + 12 = 68 处取出2。
汇编会写成两次mov:
movq 176(%rdi), %rax  # 第一步:取出 univ[2] 指针 (结果是 56)
movl 12(%rax), %eax   # 第二步:取出 *(56 + 12) 的值 (结果是 2)
💡 补充一个 C 语言的 sizeof 陷阱
对比一下:
int pgh[4][5] 的sizeof(pgh) =80字节。int *univ[3] 的sizeof(univ) =24字节(仅仅是指针数组的大小)。
总结一句话:这图是在说,如果你想存储多维数据,除了直接开大块连续内存(嵌套数组),还可以用“指针数组”把数据打散,用空间换灵活性。由于它多了一层指针跳转,访问变慢了,但也方便了“各行不等长”的需求。
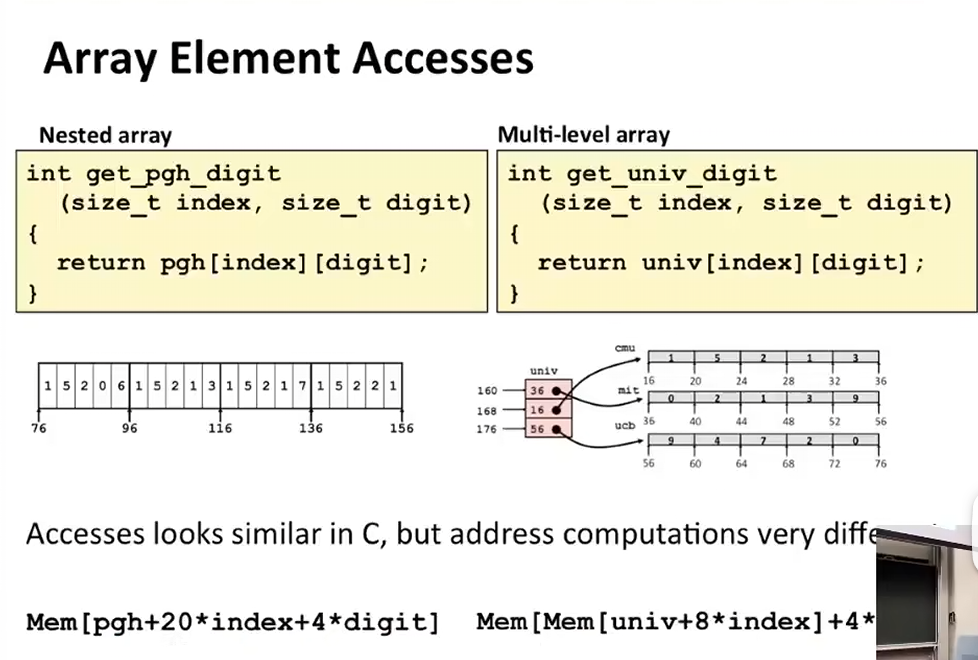
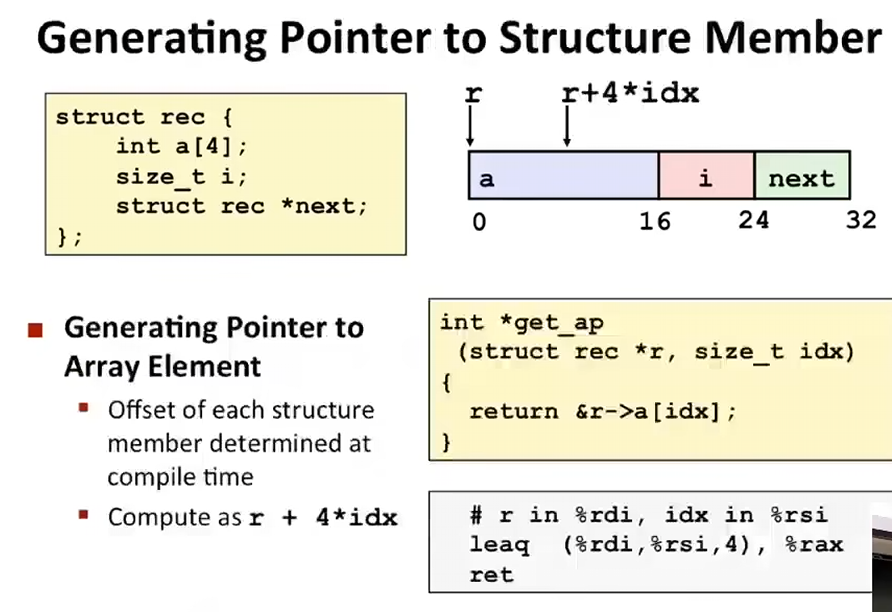
同样,对于结构体,也可以构造类似的内存地址偏移公式来访问成员
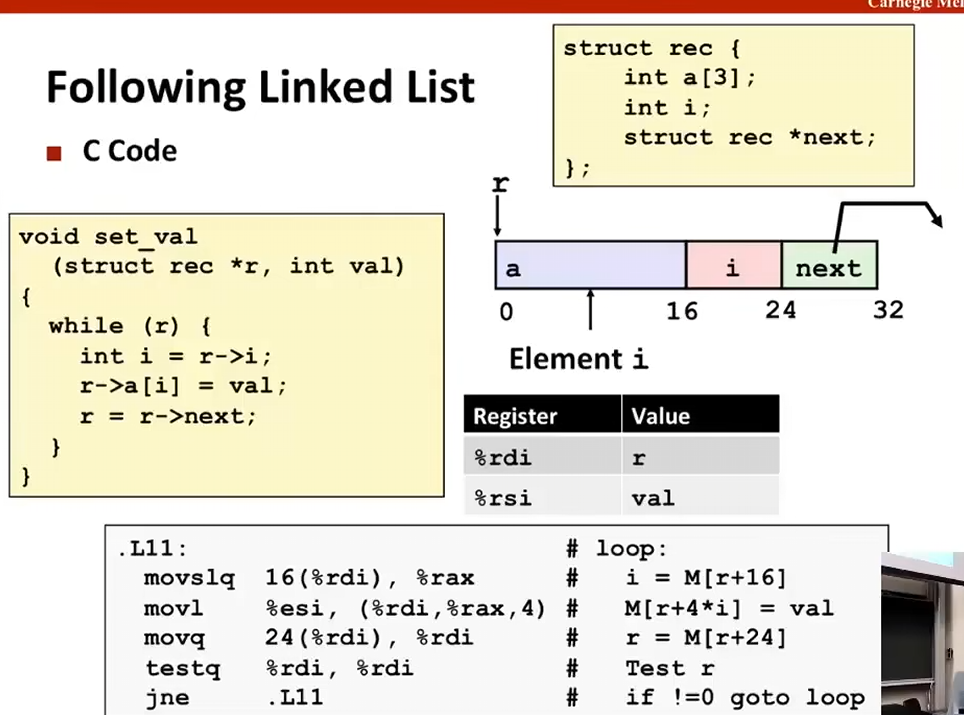
这里是在遍历链表
这张图(CSAPP 的经典内容)把 C 语言链表遍历、结构体内存布局和汇编代码完美对应在了一起。我来帮你把图中的每一行汇编和 C 代码精准映射,让你彻底看透这套逻辑。
1. C 代码的逻辑(图左上)
void set_val(struct rec *r, int val) {
    while (r) {                 // 只要指针不为空
        int i = r->i;           // 取出节点里的下标 i
        r->a[i] = val;          // 把 val 写入数组 a 的第 i 个位置
        r = r->next;            // 指针移向下一个节点
    }
}
这就是标准的单链表遍历:沿着一串节点一路走到底,直到遇到 NULL 为止。
2. 结构体内存布局(图右上)
图右上给出了 struct rec 的布局:
int a[3]:偏移量 0 到 16(这里占 16 字节,说明有 4 字节的对齐填充)。int i:偏移量 16(占 4 字节)。struct rec *next:偏移量 24(占 8 字节)。- 整体大小:32 字节。
寄存器分配:
%rdi =r(当前节点的指针)%rsi =val(要写入的值)
3. 逐行拆解汇编代码(图下方)
.L11:                                 # loop:
    movslq 16(%rdi), %rax             # i = M[r+16]
    movl   %esi, (%rdi,%rax,4)        # M[r+4*i] = val
    movq   24(%rdi), %rdi             # r = M[r+24]
    testq  %rdi, %rdi                 # Test r
    jne    .L11                       # if !=0 goto loop
逐行翻译:
-
movslq 16(%rdi), %rax- 结构体偏移 16 是成员
i。 movslq(Move Sign-Extended Long to Quad):从内存读取 4 字节(int i),将其符号扩展为 64 位,存入%rax。- 对应 C 代码:
int i = r->i;。之所以要扩展为 64 位,是因为接下来它要作为数组的下标参与 64 位地址计算。
- 结构体偏移 16 是成员
-
movl %esi, (%rdi,%rax,4)%esi 里存的是参数val。- 目标地址是
%rdi + %rax * 4。 %rdi 是结构体首地址(数组a 的起点),%rax 是刚才取出的i,乘以 4 是因为int占 4 字节。- 把
val 写入这个地址。对应 C 代码:r->a[i] = val;
-
movq 24(%rdi), %rdi- 结构体偏移 24 是成员
next。 - 从内存读取 8 字节(指针),直接覆盖写入
%rdi寄存器。 - 极其精妙的一点:这一步直接完成了
r = r->next;。它既读取了下一个节点的地址,又把%rdi更新成了这个新地址,一举两得。
- 结构体偏移 24 是成员
-
testq %rdi, %rdi + jne .L11testq 自己和自己做“与”运算,用来判断%rdi 是不是 0(也就是NULL)。jne(Jump if Not Equal):如果%rdi 不为 0,就跳回.L11循环开头。- 对应 C 代码:
while (r)。
4. 图中表格的校验(寄存器表)
图中间的表格:
%rdi =r(当前节点指针)%rsi =val (要写入的值)
这个表提示你在函数入口处,参数是通过这两个寄存器传入的。循环过程中%rdi 会不断更新,%rsi保持不变。
5. 为什么这段汇编效率极高?
- 没有额外的变量存取,
%rdi直接当作节点指针。 movl 写入内存后,不需要做任何判断,立刻通过movq 24(%rdi), %rdi把指针顺移到下一个节点。- 这种写法是编译器的常见优化,将链表遍历的 “取数据-计算-写数据-移动指针-判断” 压缩进了极少的指令里。
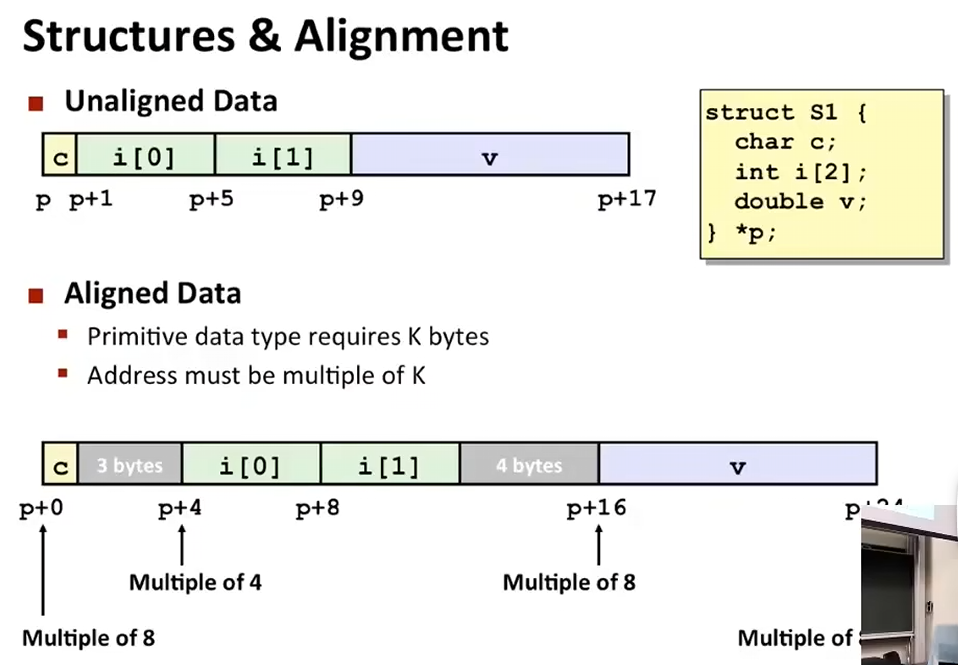
这里讲述的是内存对齐Memory Alignment
1. 代码的基础结构
struct S1 {
    char c;      // 1字节
    int i[2];    // 2个int,共8字节
    double v;    // 8字节
} *p;
在 64 位系统下,char 占 1 字节,int 占 4 字节,double 占 8 字节。
2. 上半部分:未对齐的数据(Unaligned Data)
图上方展示了如果不加任何干预,直接把数据挨个塞进内存的样子:
c 放在p处(第 1 字节)。i[0] 紧接着放在p+1(第 2 字节)。i[1] 放在p+5(第 6 字节)。v 放在p+9(第 10 字节)。- 总大小:17 字节(完全没有浪费空间)。
看起来很完美,但硬件不买账!
因为 CPU 读取内存时,并不是一个字节一个字节读的,而是按块(比如 4 字节或 8 字节)读取的。如果一个 int(4字节)跨越了内存块边界(即它的起始地址不是 4 的倍数),CPU 可能要发起两次内存访问才能把它读完,严重影响性能。在某些老旧架构(如早期的 ARM、SPARC)上,这种未对齐访问甚至会直接导致程序崩溃(总线错误) 。
3. 下半部分:对齐的数据(Aligned Data)
图下方给出了对齐的硬性规则(图中间的红色字):
- Primitive data type requires K bytes
- Address must be multiple of K
意思是:一个大小为 K 字节的基础数据类型,它的起始地址必须是 K 的倍数。 (比如int 是 4 字节,它的地址必须是 4 的倍数;double是 8 字节,它的地址必须是 8 的倍数)。
按照这个规则,编译器实际生成的内存布局变成了这样:
c 放在p+0(大小1,地址是1的倍数,没问题)。- 编译器插入 3 字节的“填充(Padding)” (
p+1 到p+3)。 i[0] 放在p+4(4 的倍数,大小 4)。i[1] 放在p+8(4 的倍数,大小 4)。- 编译器插入 4 字节的“填充” (
p+12 到p+15)。 v 放在p+16(8 的倍数,大小 8)。
最终,这个结构体占用了 24 字节(1 + 3填充 + 8 + 4填充 + 8 = 24)。
4. 解答图中的几个细节追问
- 为什么底部箭头标注
Multiple of 8 (8的倍数)?
除了成员内部要“各自对齐”,结构体本身还有一个“整体对齐”规则:结构体的总大小必须是其内部最大成员对齐要求的整数倍。
这个结构体里最大的是double v(对齐要求 8 字节),所以struct S1 的总大小必须是 8 的倍数。17 字节不是 8 的倍数,24 才是。这样在声明struct S1 arr[2];数组时,每一个结构体的起始地址才能依然满足 8 字节对齐。 - 最后的
p+24 就是结束位置
所以整个结构体被撑到了 24 字节。
5. 如何优化?(空间换时间 vs 时间换空间)
如果你嫌 24 字节太浪费,你可以通过改变成员的声明顺序来压缩空间(这也是一道经典面试题):
c
struct S1_optimized {
    double v;    // 8字节
    int i[2];    // 8字节
    char c;      // 1字节
    // 尾部填充 7 字节
};
这样 v 在 p+0,i 在 p+8,c 在 p+16,总共只需要 17 字节(加上尾部填充变成24字节) 。
等等,这里有个陷阱:把 double 放开头,c 放最后,总大小会变成 24 字节。但如果改成:int i[2]; char c; double v; 顺序,总大小依然是 24(中间会有 3 字节填充,尾部 4 字节填充)。最极致的压缩往往受限于最大对齐要求。
一句话总结:你看到的“似乎是一种对齐”,就是编译器为了迎合 CPU 的读取规律,牺牲几个字节的内存,把每个数据的起始地址都垫到其自身大小的整数倍上。这就是内存对齐。✅
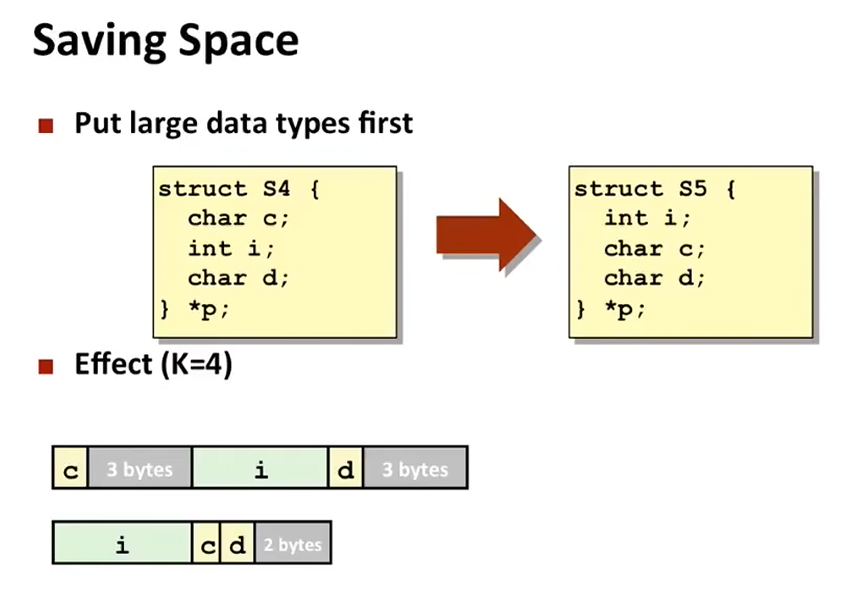
这是一种优化