L07 Machine-Level Programming III: Procedures
在x86-64中,栈在过程控制中起到了关键作用。内存中专门有一块地方被划出来作为栈。程序用栈来管理过程调用与返回状态
栈是一种先进后出的数据结构,有栈顶和栈底。
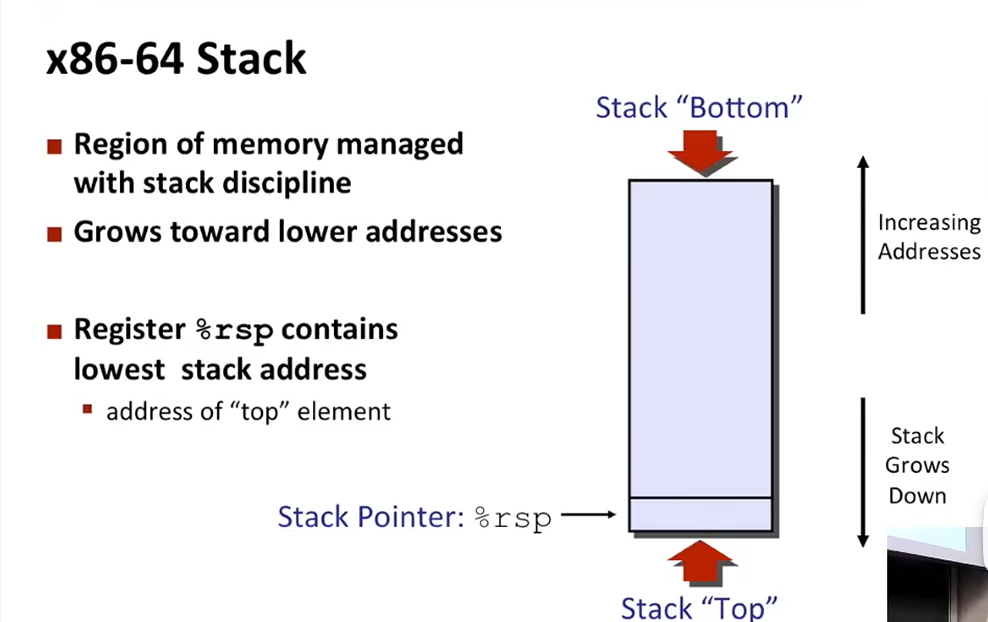
%rsp是栈顶指针,他的值是当前栈顶部的地址。栈的起始地址通常是高位,当栈中的数据增加时,栈指针会递减。
约定俗成中,栈是倒着画的(栈顶在下),并且地址是从下往上递增的(上面时高位地址),所以当增加数据时,指针递减。
我们有push(入栈) pop(出栈)两种指令对栈进行操作,经常写作pushq popq(对quadword进行操作):
pushq src: src可以是寄存器 内存 或者立即数(常数),读取src的数据,随后将栈指针地址-8Bytes 然后把数据存进去
同理 popq dest 把当前栈指针的数据读出来写到dest去,随后栈地址+8Bytes。对pop的dest而言,目标必须是寄存器或内存地址。
完整的 pushq / popq 速查表
| 指令 | 操作数类型 | 是否合法 | 示例 |
|---|---|---|---|
pushq |
寄存器 | ✅ | pushq %rbx |
| 内存 | ✅ | pushq (%rsi) |
|
| 立即数 | ✅ | pushq $0xFF |
|
popq |
寄存器 | ✅ | popq %rax |
| 内存 | ✅ | popq (%rsp) |
|
| 立即数 | ❌ | popq $123(汇编器报错) |
补充:你没有提到但值得记住的细节
-
popq %rsp 是特殊行为:如果目标是%rsp,CPU 会先将栈顶数据加载到%rsp,然后再调整栈指针(这种行为极其罕见,建议不要这样写,容易造成混乱)。 - 方向:
push 是“压”(栈向下增长),pop是“弹”(栈向上收缩),你描述的顺序完全正确。
call 和 return的思想和栈是类似的,以下例子说明了这一点:
long mult2(long a, long b){
    long s = a*b;
    return s;
}

void multstore(long x, long y, long *dest){	  #dest是一个指针
	long t = mult2(x,y);	#调用mult2
    *dest = t;	#指针解引用,存储t
}
那么,在汇编层面,就可能是这样的:
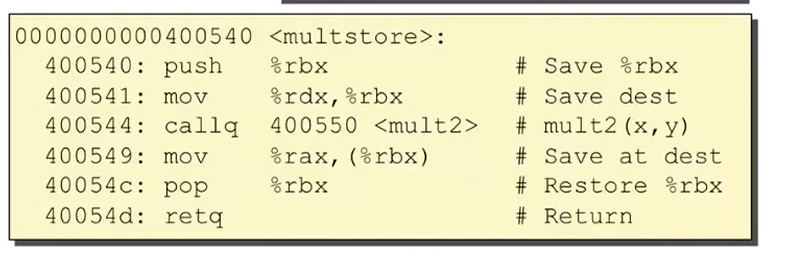
push %rbx #将rbx的值保存到栈中,因为接下来会被覆盖
mov %rdx, %rbx #把dest的指针地址保存到rbx这个寄存器中
callq 400550 <mult2> #调用方法
mov %rax, (%rbx) #rbx里面之前存放的是一个地址,所以需要用()内存引用,就是把计算出来的值写道rbx里面去
pop %rbx #栈顶原先是之前rbx的值,现在出栈,重新写回rbx
retq #返回现在rax寄存器中的值

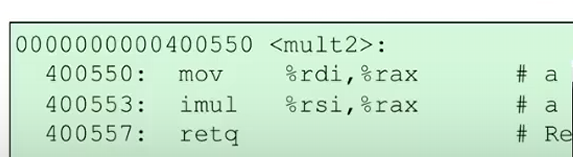
<mult2>:
mov %rdi, %rax # 将函数的第一个参数复制到rax寄存器
imul %rsi, %rax #%rax = %rax * %rsi 第一个参数和第二个参数相乘,写入rax
retq #返回rax
在这里,我们使用了 rbx作为栈上原先数据的寄存,理论上是可以使用其他寄存器的,但是通常我们遵循ABI的调用约定:
1. 硬性规则(ABI 调用约定)
在 x86-64 架构中(你用的 System V ABI),寄存器有明确的身份分工:
| 寄存器分类 | 典型成员 | 特性(决定你能否用) |
|---|---|---|
| 参数寄存器 | %rdi, %rsi, %rdx, %rcx, %r8, %r9 |
在 call 调用前后,会被调用者(callee)随意覆盖。如果你把 dest 存这里,调用完 mult2 后数据可能就丢了。 |
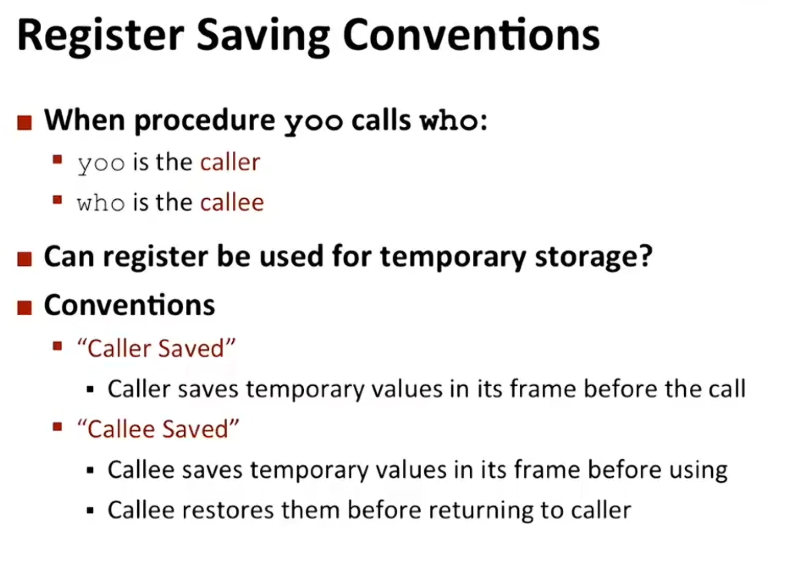
| 调用者保存(Caller-saved) | %rax, %rcx, %rdx, %rsi, %rdi, %r8~%r11 |
如果你要用它们存 dest,必须在 call 之前自己压栈保存,调用完再弹栈恢复。 |
| 被调用者保存(Callee-saved) | %rbx, %rbp, %r12~%r15 |
被调用者(mult2)必须保证这些寄存器的值在返回时和进入时一样。所以你存 dest 在这里,即使调用 mult2,也不怕被篡改。 |
所以:你当然可以用 %r8 或 %r10(调用者保存)来存 dest,但那样你仍然要 push %r8 和 pop %r8。既然都要 push/pop,为什么不直接用“被调用者保存”的寄存器呢?——这就是 GCC 的逻辑。
2. 为什么 GCC 偏偏选了 %rbx,而不是 %r12 或 %rbp?
既然 %rbx、%r12、%r13、%r14、%r15 都属“被调用者保存”类,功能等价,为什么特指 %rbx?
答案:为了节省指令长度(REX 前缀)!
在 64 位模式下:
- 访问
%rbx、%rbp、%rsp 等低 8 个通用寄存器,指令编码不需要额外的 REX 前缀(1 个字节)。 - 访问
%r12 ~%r15(扩展寄存器),指令编码必须带 REX 前缀(多占 1 个字节)。
push %rbx 编码只需 1 个字节,而 push %r12 编码需 2 个字节。
在大型程序里,编译器会优先选择 %rbx 来节省一点点代码体积(这属于微优化)。
3. 如果我用 %r10(调用者保存)会怎样?
如果你这样写汇编(把 %rdx 复制到 %r10,不 push):
assembly
mov %rdx, %r10
callq mult2
mov %rax, (%r10)
虽然在这个简单的 mult2 函数里,它没有动 %r10,所以碰巧能跑对。
但编译器(作为通用工具)不会冒这个险,因为调用约定规定 %r10 是“调用者保存”,意味着 mult2 在理论上有权随意修改 %r10 而不负责恢复。为了 100% 安全,GCC 绝不会把需要跨 call 存活的变量放在调用者保存寄存器里(除非它确认 mult2 内部没用到,但在复杂优化中难以保证)。
在上述例子中,我们使用了call和ret。要调用一个函数,只需要call此函数的标签,需要返回的时候只需要ret。他们只是做了控制部分。
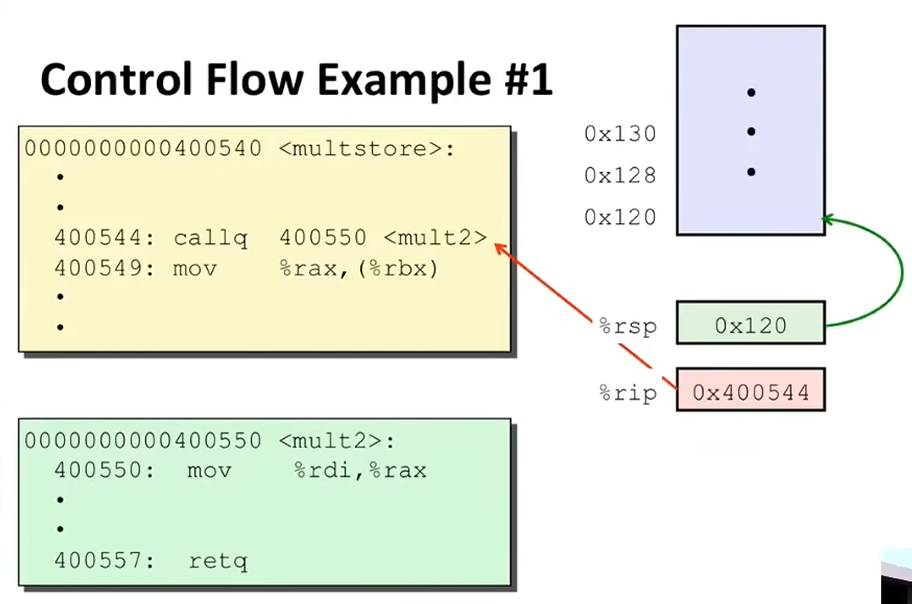
在这个例子中 rip(指令指针寄存器)永远指向下一条即将执行的指令。
CPU 执行 callq 时,rip 的变化过程(分三步)
| 时间点 | rip 的值 |
CPU 在做什么 |
|---|---|---|
| ① 取指前 | 400544 |
CPU 根据 rip=400544,从内存读取 callq 指令的机器码。 |
② 执行 callq 内部逻辑时 |
400549(自动计算) |
CPU 在解码 callq 后,先算出下一条指令的地址(400544 + 5 = 400549),并把 rip 暂时更新为 400549。 |
| ③ 压栈并跳转 | 400550(最终结果) |
CPU 把 400549(返回地址)压入栈中,然后将 rip 强制改为 400550(mult2 的入口)。 |
所以,你问“为什么这里的 rip 是 400544” —— 因为在取指阶段,rip 必须指向那条指令自己,不然 CPU 根本不知道要去哪里读代码。
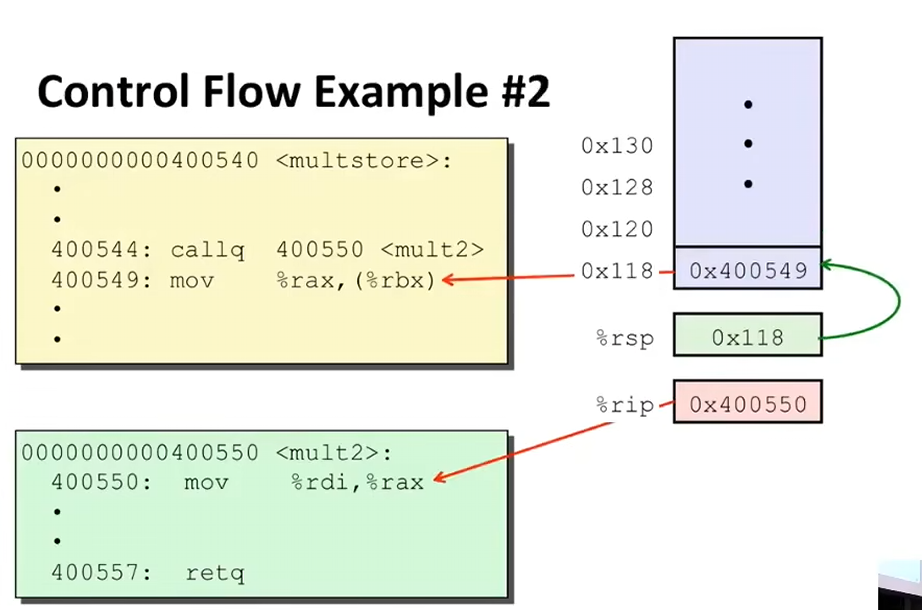
在这里,栈上新增了一个地址。CPU执行callq的时候 算出了下一个指令的地址在 400549。callq的核心功能里面有:将计算出的返回地址压入栈中,随后改变rip(下一条去执行的指令)为400550。
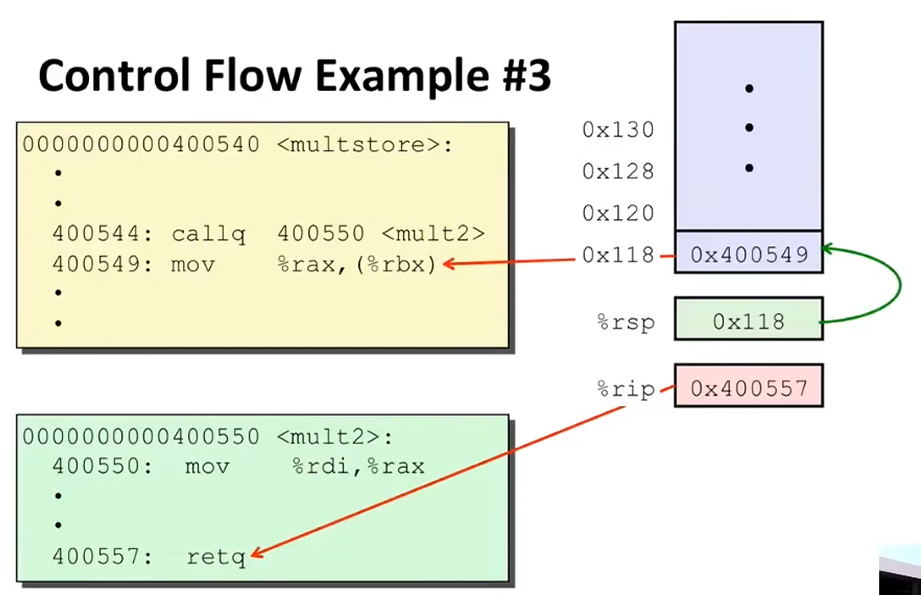
ret的功能是逆转call的效果,他会假设栈顶有一个需要被跳转的地址,它会将栈顶pop出(增加栈指针rsp的地址),随后将rip的地址变为刚才被pop出的栈顶。等mult2执行完了retq,400549会从栈顶被弹出,写回rip,这就是程序下一步执行的地方。
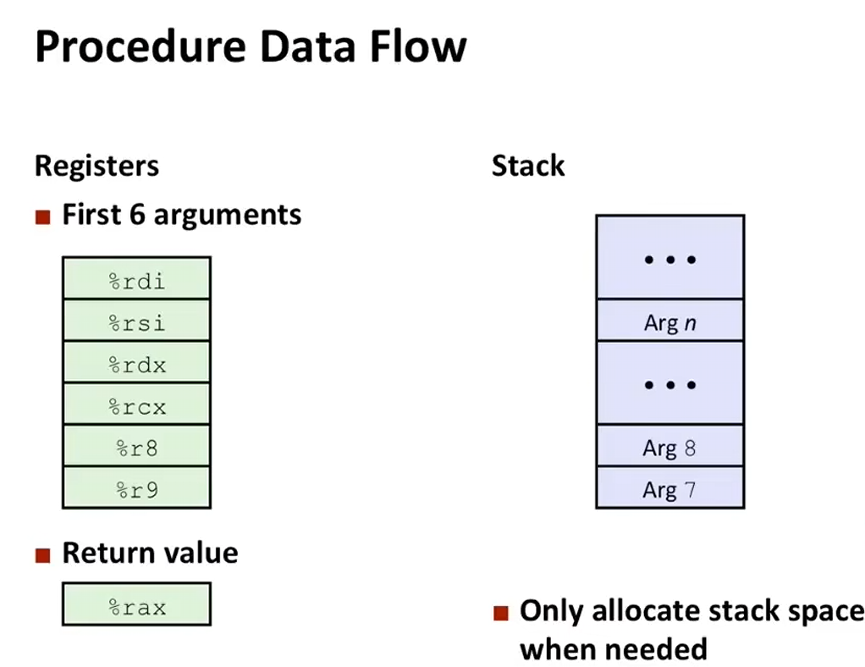
对于数据的传输,在之前我们提到ABI默认规定了前六个参数用dsdc89进行存储(这里实际上只存储整型以及地址,对于浮点型数据实际上是由另一组单独的寄存器进行传递的),超出6个参数的部分参数会被存放在栈上的内存中
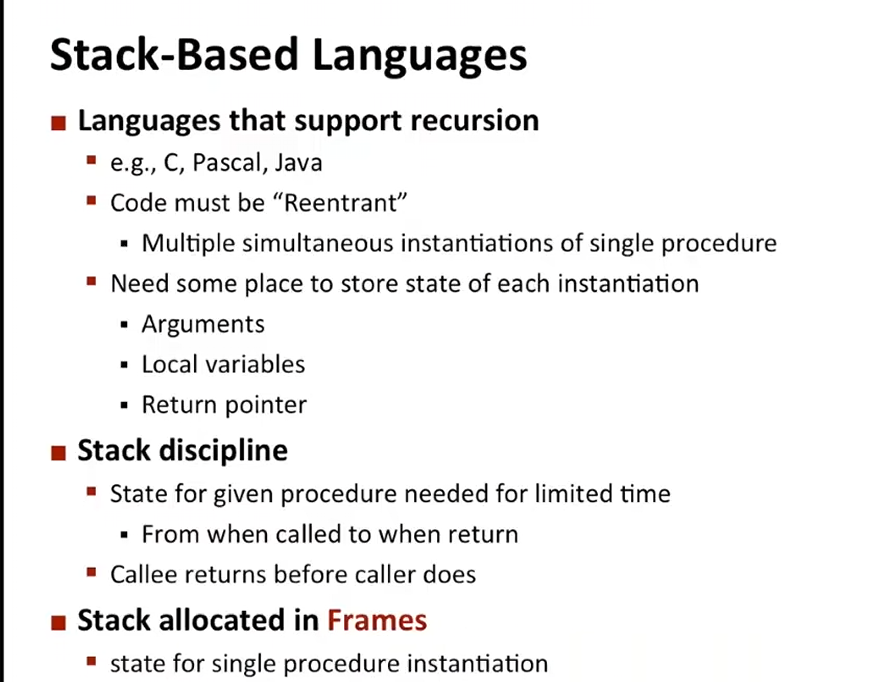
简单来说,它是在回答一个根本问题: “为什么计算机要用‘栈’这种结构来管理函数调用,而不是随便找块内存乱放?”
为了让你把这张理论图和之前我们聊的汇编代码(push 、pop 、call 、ret ) 彻底打通,我把图中的关键信息拆解成“为什么”和“怎么做”:
1. 图中的核心逻辑(为什么是栈?)
- 支持递归(Recursion) :函数可以调用自己。这意味着同一个函数的代码,可能在内存中同时有多个“正在执行但还没返回”的版本(比如递归求阶乘时,
fact(5) 等着fact(4),fact(4) 等着fact(3)……)。 - 代码必须可重入(Reentrant) :代码本身是只读的(在
.text 段)。既然代码只有一份,那么每一层调用独有的数据(参数、局部变量、返回地址)就绝对不能混在一起,必须分开存放。 - 栈的天然属性(LIFO,后进先出) :因为被调用者(Callee)一定比调用者(Caller)先返回(
mult2 一定比multstore 先ret)。这种“后进先出”的嵌套关系,完美匹配栈这种数据结构。
2. 图中的“栈帧(Stack Frame)”是什么?
图中提到的 “Stack allocated in Frames” ,就是你之前在调试器里看到的那些栈内存格子。
-
一个栈帧 = 一次函数调用的专属“工作台” 。
-
当 CPU 执行
call 跳进一个函数时,它会在栈顶(%rsp以下)开辟一块新区域(栈帧)。 -
这块区域里存着:
- 返回指针(Return Pointer) :你之前学的
call 压入的返回地址(0x400549)。 - 参数(Arguments) :如果寄存器不够放了,就压在栈上。
- 局部变量(Local Variables) :比如
long w = 1;,如果w 需要取地址(&w),它就必须存在栈帧里。
- 返回指针(Return Pointer) :你之前学的
3. 结合你之前看的汇编代码(理论 → 硬件)
图中的理论,落实到你的 multstore 汇编里是这样的:
| 图中的概念 | 汇编层面的实现 |
|---|---|
| 调用者(Caller) | multstore(调用方) |
| 被调用者(Callee) | mult2(被调用方) |
| 创建栈帧(分配空间) | 并没有用 subq $8, %rsp 显式分配,而是直接用 push %rbx(压栈 8 字节)隐式开辟了空间。 |
| 销毁栈帧(释放空间) | pop %rbx(弹栈 8 字节)让 %rsp 回退,释放空间。 |
| 返回指针 | callq 压入 0x400549,retq 弹出并跳转。 |
4. 总结一句话
这张图是在告诉你:因为高级语言支持递归和嵌套调用,底层硬件必须提供一种“后进先出”的临时存储机制来隔离每层调用的数据。
这种机制在硬件层面就是 %rsp (栈指针) + 内存,在指令层面就是 push/pop/call/ret,在函数层面就是 “栈帧” 。我们之前花很大功夫看的 %rsp 上下移动,本质上就是在严格执行这张图里的 “Stack Discipline(栈规则)” ——被调者永远在调用者之前返回,所以数据永远像叠盘子一样后进先出。 🍽️
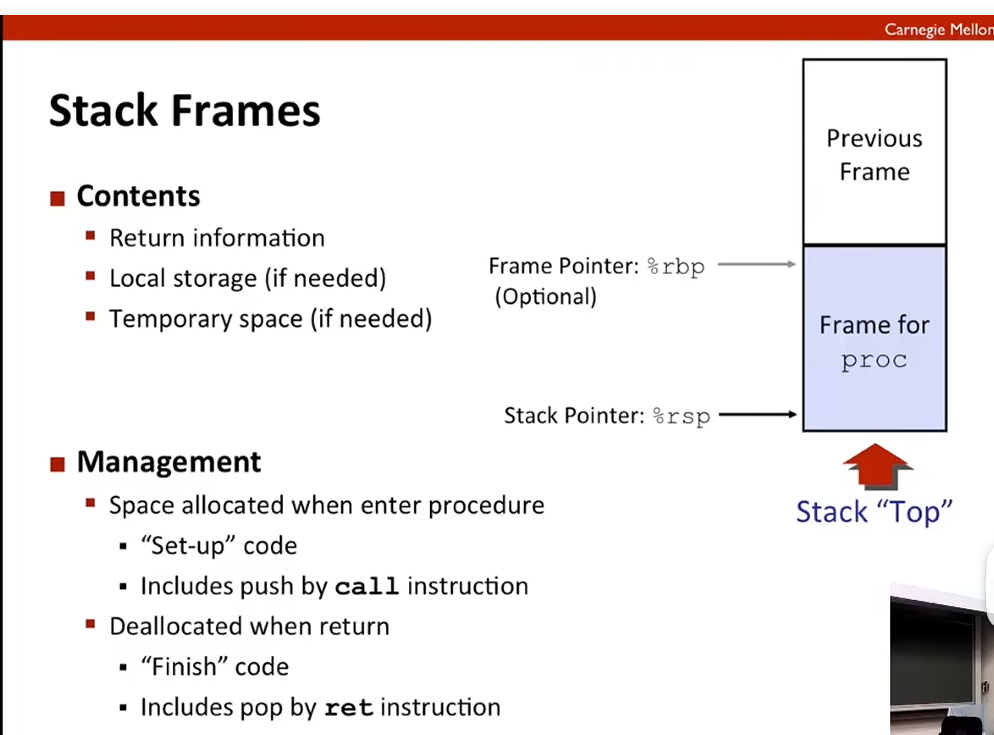
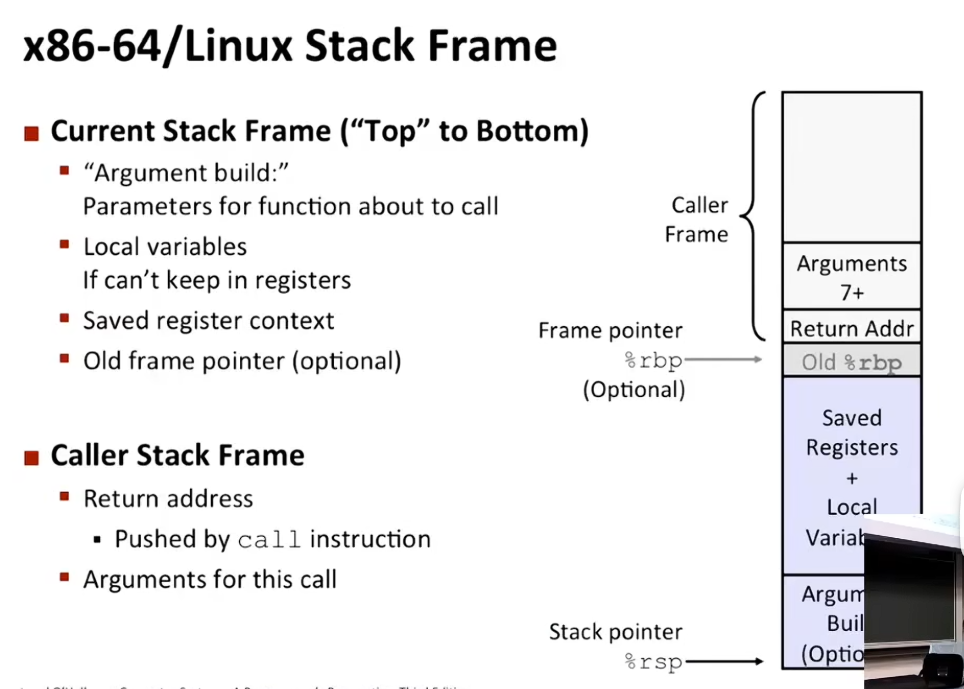
一个栈帧(Stack Frame)占用连续的多个 8 字节格子(比如几十甚至几百字节)。call 指令只负责压入其中的 1 个格子(返回地址) ,栈帧里剩下的空间,是由函数开头的其他指令(比如 subq 或 push)来分配的。
为了让你看清“栈帧”的全貌,我们拿你之前写的 multstore 函数,把它的完整栈帧画出来,你就全明白了:
1. 一个栈帧到底长什么样?(内存布局)
假设 multstore 函数被调用时,栈里的完整情况是这样的(从高地址到低地址,向下增长):
| 内存地址 | 存放的内容 | 大小 | 由谁写入 |
|---|---|---|---|
| 0x130 | (调用者 main 的栈帧数据) |
8 字节 | 调用者 |
| 0x128 | (调用者 main 的栈帧数据) |
8 字节 | 调用者 |
| ⬇️ 栈帧边界 | |||
| 0x120 | 返回地址 (0x400549) |
8 字节 | call 指令压入 |
| 0x118 | 保存的 %rbx(旧值 0x1234) |
8 字节 | push %rbx 压入 |
| 0x110 | (局部变量 t 的空间,如果需要) |
8 字节 | subq $8, %rsp 预留 |
| 0x108 | (临时空间,如果函数调用需要传参) | 8 字节 | subq 预留 |
| 0x100 | … | … | … |
| ⬆️ 当前栈顶 | %rsp 最终指向这里 |
2. 拆解:call 和其他“栈帧内容”的分工
① 返回信息(Return Information)
- 谁负责:
call指令。 - 占多大:8 字节(只占一个格子)。
- 存的啥:下一条指令的地址(
0x400549)。
② 保存的寄存器(比如 %rbx)
- 谁负责:函数开头的
push %rbx。 - 占多大:8 字节(又占一个新格子)。
- 为啥要占:因为
%rbx 在函数内部要被覆盖(存dest地址),必须先把它原来的值存到栈上保护起来。
③ 局部变量和临时空间(Local & Temporary)
- 谁负责:编译器生成的
subq $24, %rsp之类的指令。 - 占多大:任意大小(比如 24 字节 = 3 个格子)。
- 例子:如果你的 C 代码里有
long w = 1; 并且你对w 取了地址(&w),编译器就会在栈上开辟 8 字节给它。
3. 回到你问的“一个地址 8Bytes 哪里容得下其他东西”
关键纠正:你理解的“一个地址”是指一个内存格子(8字节)。但 “栈帧”不是指一个格子,而是从栈顶 %rsp 到栈底(返回地址)之间的这一整片连续区域。
call 只负责在这个区域里放了第一块砖(返回地址) 。函数开头的 push 和 subq 负责继续往上(低地址)砌墙(放寄存器和局部变量) 。
4. 实际汇编指令是如何一步步搭起这个栈帧的?
以你的 multstore 为例,进入函数后的执行顺序:
- 执行
call 前:%rsp = 0x128(调用者的栈顶)。 - 执行
call:压入返回地址,%rsp = 0x120。此时栈帧只有 1 个格子。 - 执行
push %rbx:压入 8 字节,%rsp = 0x118。此时栈帧扩展到 2 个格子。 - (假设需要局部变量)执行
subq $16, %rsp:直接把%rsp 向下移动 16 字节(预留 2 个空格),%rsp = 0x108。此时栈帧扩展到 4 个格子。 - 函数返回前,依次执行
addq $16, %rsp、pop %rbx、ret,把栈帧一层层拆掉。
总结一句话
call 只压入 8 字节的返回地址,这只是栈帧的“冰山一角”。
栈帧的总大小 = 返回地址(8B) + 保存的寄存器(n8B) + 局部变量(m8B) + 临时参数(k*8B) 。
所以完全容得下“返回信息、局部存储、临时空间”这三样东西,因为它们只是共用一块连续的、由 %rsp 管理的大内存区域。✅
#include<stdio.h>

int add(int a, int b);

int main(){
    int a;
    int b;
    scanf("%d %d",&a,&b);
    printf("%d",add(a,b));
    return 0;
}

int add(int a, int b){
    return a+b;
}
这一段C语言程序,执行到add的时候大概的栈结构如下:
| 内存地址 (示例) | 存放的内容 | 大小 | 属于谁的栈帧 | 由谁写入 |
|---|---|---|---|---|
| 高地址 | ||||
0x...100 |
(调用者 main 的返回地址,回到 C 运行时启动代码) |
8 字节 | main |
call main 压入 |
0x...0F8 |
main 保存的旧 %rbp 值 |
8 字节 | main |
push %rbp (main开头) |
0x...0F4 |
main 的局部变量 b(值由 scanf 写入) |
4 字节 | main |
mov 指令预留 |
0x...0F0 |
main 的局部变量 a(值由 scanf 写入) |
4 字节 | main |
mov 指令预留 |
0x...0EC |
(对齐填充,因为栈要 16 字节对齐) | 4 字节 | main |
编译器预留 |
⬇️ 调用 add 的边界 |
||||
0x...0E8 |
add 的返回地址(即 printf 调用处的下一条指令) |
8 字节 | add |
call add 压入 |
0x...0E0 |
add 保存的旧 %rbp(即 main 的 %rbp 值 0x...0F8) |
8 字节 | add |
push %rbp (add开头) %rbp (add) 指向这里 %rsp (add) 也指向这里 |
0x...0DC |
add 参数 a 的副本(从 %edi 复制过来) |
4 字节 | add |
mov %edi, -4(%rbp) |
0x...0D8 |
add 参数 b 的副本(从 %esi 复制过来) |
4 字节 | add |
mov %esi, -8(%rbp) |
| 低地址 | … (此处无额外局部变量) |
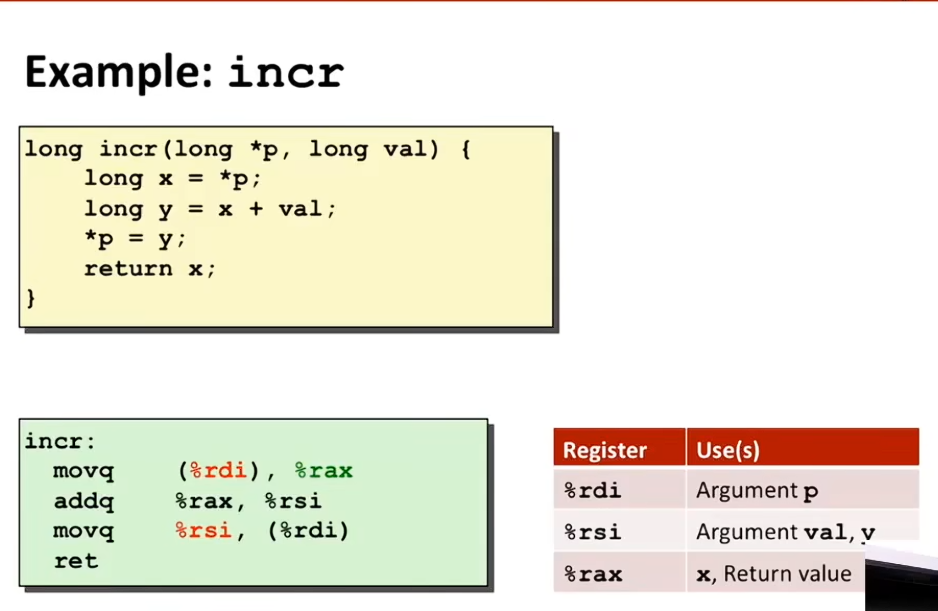
汇编干了这些事情:
- 把x(rdi里面存储的是一个内存地址,所以加()表示读出这个内存地址里面是什么)取出来 放倒rax,现在rax里面放的是一个数值
- 将 rsi = rsi + rax 也就是rsi= x+y
- 再将 rsi刚才的计算结果 写到rdi存储的内存地址去
- 返回rax寄存器的值 也就是最早 rdi里面存储的对应内存地址里面的值x
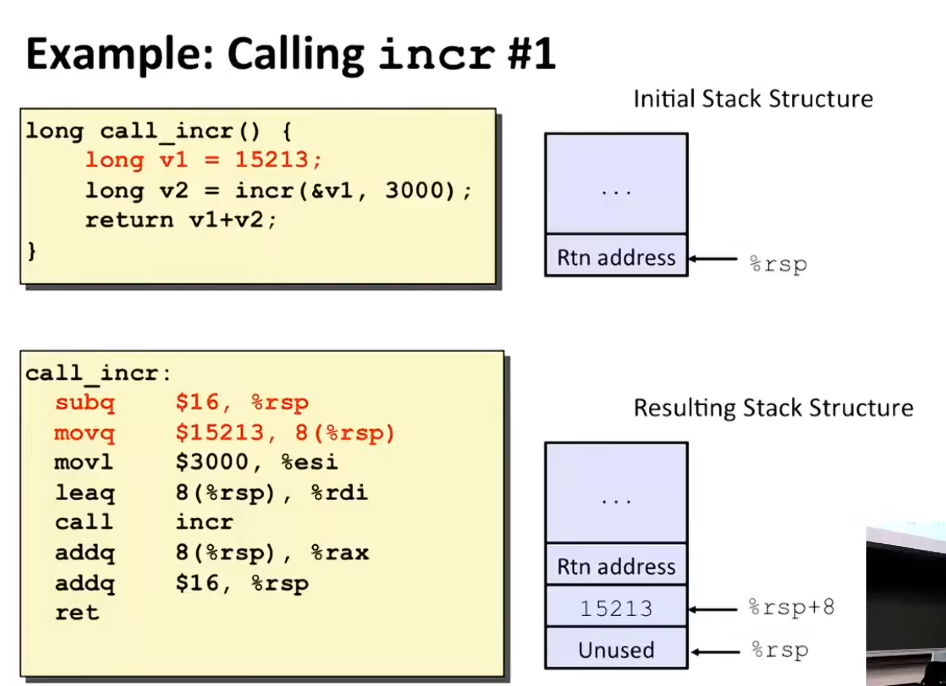
call_incr:
    subq   $16, %rsp          # 1. 栈指针向下移动 16 字节(分配栈帧空间)
    movq   $15213, 8(%rsp)    # 2. long v1 = 15213; 把 15213 存入 rsp+8 的位置
    movl   $3000, %esi        # 3. 第二个参数 val=3000 存入 %esi(注意用 32 位 movl,高位自动清零)
    leaq   8(%rsp), %rdi      # 4. 取 v1 的地址(&v1),存入 %rdi(第一个参数)
    call   incr               # 5. 调用 incr(&v1, 3000)
                               #    (call 会压入返回地址,跳转执行 incr)
    addq   8(%rsp), %rax      # 6. 返回值 %rax(旧值 15213) += 现在内存里的 v1(已变成 18213)
    addq   $16, %rsp          # 7. 回收栈帧空间(%rsp 加回 16)
    ret                        # 8. 返回,此时 %rax = 15213 + 18213 = 33426
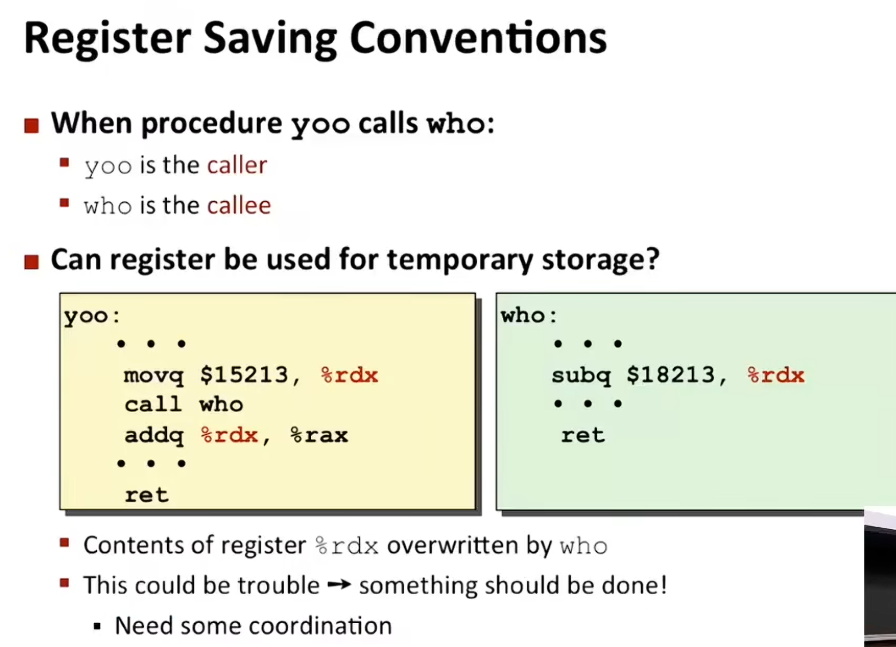
之前提过 寄存器分类 调用者保存寄存器和被调用者保存寄存器,有明确的区分。
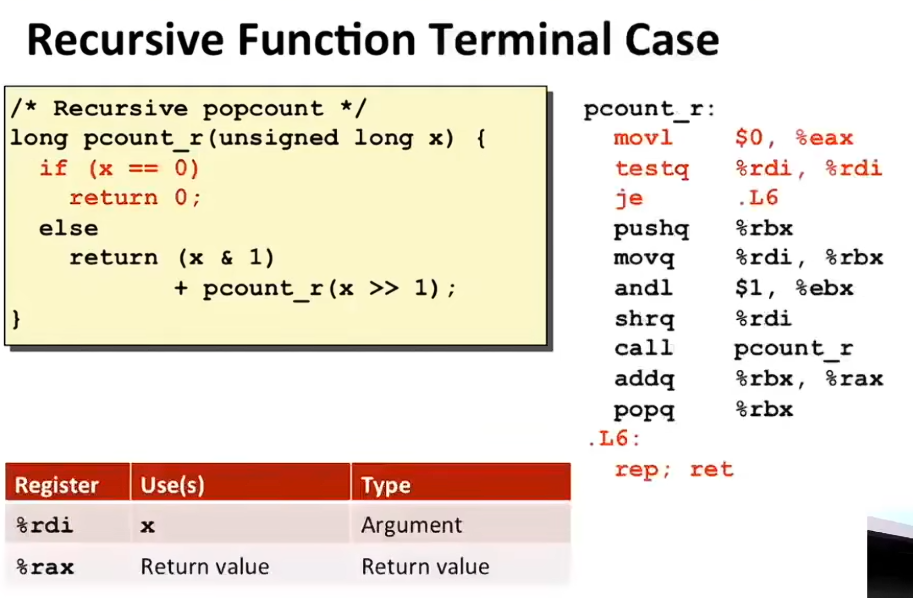
- 先假设输入数是0,并且重置rax为0(用eax清空高32位)
- 判断rdi(第一输入参数)是否为0,如果是就转跳L6
- 寄存器rbx入栈(被调用者保存),第一输入参数复制到rbx中,且最低位和1做与运算,随后逻辑右移(shrq)
- 调用自己(递归),又是新的栈创建过程
- 当最后一次递归函数主体结束之后,就开始利用addq 将每一轮递归运算出的 %rbx里面的值进行相加,随后把这一小块备份出栈,把栈上保存的上一层调用者的旧
%rbx 值弹出,恢复给上一层使用。