L06 Machine-Level Programming II: Control
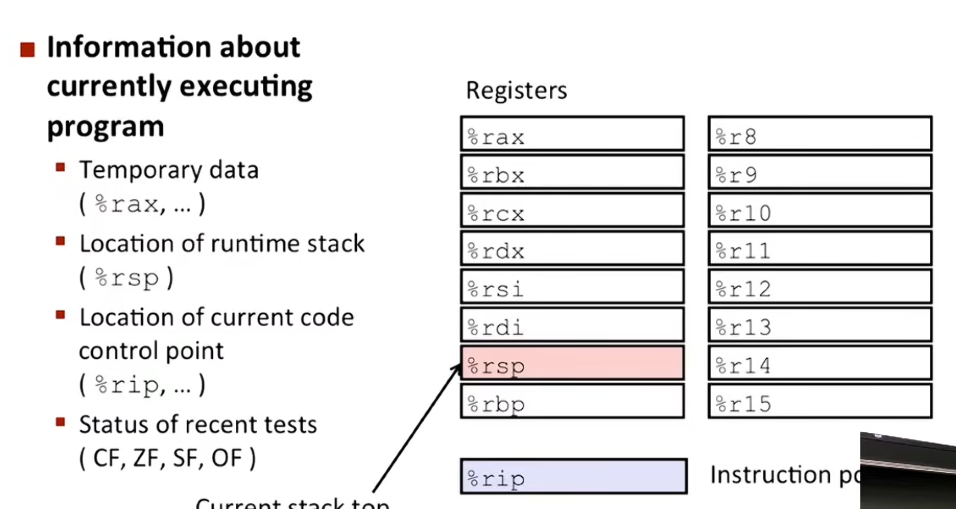
CF : Carry Flag (对于相加无符号数,进位)
SF : Sign Flag (对于有符号数,如果是负数则标记为1)
ZF : Zero Flag (计算结果确定是0)
OF :Overflow Flag(对于有符号数的溢出标记)
cmp Src2,Src1 对两个数做减法,不对任何数值做出改变,然后给出上述四个条件码
可以用 test Src1, Src2来确定 正负零,eg test %rax %rax
q结尾的指令表示对64位的数据进行操作,也就是quadward(word是两个字节 quad是四倍词根,所以这是八字节)
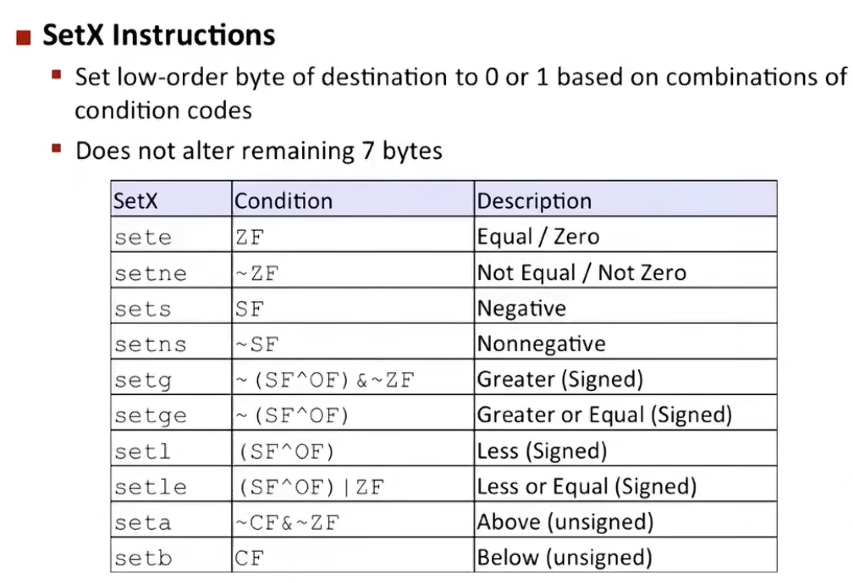
这是 x86/x86-64 汇编语言中的条件字节设置指令族(SETX) 。
简单来说,它的核心功能是:根据当前 CPU 标志寄存器(EFLAGS/RFLAGS)中条件码(如 ZF、SF、OF、CF)的组合,将目标操作数(寄存器或内存单元)的最低 1 个字节设置为 0 或 1,而其余 7 个字节(若目标是 64 位寄存器)保持原样不变。其中 “低位”(Least Significant Byte, LSB)永远位于寄存器的最右边。
为了帮你快速理解,这张表实际上是在教汇编编译器如何把“比较结果”转成“布尔值(0/1)”。以下是关键解读:
1. 指令分类(按比较类型)
- 判等/判零:
sete(相等)和setne(不等)。只看零标志位 ZF。 - 判正负:
sets(负数)和setns(非负)。只看符号标志位 SF。 - 有符号数比较(
g/l 系列):用于int 类型。因为要考虑正负溢出(OF),所以条件最复杂(如setg 要求SF == OF 且ZF == 0)。 - 无符号数比较(
a/b 系列):用于unsigned int 类型。仅看进位标志位 CF 和零标志 ZF(如seta 要求CF=0 且ZF=0,表示“高于”)。
2. 特别注意(有符号 vs 无符号)
表格中 setg(大于)和 seta(高于)在中文里都像“大于”,但本质完全不同:
setg 针对有符号数(如-1 > -2),必须处理溢出(SF^OF)。seta 针对无符号数(如255 > 1),看进位(CF)。
3. 典型使用场景
它几乎总是紧跟在 CMP(比较)或 TEST(测试)指令之后。例如 C 语言代码 return (a > b); 编译后,通常会生成:
cmp  eax, ebx   ; 比较 a 和 b
setg al         ; 如果 a > b (有符号),al 置 1,否则置 0
movzx eax, al   ; 将 al 扩展为完整的 32 位返回值
cmp eax, ebx |
计算 eax - ebx。结果不进 eax,但 RFLAGS 中的 ZF/SF/OF 被更新。 |
|---|---|
setg al |
读取当前 RFLAGS。若符合 (ZF=0 且 SF=OF)(有符号大于),则 al = 1;否则 al = 0。此时 al 只有 0 或 1,但 eax 的高 3 个字节保持原样(可能有旧数据)。 |
movzx eax, al |
零扩展:把 al 的 0 或 1 复制到 eax 的 32 位中,高位全部补 0。这一步是为了清除 EAX 高位的残留垃圾,确保整个 EAX 寄存器的值就是 0 或 1(标准的 C 布尔返回规范)。 |
重要限制:目标操作数必须是 8 位(如 AL、BL、CL 或 BYTE PTR [内存地址]),不能直接写 setg eax,因为这条指令只改低字节。
对于x86-64的16个寄存器,我们可以直接将任意一个寄存器的最低为设置为0或1,而不影响该寄存器中的其他七个字节
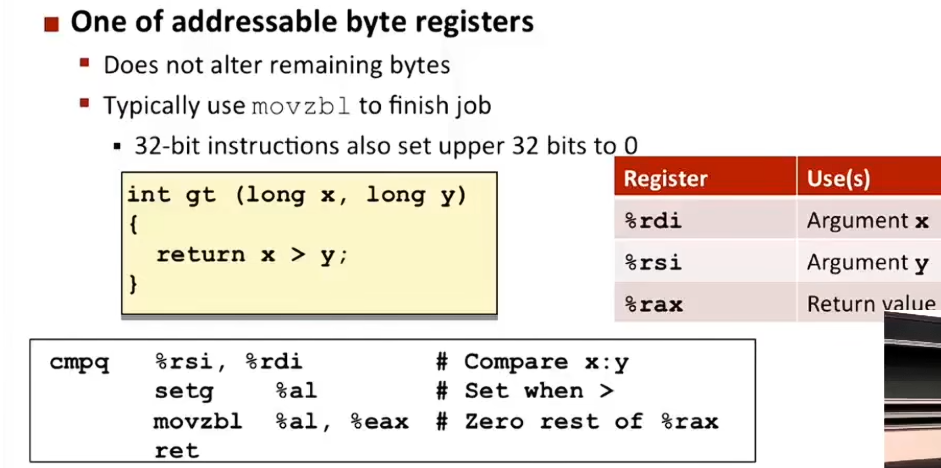
cmq首先根据 %rdi %rsi (第一参数在rdi 第二在rsi)获取四个状态码中的一个,运算结果被存储到了“标志寄存器”,也就是RFLAGS/EFLAGS 中。其中:
- 比如第 0 位(bit 0)专门做进位标志(CF) 。
- 第 6 位(bit 6)专门做零标志(ZF) 。
- 第 7 位(bit 7)专门做符号标志(SF) 。
- 第 11 位(bit 11)专门做溢出标志(OF) 。
随后 setg ,根据RFLAGS 里面的内容。设置了寄存器 %rax 的最低位置(%al,最低位1字节)为0或1
那么现在 %rax 一共八字节,其中最低位字节是刚才的状态码。现在希望其他七位都变成0。因此这里使用了movzbl(move zero extend byte to long),以及一个x86-64的特性:
-
movzbl(Move Zero Extend Byte to Long)指令,把 1 字节的%al 复制到 4 字节的%eax 中,复制时高位全部补 0。这样,%eax 的 4 个字节(即%rax的低 32 位)瞬间变干净了。因此,我们在这里使用了 movzbl %al %eax
-
在 x86-64 架构中,有一条铁律——任何写入 32 位寄存器(如
%eax **)的操作,CPU 硬件都会自动将对应的 64 位寄存器(** %rax )的高 32 位清零。
所以这一条指令执行完,%rax 的 8 个字节全部归零(除了最低位保留了 0 或 1)。
最后 结果被return出来 返回状态码。
对于rax 主要用于返回 更准确地说,x86-64 里 %rax 这一组寄存器是这样分的:
| 名称 | 位数 | 在%rax中的位置 |
|---|---|---|
%rax |
64 位 | 全部 64 位 |
%eax |
32 位 | 低 32 位 |
%ax |
16 位 | 低 16 位 |
%al |
8 位 | 最低 8 位,即位 0~7 |
%ah |
8 位 | 位 8~15,即%ax的高 8 位 |
对于条件控制,主要使用Jumping:
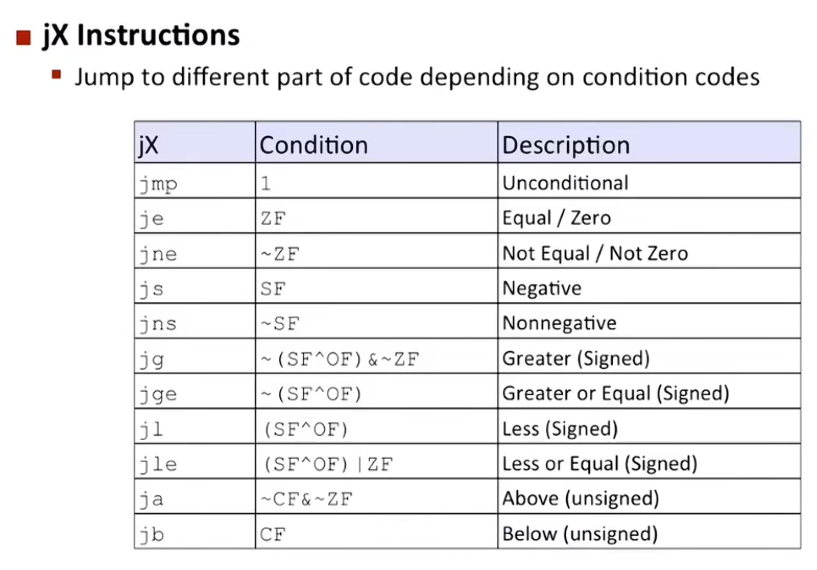
这张表是 x86 汇编里条件跳转(Conditional Jump) 的“九阴真经”,非常核心。我来教你一套三步法,让你一眼看穿它的本质。
第一步:先看懂“条件(Condition)”那一列的数学符号
这一列是用布尔代数描述 CPU 内部 RFLAGS 标志位的组合逻辑。先记住几个符号含义:
~ 表示 取反(Not,即该标志位为 0)& 表示 与(And,必须同时满足)| 表示 或(Or,满足其一即可)^ 表示 异或(Xor,两者不同则为 1)
第二步:分三组来理解,瞬间条理清晰
这张表本质上把跳转指令分成了三大门派:
| 门派 | 指令 | 核心逻辑 | 使用场景 |
|---|---|---|---|
| 1. 单标志位派 | je/jne、js/jns |
只看 1 个 标志位(ZF 或 SF) | 判断是否为 0、是否相等、正负 |
| 2. 有符号数派 | jg/jge/jl/jle |
关注 SF(符号位) 和 OF(溢出位) 的关系 | 处理 int 类型的大小比较(-1 < 2) |
| 3. 无符号数派 | ja/jb(及衍生) |
关注 CF(进位/借位位) | 处理 unsigned int 类型的大小比较(0xFFFFFFFF > 2) |
第三步:逐条拆解核心难点(有符号 jg 和无符号 ja 的区别)
这是新手最容易炸裂的地方,我们对比着看:
-
jg (有符号大于) :条件为~(SF^OF) & ~ZF
意思是:ZF = 0(不相等) 且 SF 和 OF 相同。
底层逻辑:cmp a, b 做a - b。如果没溢出(SF=OF),结果的 SF 就是真实正负;如果溢出(SF≠OF),真实正负与 SF 相反。SF^OF 就是用来修正这个“真实符号”的。~(SF^OF) 表示“真实结果不是负数”,即a >= b。再配合~ZF(排除等于),最终就是 a > b。 -
ja (无符号大于) :条件为~CF & ~ZF
意思是:ZF = 0(不相等) 且 CF = 0(没有借位) 。
底层逻辑:cmp a, b 做a - b。如果a < b,减法会产生借位(Borrow) ,CF 置 1。所以~CF 表示a >= b,再配合~ZF 排除等于,最终就是 a > b(无符号视角)。
实战演练(帮你融会贯通)
假设你写了 cmp eax, ebx:
-
如果
eax = 5, ebx = 3(有符号/无符号都是 5>3):- 计算
5-3=2,**ZF=0, SF=0, OF=0, CF=0**。 jg 成立(~(0^0)=1 且~0=1),ja 也成立(~0 & ~0=1)。
- 计算
-
如果
eax = -1 (0xFFFFFFFF), ebx = 2(重点):- 计算
-1 - 2 = -3,**ZF=0, SF=1, OF=0, CF=0**(无符号视角下没借位)。 -
jg:~(1^0)=~(1)=0 → 不跳转(因为 -1 确实 不大于 2)。 -
ja:~CF(1) & ~ZF(1) = 1 → 跳转! (因为无符号数 0xFFFFFFFF 确实大于 2)。
- 计算
总结:这张表怎么看?
看三列联动:
指令名(我要干什么) → 条件列(CPU 内部怎么算) → 描述列(对应的高级语言写法)。
你写代码时,心里只记右边“描述列” (Equal、Greater、Below),左边复杂的 SF^OF 交给 CPU 硬件去算。这张表的存在,是为了让你在调试器里看 RFLAGS时,能反推出 CPU 为什么会跳转。比如你看到 SF=1, OF=0,你就知道 CPU 刚执行了 jl(小于)的跳转,因为 SF^OF = 1。
absdiff:
	cmpq %rsi, %rdi #x:y  %rdi是第一参数 %rsi是第二参数 但是右边减去左边,就是x-y
	jle .L4 #有符号转跳 小于或等于的时候触发
	movq %rdi, %rax #永远是 指令 source dest 所以是把rdi复制到rax
	subq %rsi, %rax #rax = rax - rsi 也就是 rdi-rsi x-y 目标 = 目标-来源
	ret	#返回值
.L4:	#我们把这种类型叫做标签
	movq %rsi, %rax
	subq %rdi, %rax
	ret
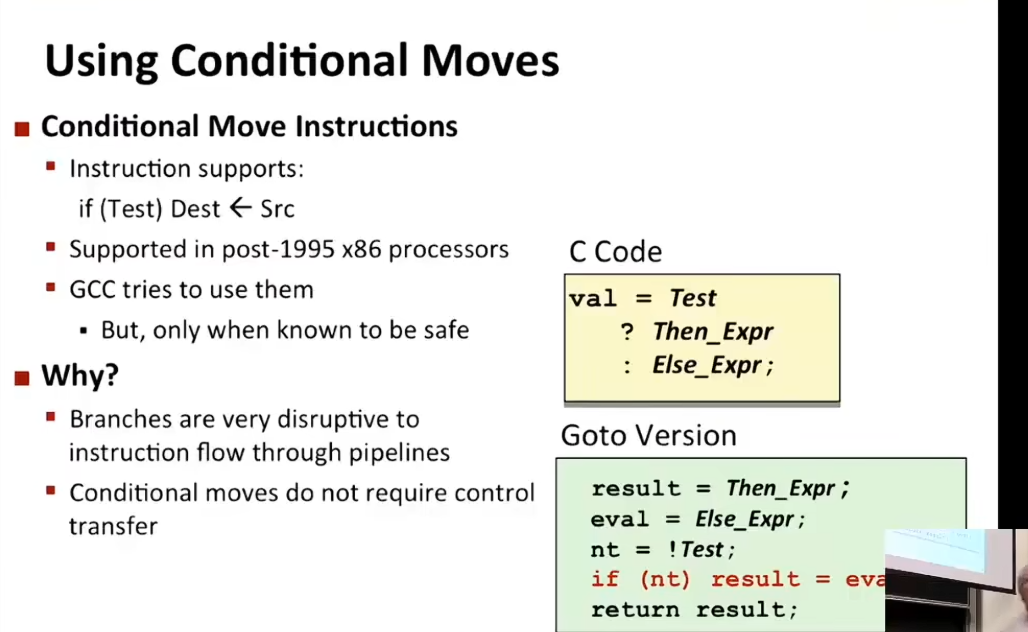
条件移动指令(cmov)
看图中的 C 代码:val = Test ? Then_Expr : Else_Expr;
再看 Goto 版本(这是模拟 cmov 的汇编思想):
result = Then_Expr;(先假设条件成立,把“真分支”的值存起来)eval = Else_Expr;(不管三七二十一,先把“假分支”的值也算出来)nt = !Test;(判断条件是否“不成立”)if (nt) result = eval;(如果条件确实不成立,就把刚才算好的假分支值覆盖掉 result)
翻译成硬件指令:这里的第 4 步 if (nt) result = eval,正好对应一条 cmov 指令!
即在 AT&T 下写:cmovne %rsi, %rax(如果不等于,就把 eval 的值给 result)。
因此,刚才的计算绝对值的代码,如果使用了条件移动指令进行优化,会长这样:
absdiff:
	movq %rdi, %rax #把x复制到rax
	subq %rsi, %rax #rax = rax - rsi 当前rax的值是x-y
	movq %rsi, %rdx #把y复制到rdx
	subq %rdi, %rdx #rdx = rdx - rdi 当前rdx是y-x
	cmpq %rsi,%rdi #rdi-rsi (也即是x-y)产生了一个状态码寄存到RFALG
	cmovle %rdx, %rax  #根据上一步的运算结果决定返回的是哪一个值
	ret
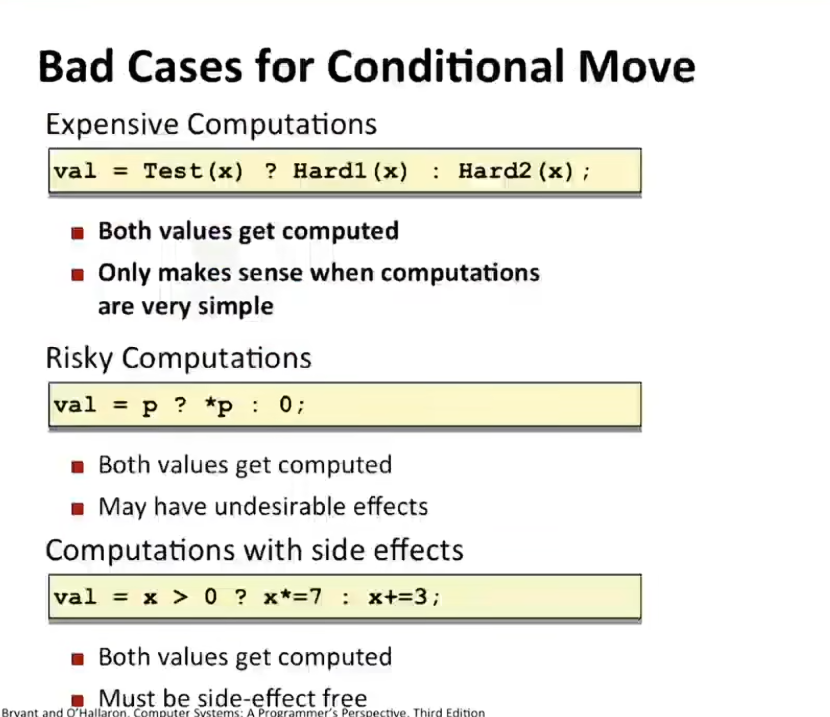
这里解释了,在哪些情况下不能用条件移动指令:
1. 昂贵的计算(Expensive Computations)
场景:
val = Test(x) ? Hard1(x) : Hard2(x);
- 为什么会炸:如果
Hard1 和Hard2 是复杂的函数(比如涉及几百次循环、除法div 或浮点运算),用cmov 意味着 CPU 必须把这两套复杂的逻辑全都跑完,最后才扔掉其中一个结果。这会导致计算资源翻倍,不仅没提速,反而比先判断再跳转(只算一边)慢得多。 - 何时能用:只在
Hard1 和Hard2 都是极其简单的加减法(像你的x-y 和y-x)时,cmov才划算。
2. 危险的计算(Risky Computations)
场景:
val = p ? *p : 0;(判断指针是否为空,不为空则取值)
- 为什么会炸:
cmov 会把*p(解引用指针,即读内存)和0 同时执行。如果p 真的是NULL(空指针),CPU 在执行*p 的一瞬间就会触发缺页错误(Segmentation Fault) ,程序直接崩溃。 - 救星
jmp:用jmp 的话,CPU 先判断p,只有确认p 不是NULL 时,才去执行*p读内存,绝对安全。
3. 带有副作用的计算(Side Effects)
场景:
val = x > 0 ? x*=7 : x+=3;(注意,这里修改了x本身)
- 为什么会炸:
cmov 会同时修改x(先乘以 7,又加上 3)。无论条件成不成立,x 都被蹂躏了两次,最终的x 值完全是错的(违反 C 语言的if-else语义)。 - 救星
jmp:只有判断为真,才执行x*=7;判断为假,才执行x+=3,x绝对只被修改一次。
C语言中有三种循环 while for do-while。当然也可以用goto来实现
long pcount_goto (unsigned long x){
	long result = 0;
	loop:
		result += x & 0x1;
		x>>=1;
		if (x) goto loop;
	return result;
}
那么在汇编中,这个程序会变成:
loop:
    movq %rdi, %rax   # 取 x
    andq $1, %rax     # 取最低位
    addq %rax, %rsi   # 累加到 result
    shrq $1, %rdi     # 右移(这里就是 x >>= 1 的汇编!)
    testq %rdi, %rdi  # 判断 x 是否为 0
    jne loop          # 不为 0 则跳回
实际上 对于while 循环 编译器有两种转换方式(-Og)
第一种:
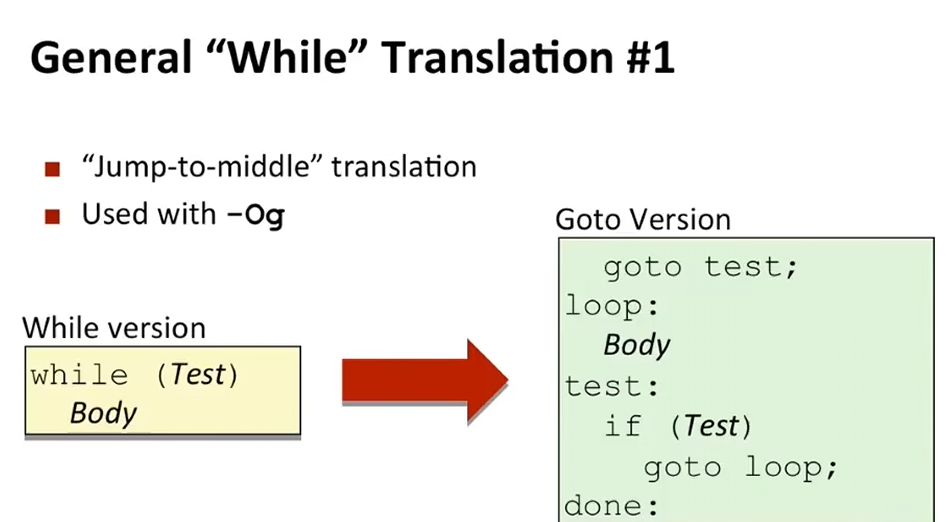
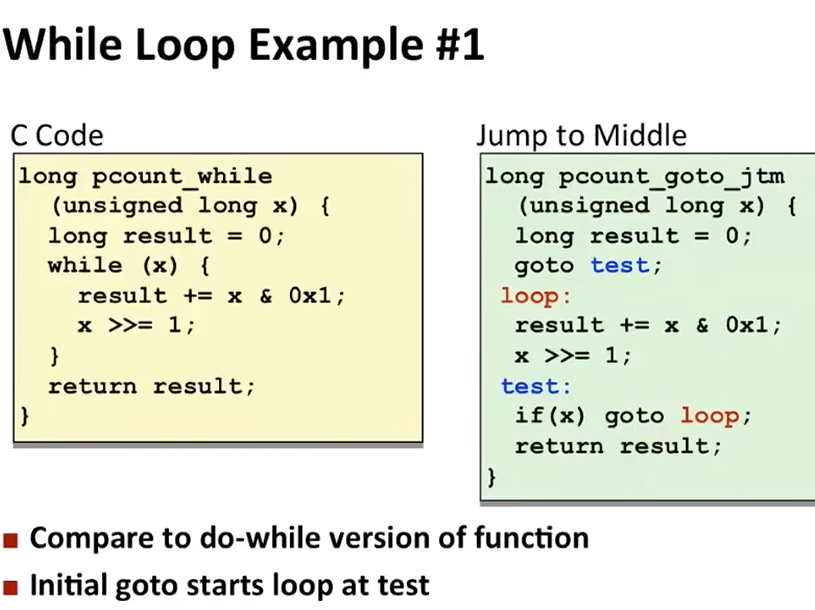
long pcount_goto_jtm(unsigned long x) {
    long result = 0;
    goto test;          // ① 第一步:无条件跳转,跳过循环体
loop:
    result += x & 0x1;  // ③ 循环体执行
    x >>= 1;            // ③ 循环体执行
test:
    if(x) goto loop;    // ② 判断条件:如果 x 为真,跳回 loop;否则退出
    return result;
}
执行顺序是:① 跳转到 test → ② 判断 if(x) → 如果为真,③ 执行 loop → 执行完 loop 后,代码自然向下执行到 test 标签(回到 ②)→ 再次判断……
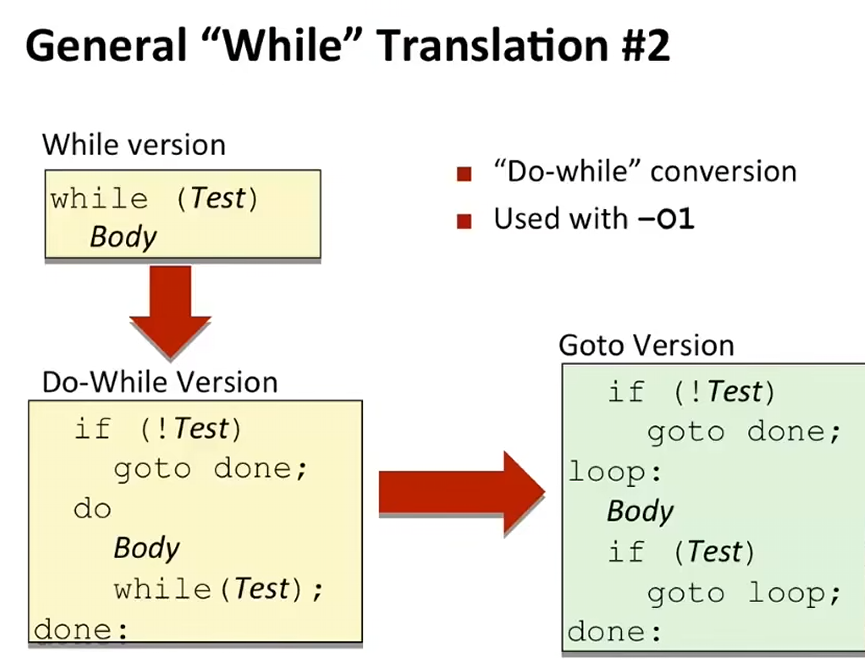
将while转换为do-while 但先进行条件判断
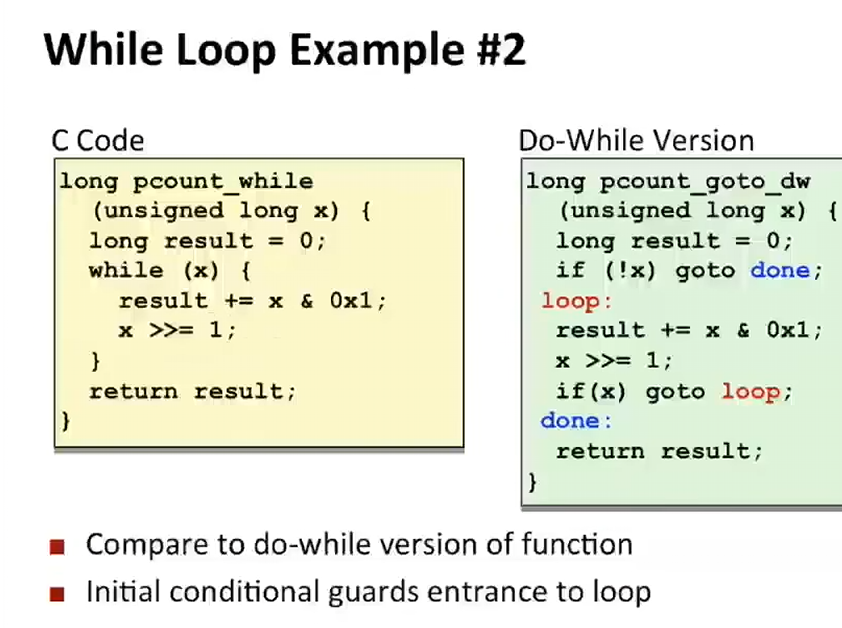
if (!x) goto done;  // ① 入口:先判断是否要跳过整个循环(守卫)
loop:
    result += x & 0x1;
    x >>= 1;
    if(x) goto loop; // ② 底部判断,拉回执行流
done:
    return result;
- 入口方式:用条件分支
if (!x) goto done显式拦截“执行 0 次”的情况。 - 循环驱动:同样靠底部的
if(x) goto loop。 - 特点:这种模式等价于
if (x) do { ... } while (x);,即先加一层防护网,确保进入循环时x肯定非零
| 对比维度 | 第一种(跳转到中间) | 第二种(守卫 + do-while) |
|---|---|---|
| 额外跳转指令 | 循环开始前有 1 次 无条件跳转(goto test) |
循环开始前有 1 次 条件判断(if),但没有无条件跳转 |
| 代码布局(入口) | 入口代码在顶部,但第一件事是跳走 | 入口代码直接在顶部做有效性检查 |
| 底层执行效率(未优化时) | 每次进入循环多执行一条 goto 指令,流水线可能受轻微影响 |
用分支判断代替了 goto,在 CPU 分支预测下通常更友好(尤其是 x 大概率非零时) |
For循环
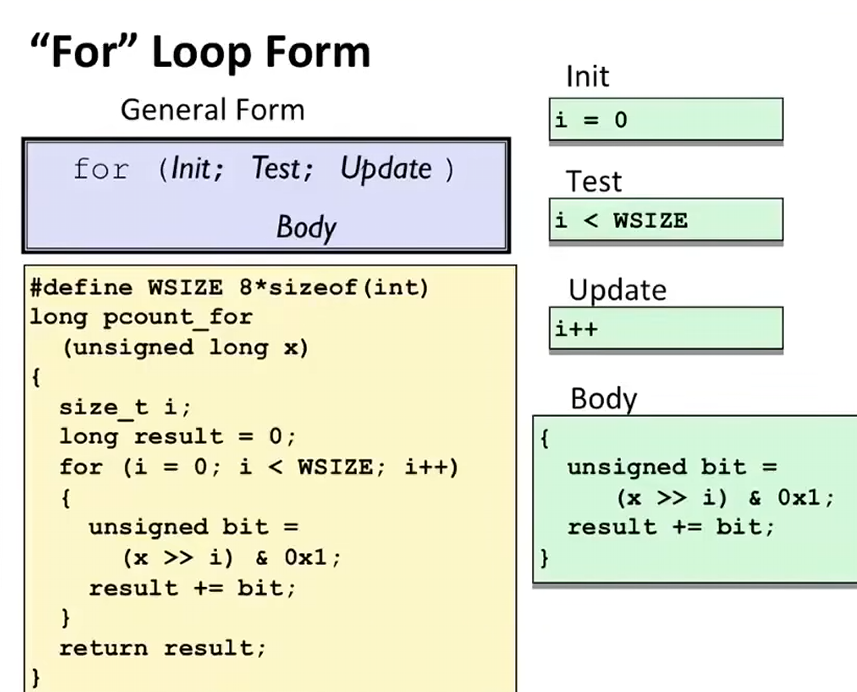
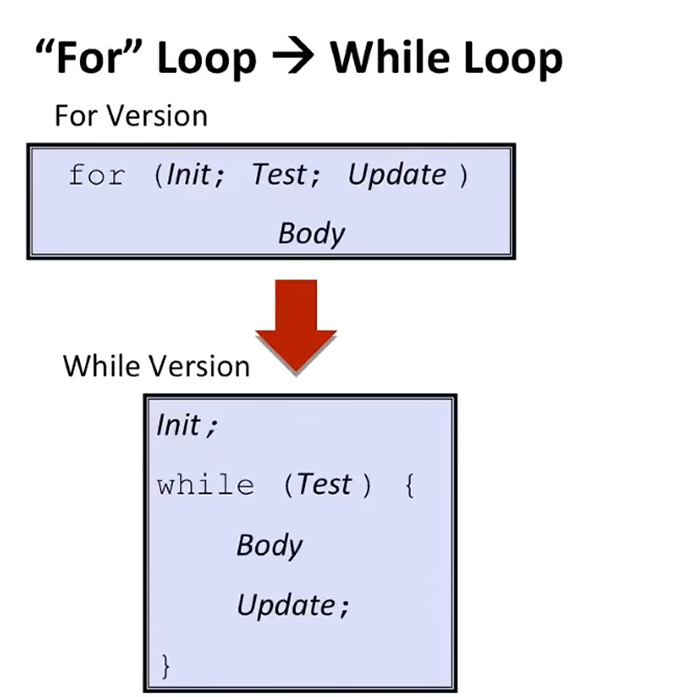
switch语句:
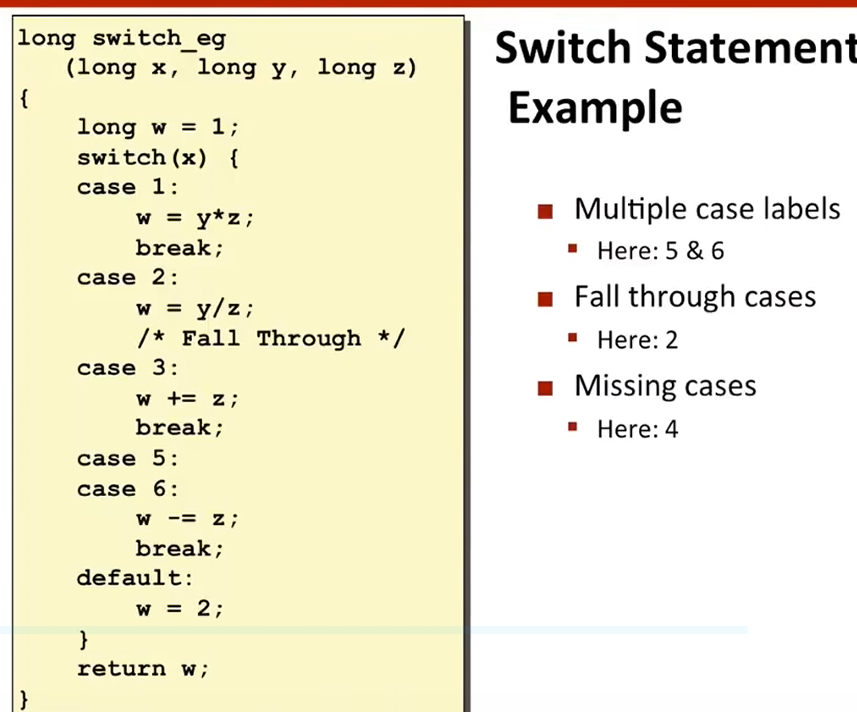
例如有下列程序
long switch_eg(long x, long y, long z){
	long w = 1;
	switch(x){
	...
	}
	return w;
}
在64位系统中参数存储遵循 dsdc89 rdi rsi rdx rcx r8 r9,因此汇编层面就是
switch_eg:
	movq %rdx, %rcx #把 rdx 复制到 rcx 也就是备份z
	cmpq $6, %rdi #运算 %rdi - 6 就是 x-6
	ja .L8	#根据刚才RFLAG的运算结果,直接判断是否要转跳到L8
			#即 x是否无符号大于6。如果是,跳到默认情况(default)。
	jmp *.L4(,%rdi,8)
			#这是计算地址并跳转,那么在这里 L4就是转跳表的基地址,rdi是索引,以8为步长进行跳转
jmp *.L4(,%rdi,8) 到底怎么跳?
这是 AT&T 语法中最经典的跳转表寻址写法,拆开来看:
| 组成部分 | 含义 |
|---|---|
jmp * |
间接跳转(* 表示跳转到内存里存放的地址去) |
.L4 |
跳转表的基地址(在数据段中定义的一个标签) |
,%rdi |
索引(就是原始的 x,注意 cmp 并没有修改 %rdi) |
,8 |
比例因子(因为 64 位系统地址占 8 个字节) |
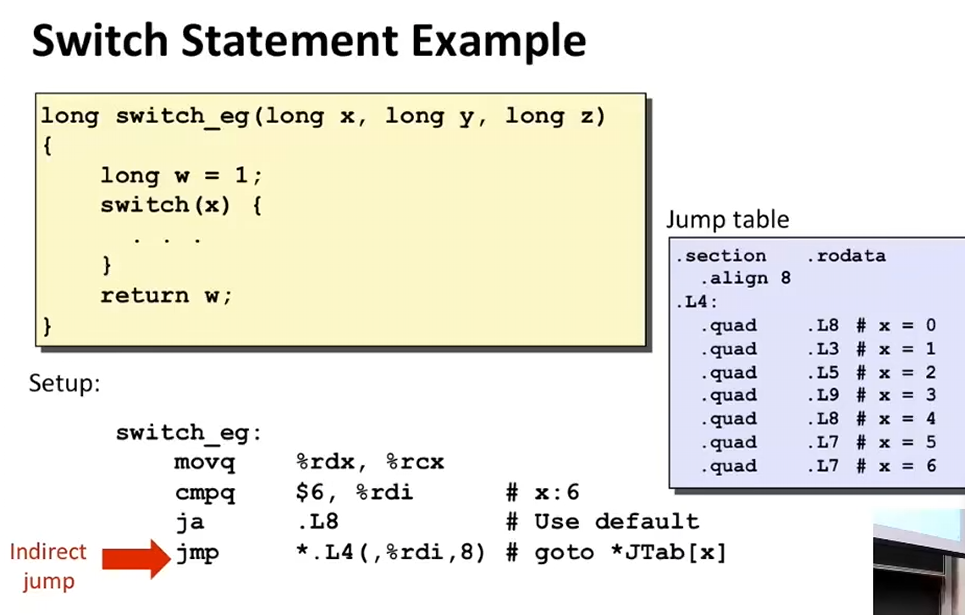
假设 .L4 标签处存放了 7 个地址(对应 case 0 到 case 6),内存布局如下(地址从低到高):
| 内存地址(偏移) | 存放的内容(目标代码地址) |
|---|---|
.L4 + 0 |
case_0 的地址 |
.L4 + 8 |
case_1 的地址 |
.L4 + 16 |
case_2 的地址 |
| … | … |
.L4 + 48 |
case_6 的地址 |
- 如果
x = 2,计算.L4 + 16,取出里面的地址,跳转到case_2。 - 如果
x = 5,计算.L4 + 40,取出地址,跳转到case_5。
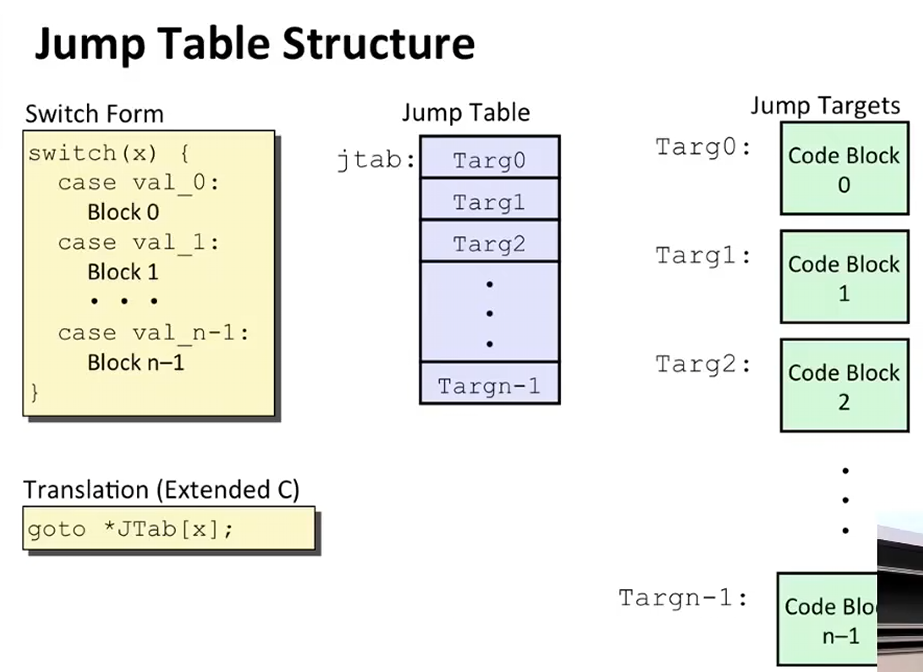
jumptbale 从物理空间(严格说是虚拟地址空间)上是绝对连续的。
你可以把这段 .quad 声明完全等同于 C 语言中的一个全局数组 void *JTab[7] ,数组元素在内存中就是一个挨一个紧密排列的。
对于case1:
switch(x){
	case 1:   #.L3
		w = y*z;
		break;
}
在汇编层面(dsdc89)
.L3:
	movq %rsi, %rax #y复制到rax,因为rax会作为被return的那个值
	imulq %rdx, %rax # %rax = %rax * %rdx就是 y*z
	ret