L04 Floating Point
对于二进制小数,小数点后第一位 权重为 2-1 第二位是2^-2 以此类推
小数在计算机内存中,没有小数点的概念。IEEE 754 浮点数标准,使用类似科学计数法的方式把32位浮点数(float)装满。
其中,具体的分配如下
[ 符号 S ] [   指数 E (8 bits)   ] [             尾数 M (23 bits)             ]
   1 bit         8 bits                         23 bits
这三个部分又是什么呢?
现在以小数 2.75为例 如果使用二进制表示就是 10.11[2]
回顾十进制内的科学计数法,假设现在有一个 20.75 用科学计数法表示就应该是 2.075 *10 ^ 1。因为是十进制 在这里10是底数,1是指数,代表小数点向前移动了多少位
那么同理,10.11[2] 用二进制中的科学计数法,就应该写作 1.011 * 2^1
符号位 (1 bit) 因为是正数,直接填入:0。
尾数位 (23 bits)
- 我们刚刚算出来的尾数部分是
011。 - 把这 3 个数填进 23 位的格子,剩下的位置全部补 0:
01100000000000000000000。
指数位 (8 bits)
- 我们算出来的指数是 $1$。
- 在 IEEE 754 标准中,为了同时能表示极小的数(负指数,比如 $\times 2^{-5}$),8 位的指数部分引入了一个偏移量 127(Bias) 。
- 这是为了把带有正负号的指数,整体平移映射到无符号数上,方便计算,比较
- 实际存入的指数 = $1 + 127 = 128$。
- 把 $128$ 换算成 8 位二进制就是:
10000000。
那么,在内存中,这个小数就被表示成了
0 10000000 01100000000000000000000
符号  指数    尾数
那么对于这样一个数,如果我直接丢在内存里面,CPU是怎么区分这到底是int还是float呢?这是由C语言编译器在编译的时候产生的汇编语言决定的。
我们可以写这样一段代码
#include <stdio.h>

int main() {
    float f = 2.75;

    // 把 f 的地址强转成整型指针,然后以整型(%d)的方式读出来
    int* p = (int*)&f;

    printf("当我们用整型指令去读它时,结果是:%d\n", *p);
    return 0;
}
运行这段代码,打印出来的不是2.75 而是 1076887552
除了float,还有一种更高精度的浮点数double 同样遵循IEEE 754标准,划分与此类似:
[ 符号 S ] [   指数 E (11 bits)   ] [             尾数 M (52 bits)             ]
   1 bit         11 bits                         52 bits
double的偏移量是 1023
那么,这就有了一个经典的问题:
0.1+0.2=0.3?吗在计算机里面其实是不等于的,0.1、0.2、0.3如果使用二进制表示是无限不循环小数。
我们人类用的是十进制(底数是 10,质因数有 2 和 5)。所以在十进制里,分母只含 2 和 5 的分数(比如 $\frac{1}{10} = 0.1$、$\frac{1}{5} = 0.2$)可以写得清清爽爽。
但计算机是二进制(底数是 2,质因数只有 2)。在二进制里,只有分母是 2 的幂次的分数才能被精确表达。而 $0.1$** **(****$\frac{1}{10}$** **)在二进制里,就像十进制里的** **$\frac{1}{3} = 0.33333…$ 一样,是一个无限循环小数:
- $0.1$ 的二进制:$0.00011001100110011…_2$(
0110无限循环)
说白了,就是十进制的 0.1 得用 无限二分来凑,但是永远凑不满。
-
a = 0.1
实际存入内存的值是:0.10000000149011611938...(由于截断,它比真正的 $0.1$ 稍微大了一点点) -
b = 0.2
实际存入内存的值是:0.20000000298023223877...(同理,比 $0.2$ 也大了一点点) -
c = 0.3
实际存入内存的值是:0.29999999105930328369...(由于舍入,它比真实的 $0.3$ 稍微小了一点点)
但是对于float类型来说,a+b 由于最后23位的取舍,导致a+b 在二进制上的表示和c一模一样,因此 0.1+0.2 != 0.3 仅发生在double类型上。
说白了,就是十进制的 0.1 换到二进制去 得用 无限二分来凑,但是永远凑不满。并且由于取舍+进位 导致了存在误差
例如,将int 16 转化为 float 16.0,是下面这些过程:
1. 16用二进制表示是 1 0000
2. 那么标准化 是 1.0000 * 2^4 指数是4,指数按照127偏置,得到131 就是128+2+1 尾数是 0000
3. 是正数 符号位是 0
0 10000011 0000...(补齐剩下2-4=19个0)
0.25如果表示成二进制,那么就是0.01[2]标准化之后 就是 1* 2^-2 指数是-2 127偏置之后就是 125 是正数 符号位是0
所以表示为
0 01111101 00000000000000000000000
之前提到过,对于指数位的偏置量是127,因此对于指数来说,最大值是:11111110 : 254 最小是 0000001 :1;随后再减去127,得到 实际上指数的区间是 [-126,127]。(在这里0和255被人为的保留下来了,被用于状态判断和容错,其中0用来表示0.0和非规格化数,255用来表示无穷大和非法)
那么问题来了,这套计数方案没办法再表示
$$1.000…00_2 \times 2^{-126}$$
比这个数更小的数,因此在这里IEEE 754引入了一套新的规则,当指数为全部是0时,进入非规格化数模式
规则一:把隐藏的 1 强行抠掉,换成 0
- 规格化数:$1.\text{尾数} \times 2^{\text{指数}}$
- 非规格化数:$\mathbf{0.\text{尾数}} \times 2^{\text{指数}}$
因为开头可以变成 0.xxx...,我们终于可以表示比之前极限还要小的数了!
例如,你可以表示 $0.00001_2 \times 2^{-126}$。随着尾数格子里的 `1` 不断右移,数值可以无限、平滑地逼近真正的 $0$。
规则二:强行锁死指数
如果按照正常公式,指数全为 0 时,实际指数应该是 $0 – 127 = -127$。
但在非规格化模式下,实际指数被强行锁死在 $-126$(即 $E = 1 – \text{Bias}$)。
为什么这么做?
为了让“非规格化数的最高点”和“规格化数的最低点”完美拼接:
- 规格化数能表示的最小数是:$1.0 \times 2^{-126}$
- 非规格化数能表示的最大数是:$0.111…11_2 \times 2^{-126} \approx 1.0 \times 2^{-126}$
两者的指数一样,实现了平滑过渡。
| 数值类型 | 指数位 (exp) | 尾数位 (frac) | 实际计算公式 | 十进制大小 | 角色 |
|---|---|---|---|---|---|
| 规格化数(极限) | 00000001 |
000...000 |
$1.0 \times 2^{-126}$ | $\approx 1.18 \times 10^{-38}$ | 悬崖的边缘 |
| 非规格化数(极大) | 00000000 |
111...111 |
$0.111…11_2 \times 2^{-126}$ | $\approx 1.179… \times 10^{-38}$ | 坡道的起点(贴合悬崖) |
| 非规格化数(极小) | 00000000 |
000...001 |
$0.000…01_2 \times 2^{-126}$(即$2^{-149}$) | $\approx 1.4 \times 10^{-45}$ | 距离绝对**$0$最近的一粒沙** |
| 真正的零 | 00000000 |
000...000 |
$0.0 \times 2^{-126}$ | $= 0.0$ | 平地的终点 |
这个例子通过构造了一个八位浮点数展示了如何从非格式化到格式化过度:
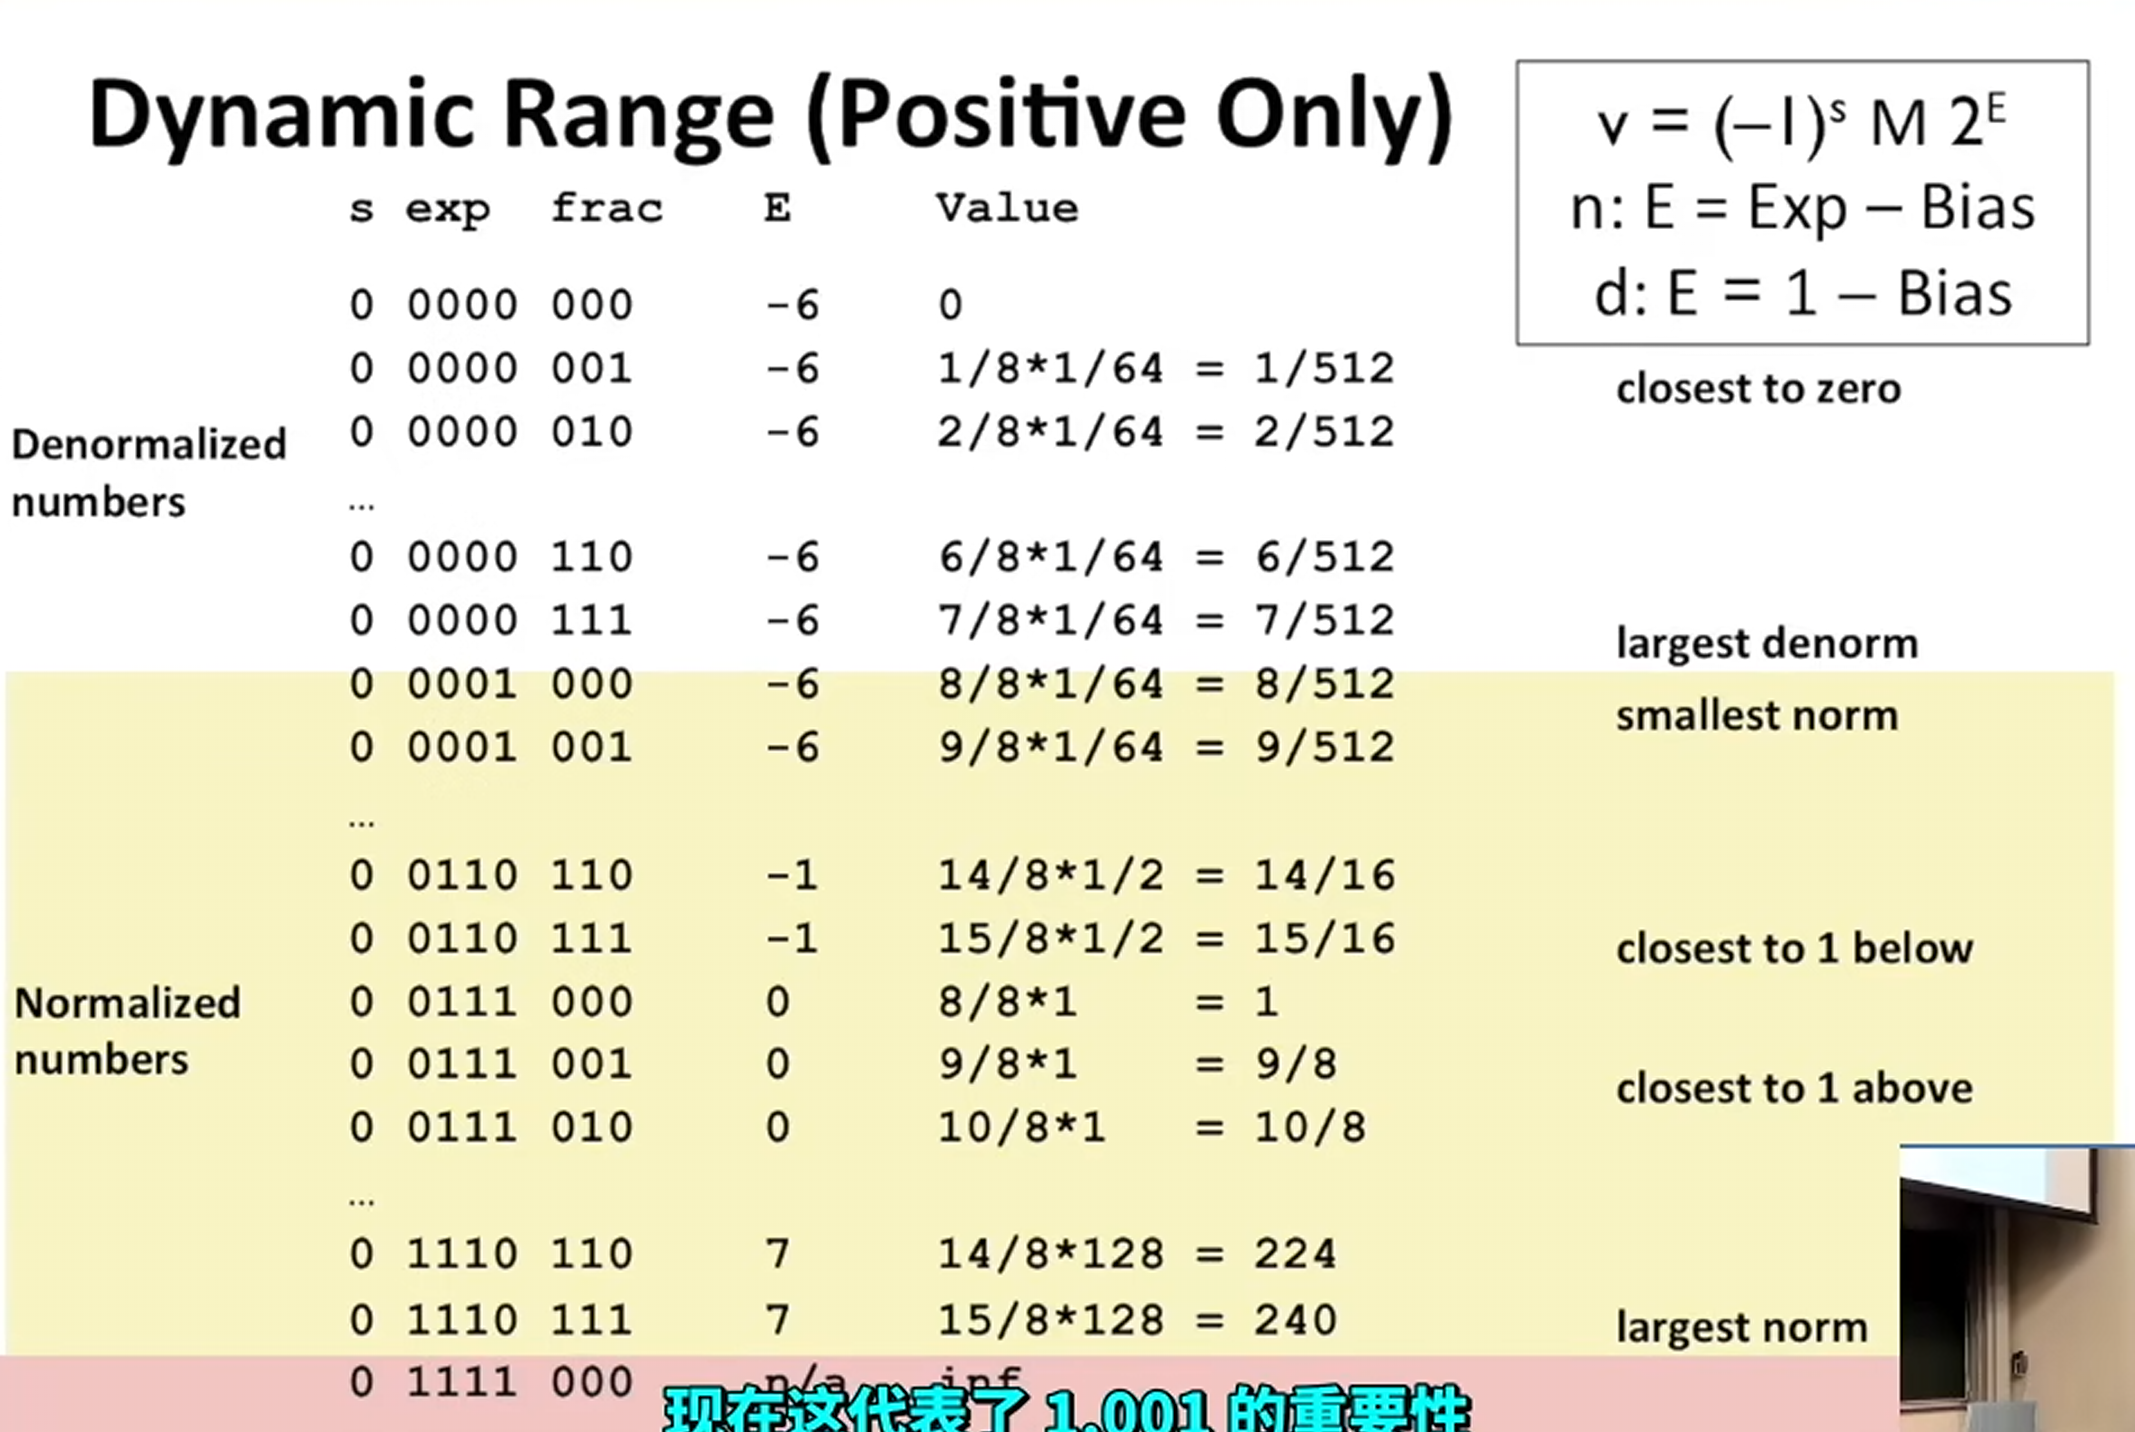
(对于bias,有这样一套计算公式 2^(k-1)-1 其中k是指数位位数。对于非格式化数 E始终是1-bias,对于格式化数,E是exp-bias)
对浮点数进行运算操作时,我们不能保证对其操作之后还能限制在原本的位数里面,需要进行舍位
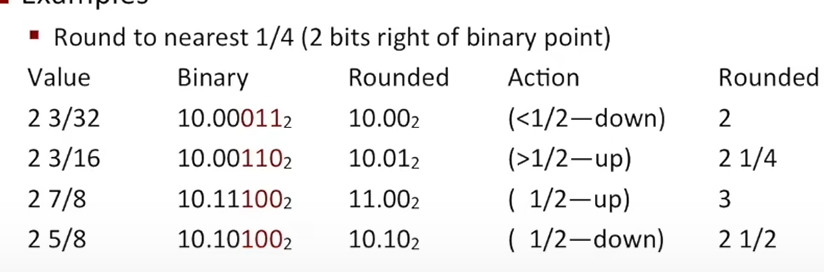
在二进制中,你只需要盯着被砍掉的红色第一位:
- 是
0:一定是< 1/2,直接舍。 - 是
1 且后面有非0数:一定是> 1/2,直接入。
在二进制的世界里,判断一个数是“奇”还是“偶”,只看它的最后一位:
- 如果最后一位是
0,它就是 “偶” (Even)。 - 如果最后一位是
1,它就是 “奇” (Odd)。
我们把目光死死盯着保留部分的最后一位(也就是紧邻红色尾巴左边的那一个数字):
1. 第三行:10.11 100
我们要保留小数点后两位,所以看绿色的这一位:$10.1\mathbf{\color{green}1}$
-
方案 A(退位) :直接扔掉尾巴,得到
10.11。- 看看最后一位是
1 吧?所以它在二进制舍入规则里被定义为 “奇” 。
- 看看最后一位是
-
方案 B(进位) :往绿色这一位加 1(即 $10.11 + 0.01$)。
- 二进制逢二进一:$1 + 1 = 10$,于是疯狂向前进位,最终得到
11.00。 - 看看保留部分的最后一位(小数点后第二位)变成了
0 吧?所以它被定义为 “偶” 。
- 二进制逢二进一:$1 + 1 = 10$,于是疯狂向前进位,最终得到
结论:为了向“偶”靠拢,计算机果断选择方案 B(进位),得到 11.00。
2. 第四行:10.10 100
同样,看保留部分的最后一位:$10.1\mathbf{\color{green}0}$
-
方案 A(退位) :直接扔掉尾巴,保持
10.10。- 看看最后一位已经是
0 了吧?所以它当前就是 “偶” 。
- 看看最后一位已经是
-
方案 B(进位) :往绿色这一位加 1(即 $10.10 + 0.01$),得到
10.11。- 看看最后一位变成了
1 吧?所以它变成了 “奇” 。
- 看看最后一位变成了
结论:为了向“偶”靠拢,计算机果断选择方案 A(退位),保持 10.10。
对于浮点数的乘法计算,假设现在有两个数相乘,一个是 (-1)s1 M1*2 E1另一个是 (-1)s2 M2*2E2
先假定结果位 (-1)s M*2 E
其中 符号位的运算结果是 s1与s2异或运算。尾数M=M1*M2。指数位E=E1+E2(这里只是例举逻辑,实际上应该再减去一个Bias)
初步乘出来的结果往往是不合法的,不能直接塞回 float 的 32 位格子(或者 double 的 64 位格子)里,所以必须经历以下三步“微调修正”:
修正一:重新标准化 (Normalization)
- 课件原文:
If M ≥ 2, shift M right, increment E - 原理:因为 $M_1$ 和 $M_2$ 原本都是规格化数,范围在 $[1.0, 2.0)$ 之间。那它们相乘之后的初步结果 $M$ 的范围就在 $[1.0, 4.0)$ 之间。
- 如果 $M \ge 2$(比如算出来是 $3.5$,即二进制的 $11.1_2$),它就不符合科学计数法“开头必须是 $1.xxxx$”的霸王条款了。
- 解法:把 $M$ 的小数点向左移一位(
shift M right),作为代价,指数 $E$ 必须加 1(increment E)。
修正二:检查溢出 (Overflow)
- 课件原文:
If E out of range, overflow - 原理:如果刚才指数加 1 之后,或者原本
E1 + E2 算出来的指数太大了,超过了格子能容纳的最大极限(比如float实际指数超过了 $127$)。 - 解法:硬件判定为上溢(Overflow) ,直接把这个数字打入冷宫,判定为我们上一个问题聊到的“无穷大 ($\infty$)”状态。
修正三:舍入剪裁 (Rounding)
-
课件原文:
Round M to fit frac precision -
原理:两个 23 位的尾数相乘,算出来的完整结果会有多达 46 位!但是
float 的尾数格子(frac)只给留了 23 个车位。 -
怎么乘的呢?底层原理和我们小学列竖式做乘法一模一样!只是计算机更简单,它只需要处理
0 和1。我们先来看人类是怎么列竖式的,然后再看芯片(硬件电路)是怎么把这个竖式塞进晶体管里的。
1. 模拟人类的“列竖式”
假设我们要计算两个 4 位尾数的乘法(为了方便演示,我们把 23 位简化为 4 位):
1101$\times$1011。你脑海里的竖式一定是这样的:
      1 1 0 1   (被乘数)
   ×  1 0 1 1   (乘数)
   -----------
      1 1 0 1   ← 乘数最后一位是1,直接抄写被乘数
    1 1 0 1     ← 乘数倒数第二位是1,左移一位抄写
  0 0 0 0       ← 乘数倒数第三位是0,全是0
+ 1 1 0 1       ← 乘数第一位是1,左移三位抄写
-----------
1 0 0 0 1 1 1 1  (最终结果:4位×4位变成8位)
发现二进制竖式的绝妙之处了吗?
由于乘数的每一位要么是1,要么是0,这意味着计算机在列竖式时根本不需要做乘法口诀表:- 如果乘数当前位是
1,就把被乘数挪个位置(左移)直接加下来。 - 如果乘数当前位是
0,就什么都不加(或者加全 0)。
2. 芯片在底层是怎么“列竖式”的?
虽然逻辑是列竖式,但 CPU 芯片可没有纸和笔去画这个表格,它必须在极短的时间(通常是几个时钟周期内)把这 46 位的庞大结果算出来。硬件里主要有两种实现“竖式”的物理方案:
方案 A:时间换空间(阵列乘法器 / 移位加法)
如果芯片面积很小(比如一些低端的微控制器/单片机 MCU),它会用一个循环电路:
- 准备一个 46 位的“大寄存器”,初始填
0。 - 盯着乘数的最后一位。如果是
1,就让加法器把被乘数加进这个大寄存器里。 - 把被乘数向左移一位(相当于竖式里串行往左写一列),同时把乘数向右移一位(去看下一位)。
- 重复这个过程 23 次。
这种方式就像一个木匠,一个人纯手工把竖式的每一行一行行加起来,需要走 23 步。
方案 B:空间换时间(华莱士树乘法器 Wallace Tree)—— 现代 CPU 的做法
对于现代高性能 CPU(如 Intel、AMD 或是 ARM 处理器),为了让浮点数乘法飞快,科学家用晶体管在芯片上直接堆出一张“巨大的物理竖式网”。
- 硬件里直接连出 23 排线路,把所有可能需要相加的“竖式行”同时生成出来(在电路里叫部分积)。
- 接下来,芯片使用一种叫华莱士树(Wallace Tree) 的树状加法器网络。它并不是像我们算账一样从上往下一行行死算,而是成批成批地分组压榨:
- 第一轮:把 23 行拆成若干个“3行一组”,用特殊的电路(全加器)把每 3 行同时压缩成 2 行。
- 第二轮:把剩下的行继续“3压2”。
- 这个过程是完全并发的,23 行数据在电信号流过这片晶体管森林的瞬间,就像漏斗一样被快速压缩。
最后,原本 23 行的庞大竖式,只需要经过几次“电闪雷鸣”的并行压缩,就会瞬间变成最后的 46 位完整结果。
3. 算完 46 位后,怎么放回 23 位的车位?
当华莱士树喷出这 46 位的完整结果后,就轮到我们前两步学到的知识点登场了:
- 先看小数点: 因为规格化数是 $1.xxx \dots \times 1.xxx \dots$,两个 $1.xxxx$ 相乘,结果一定是 $1.xxxx$ 或者 $11.xxxx$。如果是后者(大于等于 2),就把 46 位整体右移一位,指数加 1。
- 执行刀刑(舍入) :保留前 23 位作为合法的
frac车位,第 24 位以及后面的所有小尾巴就变成了“红色的被裁剪区”。 - 拿着这个小尾巴,跟 $1/2$(也就是尾巴第一位是不是 1)去比对,触发“向偶数舍入”逻辑,决定是直接砍掉,还是给第 23 位车位上的数字
+1。
这就是浮点数乘法的终极全貌——硬件用漫山遍野的门电路列出了一个 23 层的超级竖式,算出 46 位结果后,再用舍入剃刀精准地把它削回 23 位塞进内存。
- 如果乘数当前位是
-
解法:后面多出来的那些尾巴,必须通过我们刚刚学的 “向偶数舍入(Round to Nearest Even)” 规则(就是那个跟 $1/2$ 比较、看奇偶决定进退位的规则)进行无情裁剪,把屁股后面的尾巴削掉,只保留合法的精度。